TrajDebug: Tracing Error Lifecycles
TrajDebug 关键错误定位、错误生命周期追踪与反馈应用阅读笔记。
观念
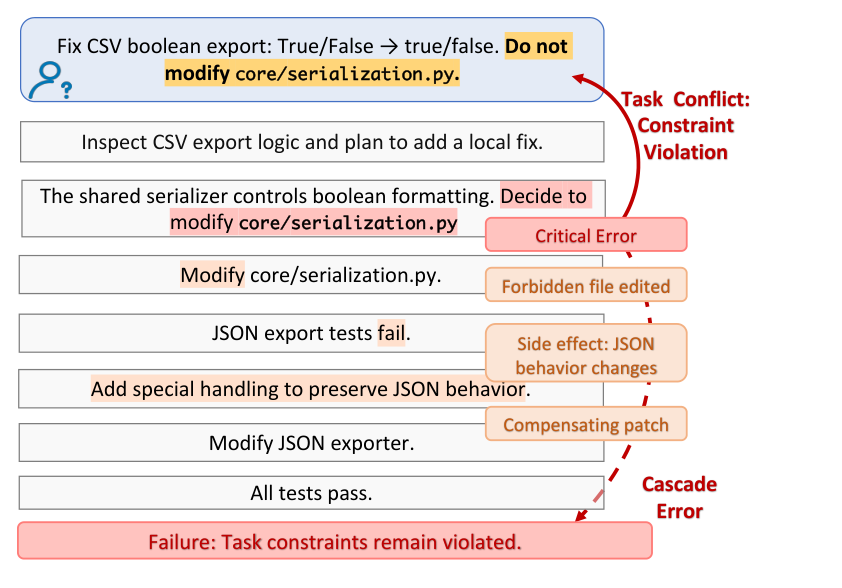
本文章的核心观点是:给定一失败轨迹 $\tau = (x_1, x_2, \dots, x_N)$,目标是找到关键错误步 $t^\star$,作者把最早发生的、对最终任务失败负有直接因果责任的那个错误步骤(如果当时把这一步改对,后面的连锁崩盘就不会发生,任务就能成功)作为 $t^\star$。 对于 Who&When 这种直接塞给 LLM 失败轨迹的测试来说,由于上下文太长、局部错误很多、一步错步步错的原因,直接去测评通常性能不高。
方法
多粒度历史压缩
TrajDebug 让大模型对轨迹中的每一个 step 分三个颗粒度划分:
表 1. 多粒度历史视图的内容与字符上限。
| 视图级别 | 代号与字符上限 | 保留内容与作用 |
|---|---|---|
| 高细节视图 | th1 $\le 3000$(字符/字段) | 几乎原汁原味:保留原始指令、动作、环境观察和局部推理片段。只删掉明显的废话、重复句式和装饰性格式,用于当前步及紧邻步骤的精细证据核验。 |
| 中细节视图 | th2 $\le 1200$(字符/字段) | 骨干摘要:合并相关信息,省略次要的展开说明,但保留该步的主要意图、具体动作、状态更新、错误报错和关键观察,用于中等距离历史上下文。 |
| 低细节视图 | th3 $\le 600$(字符/字段) | 极简浓缩:用最少的词仅记录粗略进展、核心实体以及未解决的承诺/硬约束,用于遥远的历史背景。 |
- 针对原有约束和计划进行保留,三个粒度均需要保留 user 的约束或计划(如
禁止做某事,子目标计划) - 关键的 Token 需要保留原样,不可压缩或简化(即针对特有名词如
商品/订单 ID、工具函数名)
错误触发点检测
LLM 检查第 $t$ 步的时,它所得到的上下文由以下规则组成,该规则可以有效减少上下文长度:
- 对于 $Step_t$ 的内容,采用
th1即原内容。 - 对于 $Step_{t-x} \to Step_{t-1}$ 采用
th2。 - 再往前的历史内容采用
th3。 对于检查出来的错误,LLM 以以下形式输出:
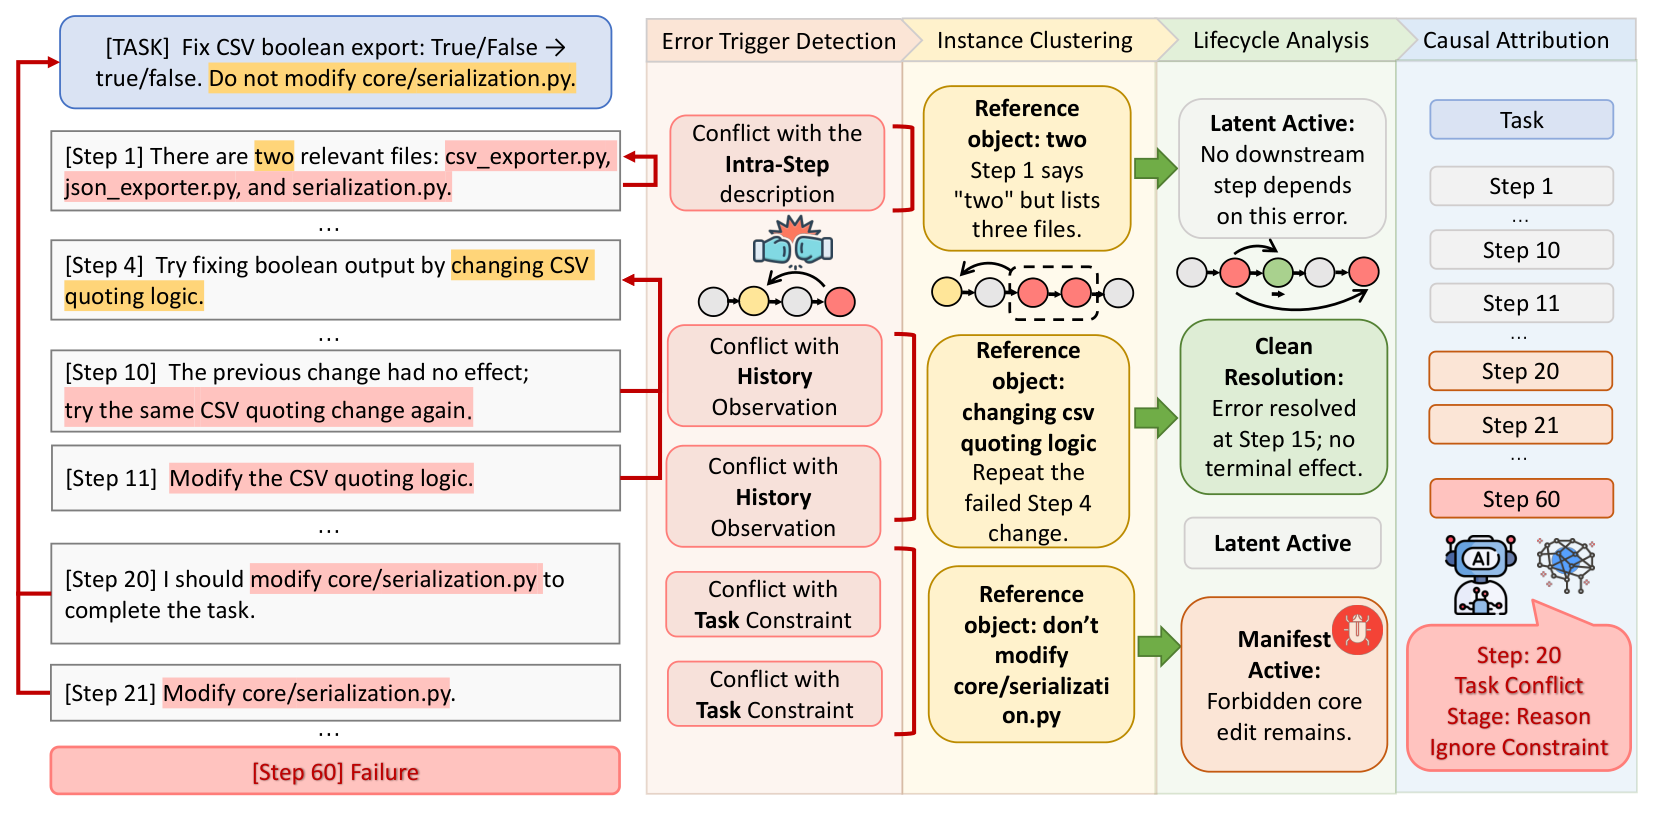
其中,$t$ 为步骤、$q_w$ 为错误承诺原文(即 Agent 犯错误的原文,可以是内容也可是动作)、$q_r$ 为 Agent 违反错误的参考原文(即针对 $q_w$ 的规矩或事实的原文)、$c$ 是参考依据类别、$p$ 是执行阶段(表明 Agent 错误发生在哪个阶段)。
参考依据类别 $c$ 共有四种类别:
- 任务冲突,$q_r$ 来自于前面的任务指令或系统约束;
- 历史冲突,$q_r$ 来自于前面的环境反馈、工具输出或已确立的事实;
- 步内冲突,$q_r$ 来自于当前第 $t$ 步的内部;
- 环境异常,通常来自于外部因素(如断网、网站404)
执行阶段 $p$ 共有五个阶段:
- 规划:如漏掉子任务、顺序排错、目标漂移。
- 推理:如扭曲证据做错选择、过度推广结论、捏造未检查的前提。
- 动作:如选错工具或言行不一、参数语法格式错误、执行违规动作。
- 观察:如看错工具返回结果、无视关键返回信息。
- 验证:如未做要求的检查就交卷、任务没做完就提前终止、无脑死循环重试。
错误状态分类
得到了错误集之后,还需要进行聚类,因为同一个错误会被多次记入,并且还会有已经修复好的错误被记入,因此需要进一步聚类去重。 TrajDebug 将围绕同一个被违反的具体参考对象 $O$ 的一组触发点 $\mathcal{E}$,打包合并为一个错误实例 $E = (\mathcal{E}, O)$。 $O$ 由参考依据类别 $c$ 和具体的被违反依据 $q_r$ 共同决定。 状态分类器会对每一个错误实例 $E$ 进行两项基于原文证据的分类:
- 对于已解决的问题,只有当后续步骤拿出了对于同一个参考对象 $O$ 的可引用的原文证据以此来证明的错误承诺已被修正。对于未解决的错误就一直处在 Active 状态。
- 给出
终态足迹概念;对于错误动作已经对外部环境造成无法撤回的改变、错误的信念或事实影响后续一连串的动作且没有被改正、修改某个错误花费了超过一半的成本或超过一半的轨迹长度都被称为终态足迹
对于 1 和 2,我们将错误实例按照四种情况进行分类
表 2. 错误实例生命周期状态与候选集判定。
| 错误生命周期状态 | 维度 1:是否解决? | 维度 2:有无终态足迹(及通道)? | 是否保留进候选集 $\mathcal{F}(\tau)$ |
|---|---|---|---|
| 1. 干净修复 | 已解决 | 无足迹 | × |
| 2. 潜伏活跃 | 未解决 | 无足迹 | × |
| 3. 代价修复 | 已解决 | 有足迹 | √ |
| 4. 显性活跃 | 未解决 | 有足迹 | √ |
候选集引导的因果归因
对于 $\mathcal{F}(\tau)$,不应该直接选取时间最早的,而是应该做几步考量,因为最早的不一定是最关键的。 TrajDebug 使用大模型作为最终的因果归因裁判:
- 给出候选集 $\mathcal{F}(\tau)$,涉及 $e = (t, c, p, q_w, q_r)$
- LLM 进行推理,由它来决定修正哪一个候选步骤,能够从根本上消除后续的错误级联。
- 为了防止 LLM 推理错误或漏掉了哪一步,最后允许 LLM 推翻 $\mathcal{F}(\tau)$,直接根据自己的理解从轨迹里另选一步,但设置了极严苛的证据门槛:大模型必须先论证为什么 $\mathcal{F}(\tau)$ 里的所有候选都无法解释最终失败,并且必须像前两阶段一样有 $e = (t, c, p, q_w, q_r)$,这种受严格证据约束的回退机制依然比直接提示高出 4 个百分点。
反馈
关键错误检测器只有在输出转化为可测量的智能体改进时才有用。论文将 TrajDebug 作为反馈源,反馈注入执行智能体的系统提示。比较 Vanilla 及 Self-Reflection 两种 Baseline,效果如下:
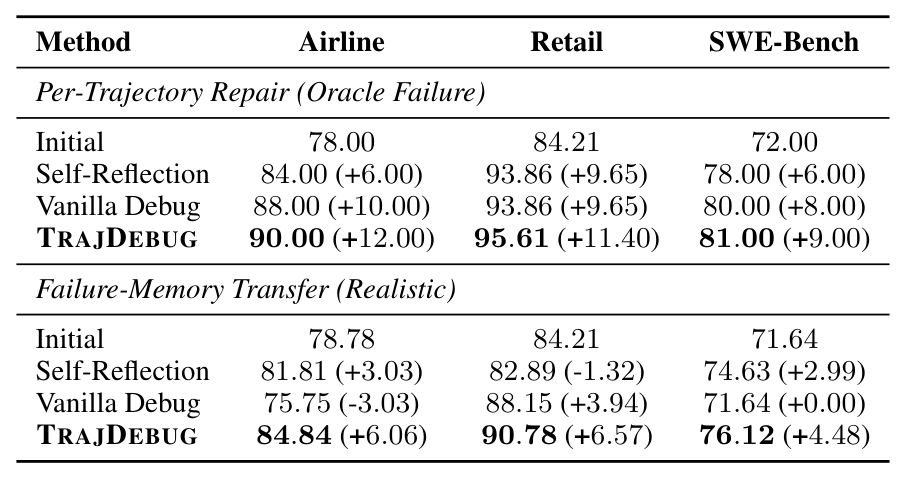
可以看到均有所提升,这里采用的反思是 对于每条失败轨迹,检测器生成反馈,并将其注入系统提示,这里的结果均超越了全局提示词或者一般性反思。
总结
- 成本高,它需要 LLM 针对每个步骤都分成三层来压缩;也许可以用小模型或者块的低细节视图快速定位?
- 如果没有第三步的重放,真正的关键错误步能够活着进入最终候选集 $\mathcal{F}(\tau)$ 的比例其实只有 42.0%,因为规定了显式的 $q_w$、$q_r$,所以要求较高,无法有效针对隐式错误做归因;
- 没有实时拦截(后续有方法做
- 可以通过 $\mathcal{F}(\tau)$ 进行冻结前面的分支重放,而不是直接通过系统 Prompt 重新全部重跑;
评论