PPO to GRPO
从 Policy Gradient 到 GAE、重要性采样与 PPO-Clip、GRPO 的完整推导笔记
PPO 算法
首先定义一些概念,作为我们第一步的知识理解:
- Action:可选择的动作,即模型下一步进行的动作集
- Policy:策略函数,输入 state,输出 action 的概率分布,一般用 $\pi$ 表示,如 $\pi(action1|S_t)=0.78\dots$
- Trajectory:轨迹,用 $\tau$ 表示,是一连串的 state 和 action,$S_{t+1}=f(S_t,a_t)$ 确定,或者 $S_{t+1}=f(*|S_t,a_t)$ 随机
- Return:回报,从当前时间到结束的 reward 累计和
期望:
$$E(x)_{x \sim p(x)} = \sum_{x} x * p(x) \approx \frac{1}{n} \sum_{i=1}^{n} x_i \quad (x_i \sim p(x))$$目标 1:训练一个 Policy 神经网络 $\pi$,在所有状态 $S$ 下,给出相应的 Action,得到 Return 的期望最大。 目标 2:训练一个 Policy 神经网络 $\pi$,在所有的 Trajectory 中,得到 Return 的期望最大。
Policy Gradient
$R(\tau)$ 为轨迹 $\tau$ 获得的总回报,在当前策略下,所有可能轨迹的回报期望:
$$E(R(\tau))_{\tau \sim P_\theta(\tau)} = \sum_{\tau} R(\tau)P_\theta(\tau)$$$$\nabla E(R(\tau))_{\tau \sim P_\theta(\tau)} = \nabla \sum_{\tau} R(\tau)P_\theta(\tau)$$$$= \sum_{\tau} R(\tau)\nabla P_\theta(\tau)$$$$= \sum_{\tau} R(\tau)\nabla P_\theta(\tau)\frac{P_\theta(\tau)}{P_\theta(\tau)}$$$$= {\color{#4285F4}{\sum_{\tau} P_\theta(\tau)} R(\tau)}\frac{\nabla P_\theta(\tau)}{P_\theta(\tau)}$$$$\approx \frac{1}{N} \sum_{n=1}^N R(\tau^n) \frac{\nabla P_\theta(\tau^n)}{P_\theta(\tau^n)}$$$$= \frac{1}{N} \sum_{n=1}^N R(\tau^n)\nabla \log P_\theta(\tau^n)$$其中最后一步使用了 $\nabla \log f(x) = \frac{\nabla f(x)}{f(x)}$。
一个状态是完全由当前状态和当前动作决定的,那么一个 Trajectory 的概率就是在该 Trajectory 下的所有 state 和该 state 下所有 action 的连乘,即:
$$= \frac{1}{N} \sum_{n=1}^N R(\tau^n)\nabla \log \prod_{t=1}^{T_n} P_\theta(a_n^t|s_n^t)$$$$= \frac{1}{N} \sum_{n=1}^N R(\tau^n) \sum_{t=1}^{T_n} \nabla \log P_\theta(a_n^t|s_n^t)$$$$= \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} R(\tau^n)\nabla \log P_\theta(a_n^t|s_n^t)$$此时去掉求导符号,进行梯度下降为:$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} R(\tau^n)\log P_\theta(a_n^t|s_n^t)$,之后我们进行梯度更新,定义的 loss 为:
$$\text{Loss} = -\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} \color{#4285F4}{R(\tau^n)} \log \color{#EA4335}{P_\theta(a_n^t|s_n^t)}$$因此我们需要采集每个 Trajectory 造成的 $R(\tau^n)$,采集数据非常慢,且占用显存和内存较大,且存在问题。
$$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} {\color{#4285F4}R(\tau^n)}\nabla \log P_\theta(a_n^t|s_n^t)$$问题在于:$R(\tau^n)$ 是整局游戏的总得分。但实际上,在时刻 $t$ 采取的动作 $a_t$,不可能影响时刻 $t$ 之前发生的事情。用总得分去评估当前的动作是不合理的。
$$R(\tau^n) \rightarrow \sum_{t'=t}^{T_n} \gamma^{t'-t} r_{t'}^n = \color{#4285F4}{R_t^n}$$我们将总回报替换为从当前时刻 $t$ 开始,到游戏结束时的未来累积回报 $R_t^n$。这里通常还会引入一个折扣因子 $\gamma$(Gamma,取值在 0 到 1 之间),表示越久远的奖励,其参考价值越低。$r_{t'}^n$ 表示具体某一步的即时奖励。更新后为:
$$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} \color{#4285F4}{R_t^n} \nabla \log P_\theta(a_n^t|s_n^t)$$接着依然存在一个问题:如果某个环境的奖励永远都是正数,或者永远都是负数怎么办?如果全是坏的,这样导致模型永远会往下更新,因此我们最好是引入一个 baseline,根据 baseline 来评估每种 action 的好坏
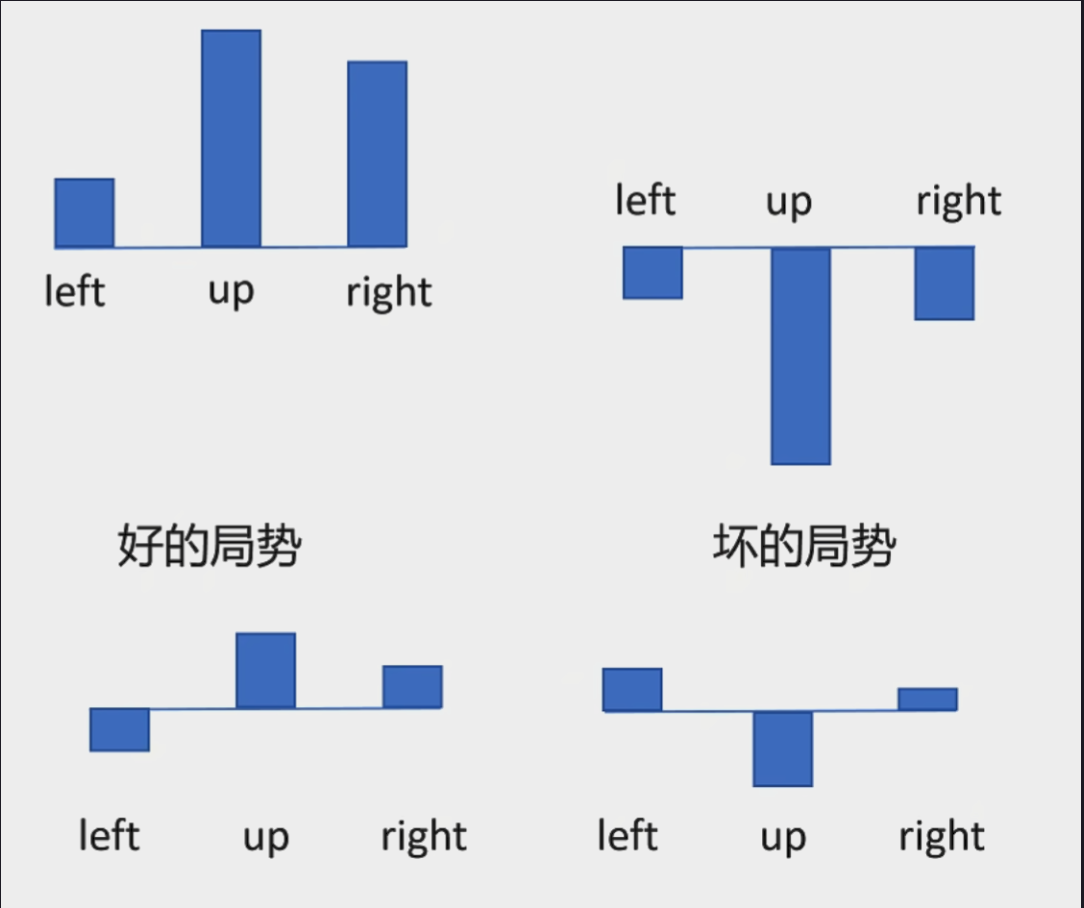
基于上述的 baseline,我们有以下优化公式:
$$=\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} (R_t^n - B(s_n^t)) \nabla \log P_\theta(a_n^t|s_n^t)$$$B(s_n^t)$:Baseline。它通常是当前状态 $s_n^t$ 的平均期望得分(在实际应用中,通常会训练另一个神经网络——价值网络 Critic,来预测这个状态的价值 $V(s)$ 作为基线)。
$(R_t^n - B(s_n^t))$:这个差值被称为优势函数(Advantage Function, 通常记为 $A_t$)。它衡量的是:“当前采取的这个动作,比我在这个状态下瞎闭着眼睛随便选(平均水平),到底好多少或坏多少?”
优势函数
首先对于根据我们的基准公式:
$$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} (R_t^n - B(s_n^t)) \nabla \log P_\theta(a_n^t|s_n^t)$$接下来再次给出一些定义:
- Action-Value Function(动作价值函数 / $Q$ 函数):$R_t^n$ 每次都是一次随机采样,方差很大,训练不稳定,$Q_\theta(s, a)$ 在 state s 下,做出 action a,期望的回报。
- State-Value Function(状态价值函数 / $V$ 函数):$V_\theta(s)$ 在 state s 下,期望的回报。
- Advantage Function(优势函数 / $A$ 函数):$A_\theta(s, a) = Q_\theta(s, a) - V_\theta(s)$,在 state s 下,做出 Action a,比其他动作能带来多少优势。
所以,我们可以将原式用数学期望 $A_\theta(s, a)$ 替换了原本基于随机采样的 $(R_t^n - B(s_n^t))$,公式变为:
$$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_\theta(s_n^t, a_n^t) \nabla \log P_\theta(a_n^t|s_n^t)$$我们在计算优势函数时,可以计算出向前 k 步的真实奖励:
- 第一步估计:$A_\theta^1(s_t, a) = r_t + \gamma * V_\theta(s_{t+1}) - V_\theta(s_t)$
- 第二步估计:$A_\theta^2(s_t, a) = r_t + \gamma * r_{t+1} + \gamma^2 * V_\theta(s_{t+2}) - V_\theta(s_t)$
- 第三步估计:$A_\theta^3(s_t, a) = r_t + \gamma * r_{t+1} + \gamma^2 * r_{t+2} + \gamma^3 V_\theta(s_{t+3}) - V_\theta(s_t)$
- 第 $T$ 步估计:$A_\theta^T(s_t, a) = r_t + \gamma * r_{t+1} + \gamma^2 * r_{t+2} + \gamma^3 * r_{t+3} + \dots + \gamma^T * r_T - V_\theta(s_t)$
我们引入 $\delta_t^V = r_t + \gamma * V_\theta(s_{t+1}) - V_\theta(s_t)$,此时优势函数重写为:
$$A_\theta^1(s_t, a) = \delta_t^V$$$$A_\theta^2(s_t, a) = \delta_t^V + \gamma \delta_{t+1}^V$$$$A_\theta^3(s_t, a) = \delta_t^V + \gamma \delta_{t+1}^V + \gamma^2 \delta_{t+2}^V$$$$\vdots$$那么我们要往前看多少步来更新参数呢?如果看的较少,那么偏差较大;如果看的较多,那么方差较大;GAE 提出往后看所有步数,然后取加权平均,具体公式如下:
$$A_\theta^{GAE}(s_t, a) = (1 - \lambda)(A_\theta^1 + \lambda * A_\theta^2 + \lambda^2 * A_\theta^3 + \dots)$$其中 $(1 - \lambda)$ 是一个归一化系数。因为无穷等比数列 $1 + \lambda + \lambda^2 + \dots = \frac{1}{1-\lambda}$,在前面乘以 $(1-\lambda)$,可以确保所有权重的总和正好等于 1。我们继续化简,把刚才的 $\delta$ 展开式代入 $A^1, A^2 \dots$
$$= (1 - \lambda)(\delta_t^V + \lambda * (\delta_t^V + \gamma \delta_{t+1}^V) + \lambda^2 (\delta_t^V + \gamma \delta_{t+1}^V + \gamma^2 \delta_{t+2}^V) + \dots)$$$$= (1 - \lambda) \big( \delta_t^V(1 + \lambda + \lambda^2 + \dots) + \gamma \delta_{t+1}^V * (\lambda + \lambda^2 + \dots) + \dots \big)$$我们知道 $1+\lambda+\lambda^2+\dots = \frac{1}{1-\lambda}$,提取公因式 $\lambda$ 后 $\lambda+\lambda^2+\dots = \frac{\lambda}{1-\lambda}$。代入进去:
$$= (1 - \lambda) \left( \delta_t^V \frac{1}{1-\lambda} + \gamma \delta_{t+1}^V \frac{\lambda}{1-\lambda} + \dots \right)$$最后得到:
$$A^{GAE}(s_t, a) = \sum_{b=0}^{\infty} (\gamma \lambda)^b \delta_{t+b}^V$$Off Policy 和重要性采样
由于每次更新都是 On Policy,即每次都要重新收集之后的奖励再去训练,非常慢,我们可以运行参考模型来采集数据,然后根据该采集数据进行多次训练。
重要性采样是一种数学技巧,允许我们用来自分布 $q(x)$ 的样本,去估计分布 $p(x)$ 下的期望:
$$\mathbb{E}(f(x))_{x \sim p(x)} = \sum_x f(x) * p(x)$$$$= \sum_x f(x) * p(x) \frac{q(x)}{q(x)}$$$$= \sum_x f(x) \frac{p(x)}{q(x)} * q(x)$$$$= \mathbb{E} \left( f(x)\frac{p(x)}{q(x)} \right)_{x \sim q(x)}$$$$\approx \frac{1}{N} \sum_{n=1}^N f(x)\frac{p(x)}{q(x)} \quad (x \sim q(x))$$$\theta$:当前正在训练更新的新策略网络参数。$\theta'$:过去用来和环境交互、实际收集数据的旧策略网络参数。
假设用新策略 $\theta$ 采样,此时梯度更新公式为:
$$\frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_\theta^{GAE}(s_n^t, a_n^t) \nabla \log P_\theta(a_n^t|s_n^t)$$此时换成旧策略,或者参考策略 $\theta'$:
$$= \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)} \nabla \log P_\theta(a_n^t|s_n^t)$$$$= \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)} \color{#4285F4}{\frac{\nabla P_\theta(a_n^t|s_n^t)}{P_\theta(a_n^t|s_n^t)}}$$$$= \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{\nabla P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)}$$$$\text{Loss} = - \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)}$$PPO 策略
之前我们通过重要性采样得到了可以复用旧数据的目标函数,但它有一个致命缺陷:如果新策略 $\theta$ 和旧策略 $\theta'$ 差距过大,重要性权重 $\frac{P_\theta}{P_{\theta'}}$ 会爆炸,导致模型直接崩溃。为了解决这个问题,PPO 提出了限制策略更新幅度的两种方法。
TRPO 算法:
$$Loss_{ppo} = - \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)} + \beta KL(P_\theta, P_{\theta'})$$- $KL(P_\theta, P_{\theta'})$:KL 散度。它是一个衡量两个概率分布差异大小的数学工具。在这里,它用来衡量新策略网络和旧策略网络输出的动作概率分布差了多少。
- $\beta$:惩罚系数。
截断目标函数(PPO-Clip):
为了方便看,我们把重要性比率简写为 $r_t(\theta) = \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)}$,那么公式为:
$$Loss_{ppo2} = - \frac{1}{N} \sum_{n=1}^N \sum_{t=1}^{T_n} \min \left( \color{#EA4335}{A_{\theta'}^{GAE}(s_n^t, a_n^t) \frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)}}, \color{#4285F4}{\text{clip}\left(\frac{P_\theta(a_n^t|s_n^t)}{P_{\theta'}(a_n^t|s_n^t)}, 1-\varepsilon, 1+\varepsilon\right) A_{\theta'}^{GAE}(s_n^t, a_n^t)} \right)$$- $\varepsilon$:截断超参数,通常设为 0.2。这意味着我们允许新策略的概率最多只能是旧策略的 $1.2$ 倍或 $0.8$ 倍。
- $\text{clip}(r_t(\theta), 1-\varepsilon, 1+\varepsilon)$:截断函数。如果比率 $r_t(\theta)$ 大于 $1+\varepsilon$,就强行把它按在 $1+\varepsilon$;如果小于 $1-\varepsilon$,就强行托在 $1-\varepsilon$。
clip 目前是业界主流的用法,同时,它实现也为简单,min 函数在这里是为了让模型进行保守更新,使得模型更新更加稳健。
GRPO
至此,PPO 已经形成了从奖励到策略更新的完整路径:借助价值模型构造优势,再优化裁剪目标。GRPO 改变的重点是优势的来源。对于同一道题,如果已经生成了多个回答,就可以用它们的奖励建立局部比较,而不必额外预测一个状态价值。
本节采用回答结束后评分的结果奖励设置。对于问题 $q$,用 $\pi_{\mathrm{old}}$ 采样 $G\geq2$ 个回答 $o_1,\ldots,o_G$,再得到对应奖励 $r_1,\ldots,r_G$。这里的 $G$ 是每组回答数量,与前面的回报 $G_t$ 不同;$r_i$ 是整条回答的评分,也需要与逐步奖励 $r_t$ 区分。
第一步,计算组内平均奖励,再从每个回答的奖励中减去它。这样,比较依据就变成了这道题已经采样到的回答:
$$ \bar r=\frac1G\sum_{j=1}^G r_j, \qquad \text{centered reward}_i=r_i-\bar r. $$第二步,用组内奖励的标准差对这些差值做尺度调整。本节采用的原始 GRPO 形式为:
$$ \sigma_r=\sqrt{\frac1G\sum_{j=1}^G(r_j-\bar r)^2}, \qquad \hat A_i=\frac{r_i-\bar r}{\sigma_r+\varepsilon_{\mathrm{num}}}. $$GRPO 同样使用 PPO 中当前策略与旧策略的比较。对于回答 $o_i$ 的第 $t$ 个 token,状态由问题 $q$ 和此前的前缀 $o_{i, 对于一个固定前缀 $s$,这里关注的一种 KL 方向为: 现在可以从一个 token 的贡献开始,逐步拼出完整目标。奖励部分沿用 PPO 的裁剪比率,但把优势换成该回答的组内相对优势 $\hat A_i$,然后减去参考策略惩罚: 原始 GRPO 的平均方式,是先对每条回答内部的 token 求平均,再对组内回答求平均。问题 $q$ 从训练问题分布 $\mathcal D$ 中采样,记 $|o_i|$ 为第 $i$ 条回答生成的 token 数: 下表给出了常见模型配置下的示意对比
策略 用途 何时改变 $\pi_\theta$ 给出正在优化的动作概率。 随优化步骤更新。 $\pi_{\mathrm{old}}$ 生成当前批次,并提供重要性比的分母。 本批更新时固定,后续采样时刷新。 $\pi_{\mathrm{ref}}$ 提供 KL 惩罚的比较分布。 通常在整个训练过程中固定。 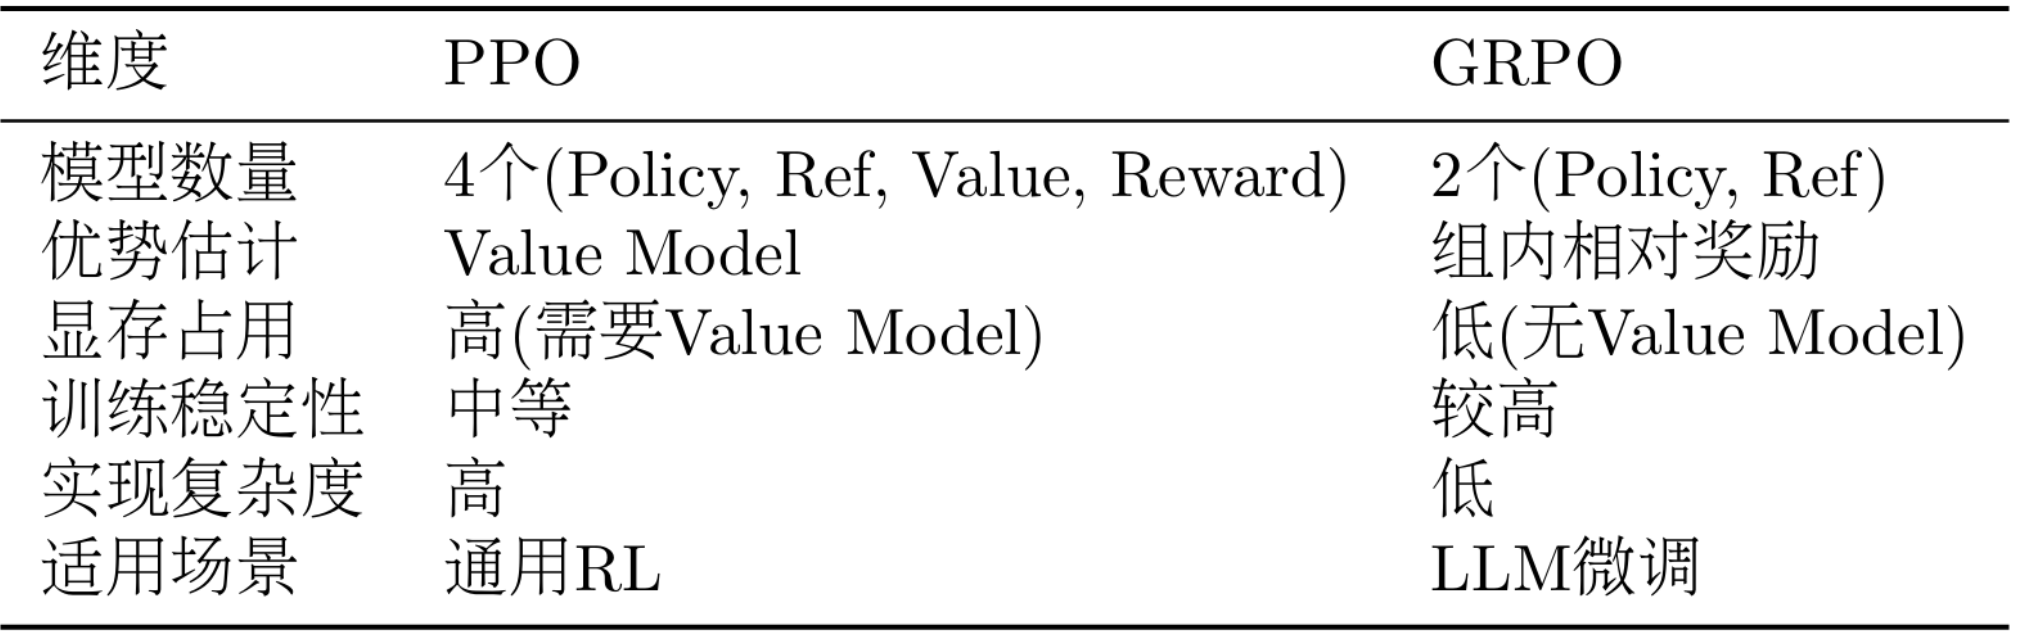
评论