笔记:Retrieval-Augmented Generation
针对于 Retrieval-Augmented Generation 论文做出的笔记以及思索
Overview
论文链接:Retrieval-Augmented Generation
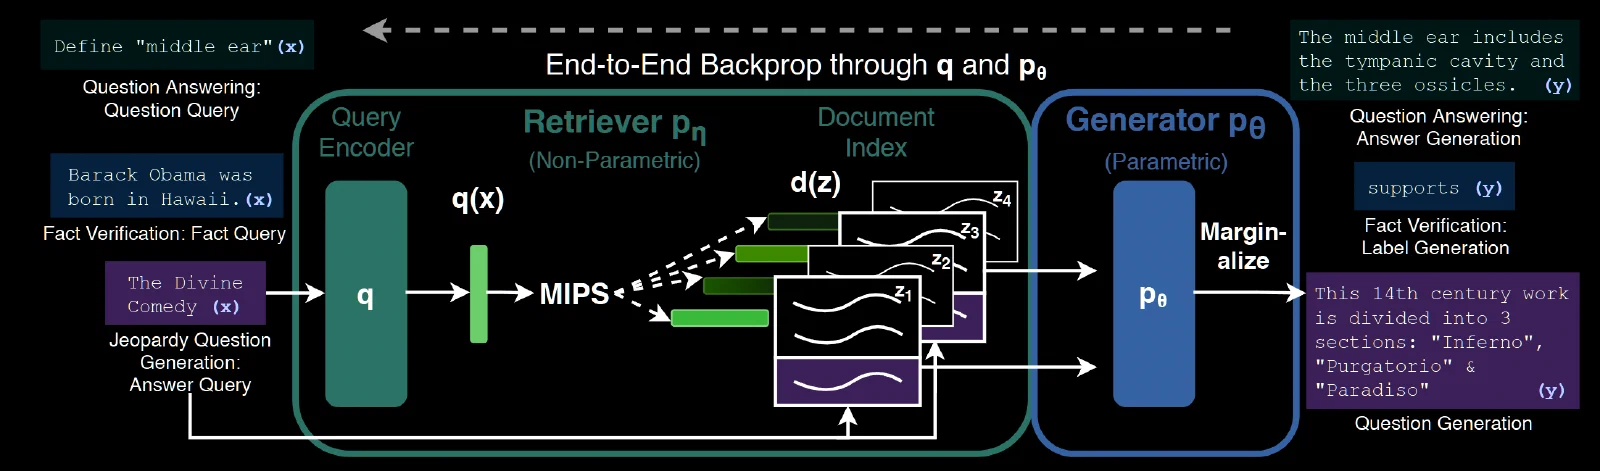
总体过程是对于一个特定性的问题,通过 MIPS 方法进行知识库检索,找到相关文件,然后“传给”大模型,大模型来结合该知识然后做出最终的回答。 问题:MIPS 方法的具体细节、如何传给大模型(是通过增加上下文,还是修改询问,还是在 token level 进行改变)、什么是边缘化以及为什么需要边缘化?
RAG-Sequence Model 、RAG-Token Model
RAG-Sequence:生成回答仅依赖于一篇文档,该模型适用于答案具有强连贯性,适用于答案来自于单一来源。在解码生成答案时,模型会针对每一篇文档分别生成一组完整的候选答案句子,最后再评估哪个完整句子的综合概率最高。
$$p_{\text{RAG-Sequence}}(y\vert{}x) \approx \sum_{z \in \text{top-k}(p(\cdot\vert{}x))} p_\eta(z\vert{}x) p_\theta(y\vert{}x, z) = \sum_{z \in \text{top-k}(p(\cdot\vert{}x))} p_\eta(z\vert{}x) \prod_{i}^N p_\theta(y_i\vert{}x, z, y_{1:i-1})$$RAG-Token:在生成一个 Token 的时候,都会重新参考不同的文档,综合多源信息,适用于答案需要多方资源的拼凑。检索器找出前 $k$ 篇文档。当生成器准备预测下一个词时,它会基于这 ${\displaystyle k}$ 篇文档分别计算出下一个词的概率分布,将它们汇总(边缘化)后确定这个词;在预测再下一个词时,它会重新审视这 ${\displaystyle k}$ 篇文档并重复上述过程。
$$p_{\text{RAG-Token}}(y\vert{}x) \approx \prod_{i}^N \sum_{z \in \text{top-k}(p(\cdot\vert{}x))} p_\eta(z\vert{}x) p_\theta(y_i\vert{}x, z, y_{1:i-1})$$Retriever: DPR
DPR 采用的是一种 Bi-encoder 架构,其核心工作机制如下:
- 文本向量化表示:
- 文档编码器:使用一个基于 $\text{BERT}_{\text{BASE}}$ 的文档编码器将每一篇文档 $z$ 映射为一个稠密向量表示,记为 $d(z)$。公式表示为:$d(z) = \text{BERT}_d(z)$。
- 查询编码器:同样使用一个基于 $\text{BERT}_{\text{BASE}}$ 的查询编码器,将用户的输入查询 $x$ 映射为一个稠密向量表示,记为 $q(x)$。公式表示为:$q(x) = \text{BERT}_q(x)$。
- 相似度计算与概率分布: 检索某篇文档的概率 $p_\eta(z\vert{}x)$ 与查询向量和文档向量的点积(内积)的指数成正比。数学表示为:
“参数化记忆”是指模型在训练过程中,将知识通过权重(例如神经网络中的连接权重)压缩并储存在模型内部。BERT 或 BART 这类预训练模型的参数就是它们的参数化记忆。 而“非参数化记忆”则截然不同。它类似于模型的一个外部知识库或外挂硬盘,知识以原始的、独立的数据形式保存在模型外。
MIPS 负责解决在庞大的知识库向量中,如何快速找出与 ${\displaystyle q(x)}$ 内积最大(最相似)的前 ${\displaystyle k}$ 个向量。挨个点积运算会很慢,MIPS 就是负责快速干这个事情的,论文中具体的算法使用了FAISS 库结合 HNSW 算法
RAG 的微调过程(整体工作流程)
Forward:
- 用户输入问题 $x$。
- $\text{BERT}_q$ 把它变成向量 $q(x)$。
- 用 $q(x)$ 去冻结的文档库里做内积计算(MIPS),找出 Top-K 篇文档 $z$,并得到它们的检索概率 $p(z\vert{}x)$。
- 生成器 BART 把问题 $x$ 和文档 $z$ 拼在一起作为输入,逐词生成答案,得到生成概率 $p(y_i\vert{}x, z, y_{\lt i})$。
- 将检索概率和生成概率结合(边缘化),算出最终的损失函数值(Loss,即上面的负边缘对数似然)。
Backward 与 Fine-tuning:
- BART: 梯度会流回 BART 的编码器(理解问题+文档)和解码器(生成答案)中。BART 内部的 Self-Attention、Cross-Attention 和FFN 的权重矩阵会进行参数更新。BART 借此学会如何更好地从拼在一起的文本中提取知识并组织成流畅的句子。
- $\text{BERT}_q$: 梯度会穿过生成器,流回到检索概率 $p(z\vert{}x)$,然后再顺着内积公式 $\exp(d(z)^\top q(x))$,最终流回查询向量 $q(x)$,并一直流回 $\text{BERT}_q$ 的内部参数。$\text{BERT}_q$ 内部的注意力机制和权重随之更新。这样,下次遇到类似问题时,$\text{BERT}_q$ 输出的向量坐标就会稍微偏移一点,变得离那些“真正有助于生成答案的文档”的固定向量更近一点。
边缘化及其作用
数学视角的边缘化
从概率论的底层公式以及深度学习的反向传播(梯度流向)角度,来解释“边缘化”在 RAG 模型中的精妙设计。
如果我们需要求事件 $Y$(生成正确答案)发生的概率,但这个过程依赖于一个中间的隐藏系统状态 $Z$(检索到了哪篇文档),且 $Z$ 有多种互斥的可能(即文档集合中的不同文档),我们就可以使用全概率公式。
- 对于任意一篇具体的文档 $z$,“检索到文档 $z$ 且基于 $z$ 生成答案 $y$” 的联合概率为:$p(y, z\vert{}x) = p(y\vert{}x, z) \cdot p(z\vert{}x)$。
- 因为真正的答案不依赖于某一篇特定的文档,所以我们要把所有中间状态 $Z$ 的可能性穷尽并相加。这在数学上就是对隐变量 $Z$ 积分(离散情况下为求和): $$p(y\vert{}x) = \sum_{z} p(y\vert{}x, z) p(z\vert{}x)$$
- 在 RAG 模型中,为了控制计算复杂度,求和的范围从无限的文档空间,被“截断”近似为了 MIPS 找出的 Top-K 篇文档,即 $z \in \text{top-k}(p(\cdot\vert{}x))$。 这就是边缘化的数学形态。但在深度学习中,它最重要的意义在于接下来的梯度反向传播。
梯度视角的边缘化
在 2.4 节提到,RAG 没有任何标签告诉检索器“该检索哪篇文档”,它的目标函数是最小化负边缘对数似然:
$$\mathcal{L} = -\log p(y\vert{}x) = -\log \sum_{z \in \text{Top-K}} p_\theta(y\vert{}x, z) p_\eta(z\vert{}x)$$当我们对检索器的参数 $\eta$ 求计算梯度,有:
$$\frac{\partial \mathcal{L}}{\partial \eta} = - \frac{1}{\sum_{z'} p_\theta(y\vert{}x, z') p_\eta(z'\vert{}x)} \sum_{z \in \text{Top-K}} p_\theta(y\vert{}x, z) \frac{\partial p_\eta(z\vert{}x)}{\partial \eta}$$这个梯度公式揭示了模型是如何自学检索的,若选择了恰当的文档 ${\displaystyle z}$ 那么 $p_\theta(y\vert{}x, z)$ 会很高,则梯度会向这个方向更新。它通过加权求和的形式,隐式地将 BART 的成功与否直接转化为了动态的评价信号。
实验与思考
作者把 December 2018 的 wiki dump 中的文章进行了分段,每段大约 100 个单词,共有 2100w 段,作者在这里把一段设定为一个文档。作者从开放领域的QA、抽象式QA、危险边缘问题生成、事实核查四个方面对 RAG 两个模型进行了检测。
即使不使用任何专门促进多样性的解码策略,RAG 模型的生成多样性也显著高于单纯的 BART 模型。其中,RAG-Sequence 的多样性又高于 RAG-Token。这说明引入外部文档作为上下文,天然地丰富了模型生成文本时的词汇和表达。针对于开放领域QA这类检索类较强的场景,RAG-Seq 明显表现更好,对于危险边缘问题生成这类不精确的场景,RAG-Token 由于可以结合多篇文档从而表现更好。
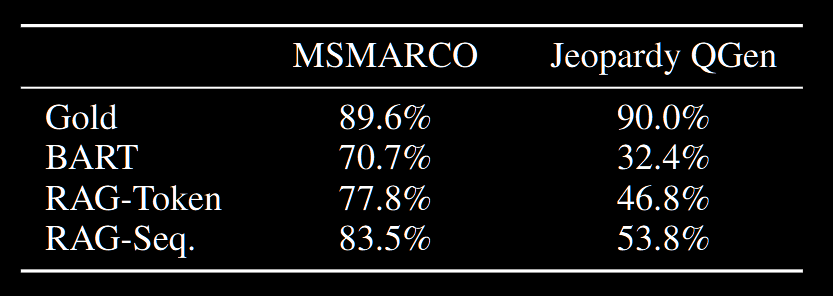
- 在 RAG-Token 中,模型在生成每一个词时,都会对 ${\displaystyle k}$ 篇文档给出的概率分布进行加权求和,针对于这 ${\displaystyle k}$ 篇文档,若文档 ${\displaystyle A}$ 强烈建议用偏僻的高级词汇 ${\displaystyle w_1}$,但是其他文档均选择了保守的词汇 ${\displaystyle w_2}$,那么文档 ${\displaystyle A}$ 的概率会被稀释,从而整体多样性会下降。
- 而在 RAG-Sequence 中,求和发生在整个句子生成之后,这迫使模型深入挖掘文档 A 特有的行文思路和专有词汇,生成一条极具个性的完整句子。
评论