Multi-Agent Systems Survey Notes
《Beyond Individual Intelligence》阅读笔记:个体能力、推理、记忆、规划、角色分配、多智能体通信、编排、故障归因与自进化。
近期 LLM 的能力呈线性或指数级上升,甚至大模型能力已然超出 AI 开发者的意料。OpenAI 团队称,内部模型通过约 10,000 个并行智能体协作,给出了 Navier–Stokes 千禧年难题的解答;Anthropic 研究员也介绍了 Claude 与领域专家合作开展的遗传学研究;Google 的 Gemini 4 Argon 则通过多智能体协作,帮助研究人员扩展了核聚变磁约束相关问题的数学解,这项研究与已有 59 年历史的 Grad 猜想有关。由此可见,随着任务规模和执行时长的增长,任务所要求的多元能力越来越难以全部集中在单个智能体中,多智能体协同提供了一种原则性的解决方案。
多智能体系统存在的问题
在多智能体协作中,单模型依旧有幻觉事实、消息误传或错误的工具调用等局部错误,这些错误在后续的交互轮次中扩散传播,随着步数的迭代,这些错误难以被发现定位,归因和自我纠错两种缺陷深度交织在一起,从而智能体们无法进行改进。
这种错误暴露出一种本质的不对称性:对于一个复杂精密的多智能体系统,它的能力远远超过了用于理解系统为何发生故障并促使自主改进的机制体系(RSI)。
弥合这一鸿沟需要一个闭环的框架,使得能够识别故障、减少预算、指导结构性自我改进。
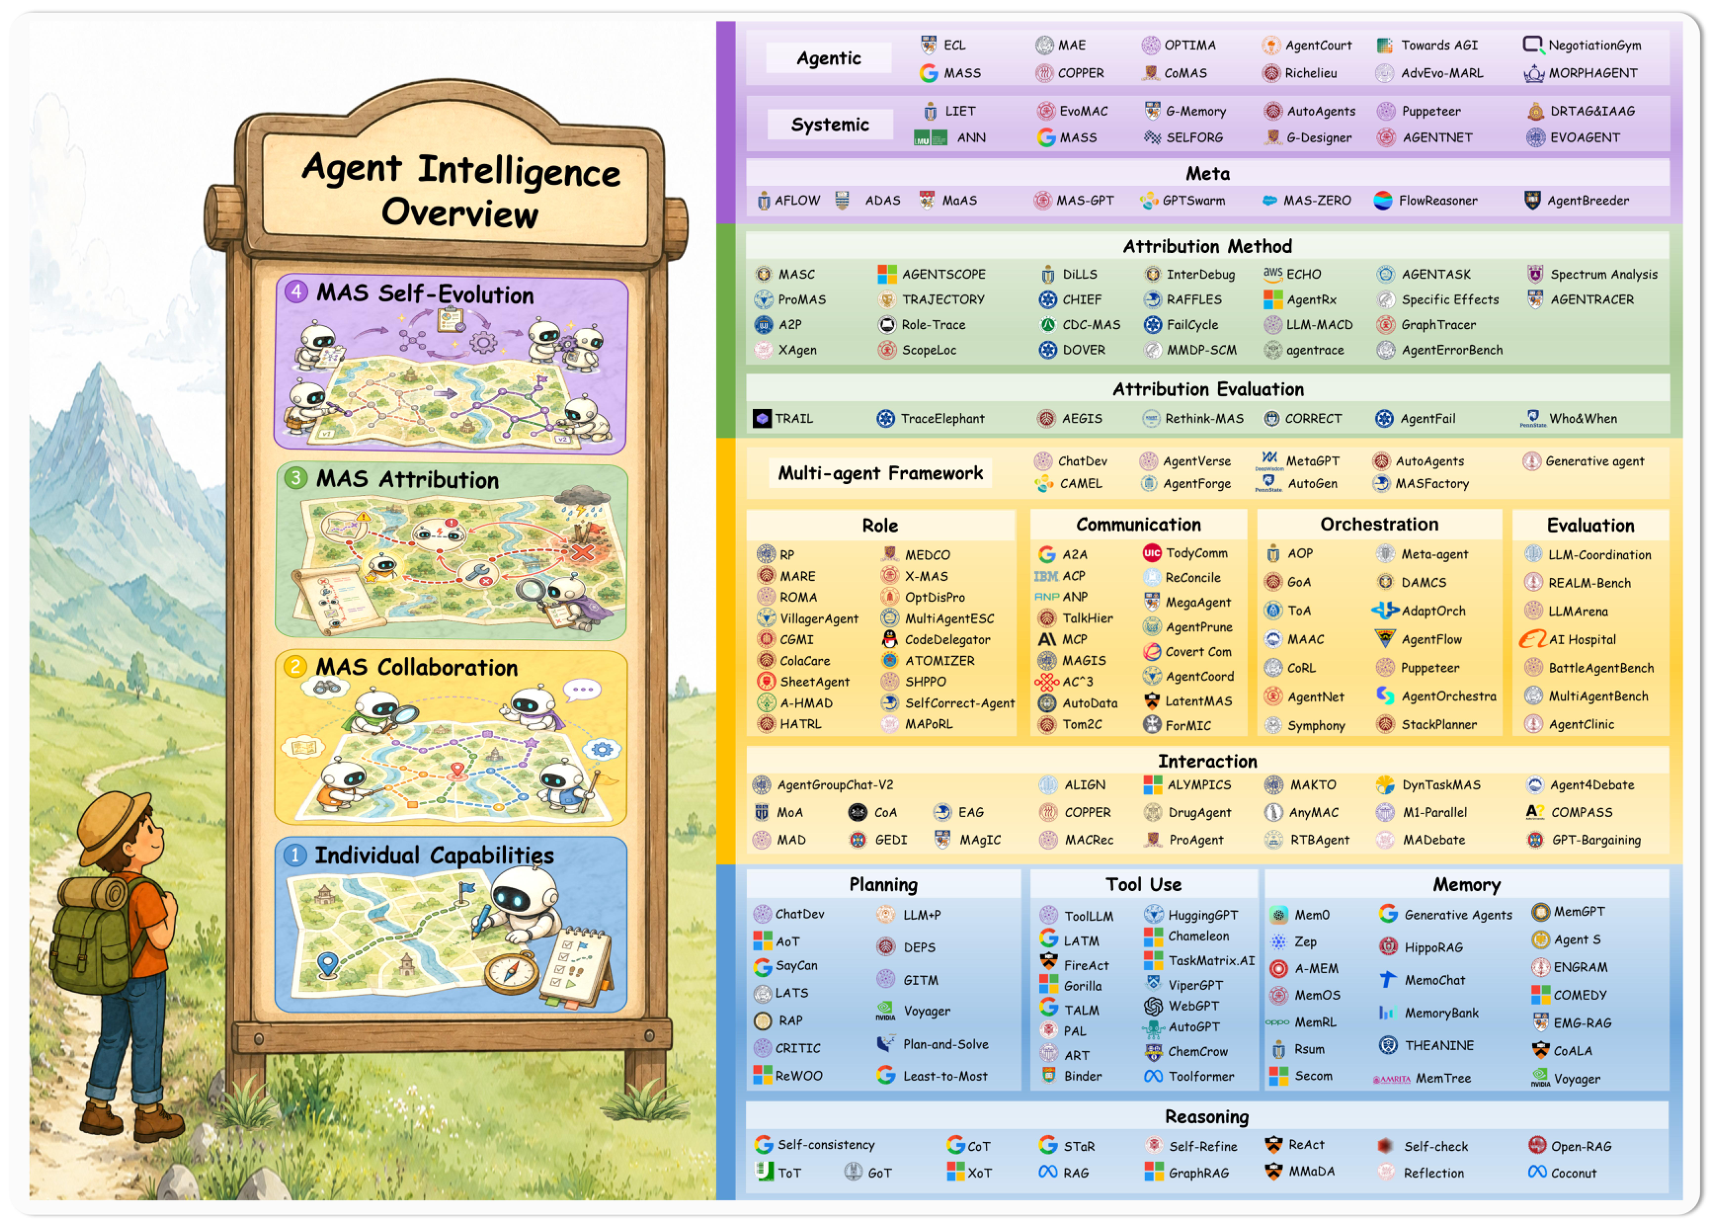
个体智能
LLM 在自动化软件工程、科学实验设计以及多步网页导航等复杂场景中依然具有局限性,本质的缺陷还是缺乏持久性记忆、无法主动感知外部环境,受限于训练期间的静态知识,Harness 赋予了 LLM 感知环境、制定目标、执行工具等能力,Agent = Harness + LLM:
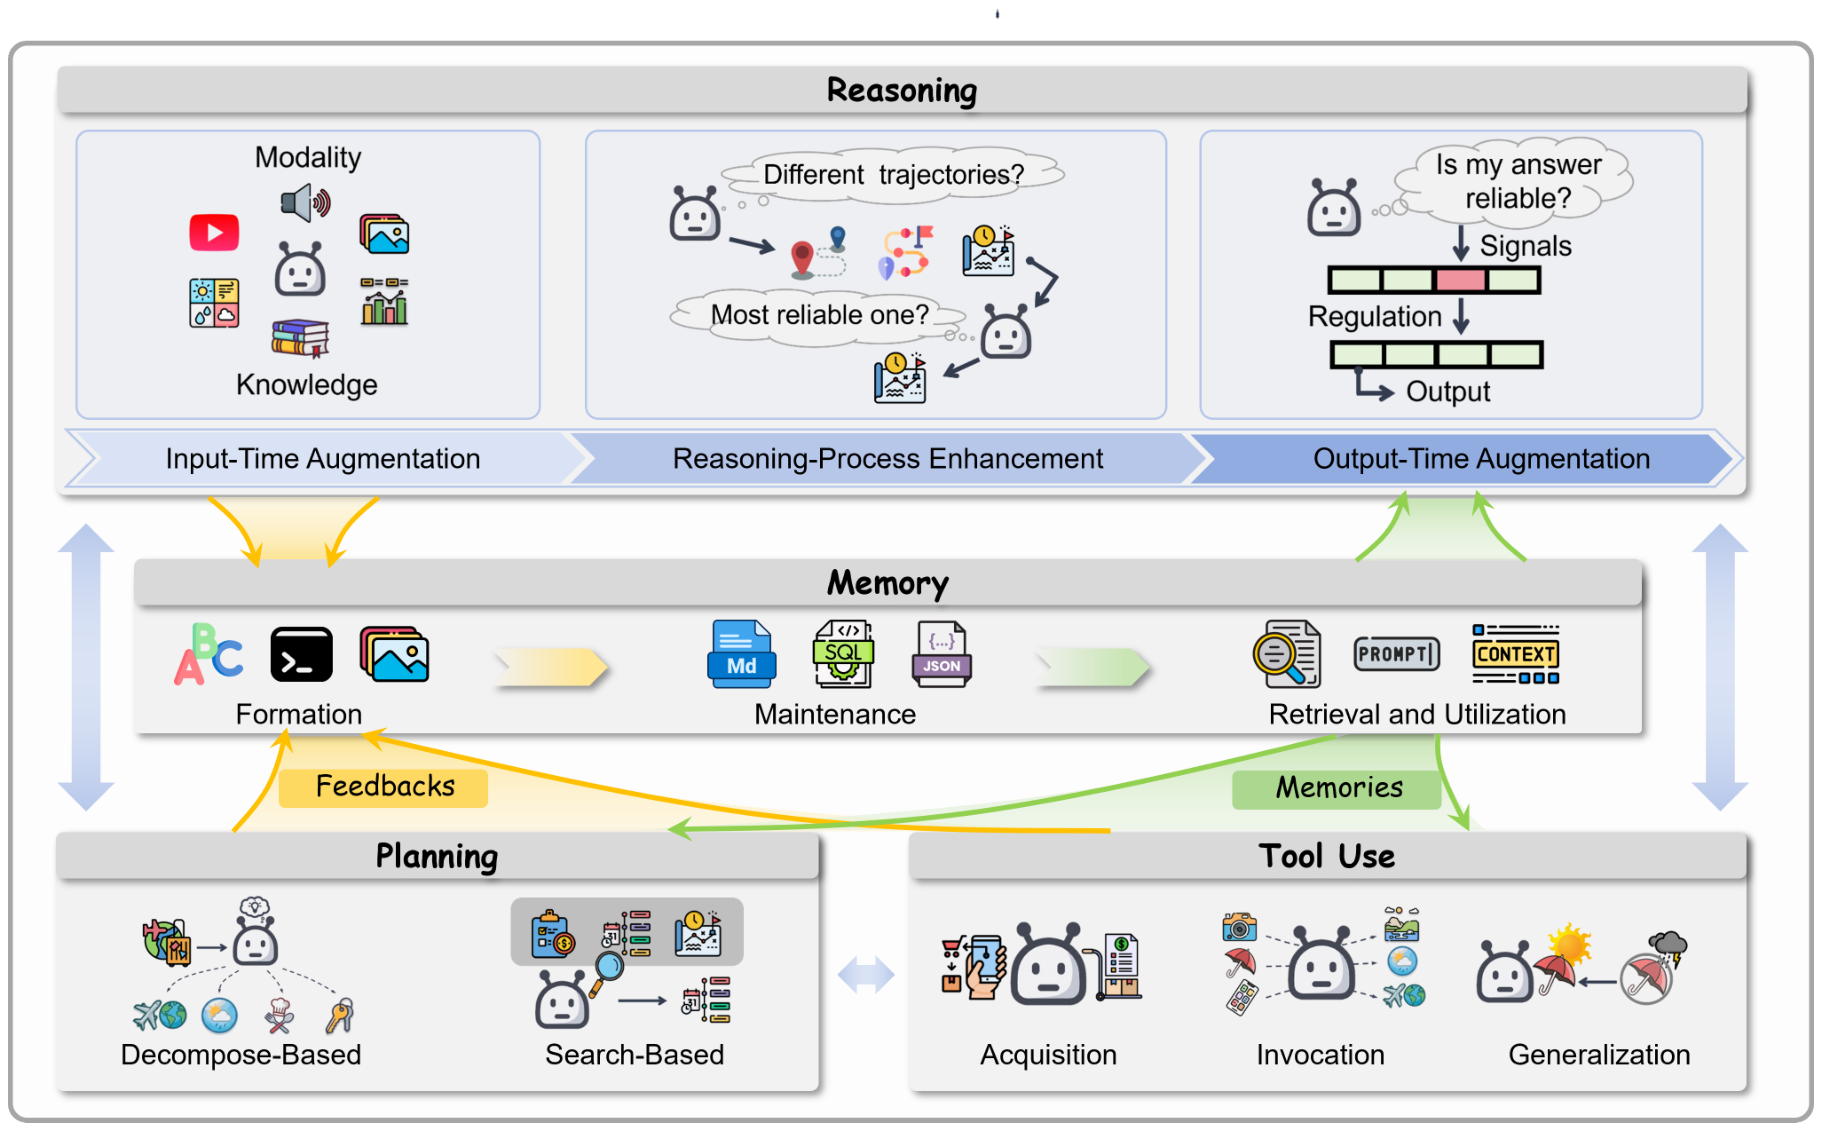
模块化优化占据主导地位,但模块间的耦合仍未经深入研究。推理、记忆、规划和工具使用在每一个时间步上都相互依存,然而现有方法几乎完全孤立地优化单个模块。各模块之间的能力不匹配往往成为端到端部署中的真正瓶颈,但这种故障模式对于目前的基准测试而言却是不可见的,因为现有基准大多只针对一到两种能力。
推理
CoT 通过精心设计的提示诱导出中间推理步骤,在不改变模型参数的情况下大幅度提升了复杂任务的性能。核心挑战便转变为外部机制应如何弥合模型的静态参数化知识与现实世界任务的动态需求之间的鸿沟。遵循这一视角,我们沿着推理管线的信息流来组织现有方法,将其划分为三个阶段:
- 输入阶段增强,通过外部知识检索与多模态感知来拓展模型可获取的信息边界;
- 推理过程增强,通过搜索空间扩展与路径验证来优化推理轨迹;
- 输出阶段调控,通过事后评估与自适应修正来提升生成结果的可靠性与事实准确性。
查询增强
RAG 将参数化生成器与非参数化检索器相结合,使得模型能在推理阶段从外部知识库中获取相关文档。在此基础上,后续的工作有
- 通过训练模型来自适应决定如何检索、通过反思标记对检索内容和生成内容进行评判
- 利用知识图谱进行检索,查询相关子图、在知识图谱上进行多跳推理
Knowledge Card设计多个小模型作为各个领域可插拔的知识模块,小模型负责生成背景材料,依然通过检索由大模型来回答RuAG利用大模型辅助确定候选条件和预测目标,通过蒙特卡洛树搜索从离线数据中挖掘可靠的逻辑规则,再将规则转化为自然语言,直接或按需检索后注入提示词,指导大模型进行推理和生成。
推理增强
对于推理轨迹本身,沿两个维度对其进行组织:搜索空间扩展,用于增加候选解的覆盖度;以及路径验证,用于提供识别最可靠结果所需的选择压力。
搜索空间扩展
CoT、ToT、GoT 依赖人工设计的提示协议,DeepSeek-R1 通过大规模的 RL 训练模型自主生成长思维链,展现出纯粹源自奖励优化的自我验证、自发回溯、自我批评的能力。
推理路径验证
拓展了搜索空间能够产生更多的候选解,更多的候选解意味着会引入等量的错误路径。目前的方法通过采样多条输出后内部投票、维护失败自迭代等方式,这种方法不改变模型的参数。 PRM 通过对推理步骤进行独立评分,大幅度提升了模型的推理能力,后续的进展基于 PRM 整合到 RL 训练过程中,证实了过程监督在同时塑造习得策略与选择机制时最为有效。
输出检验
目前针对输出内容的可靠性评估分为两类。一类是通过将输出分解为多个待检验项,然后逐步核对知识库,还可以扩展到代码、数学推理、科学文献等更细粒度的错误定位。另一类则是不借助外部知识,通过衡量多个样本的一致性来检测幻觉,或是模型自主去检验、独立回答,亦或者多条样本根据投票选出胜者,然后以此进行自迭代。
表 1. 推理增强方法对比,按干预阶段和子类型编排。
Table 1
子类型:KE 知识增强;PE 感知增强;ESS 扩展搜索空间;VRP 推理路径验证;OV 输出验证;RC 响应修正。任务范围:评估领域——Ma 数学;QA 问答;Co 代码;LF 长文本生成;Ag 智能体;Mu 多任务。主要来源:主要信息源——Evid = 外部证据;Inter = 内部状态;Consis = 跨样本一致性;Log = 逻辑/验证;Tool = 基于工具。修正:错误修正机制——SF = 自我反馈;Refl = 反思;TV = 工具验证;SC = 自洽性。Ext. Ret.:使用外部检索。TF:免训练。TTC:支持测试时计算扩展。
| Method | Sub-type | Task Scope | Prim. Source | Correction | Ext. Ret. | Tool | TF | TTC | Year |
|---|---|---|---|---|---|---|---|---|---|
| A. Input-Stage Enhancement | |||||||||
| ViperGPT 89 | PE | Mu | Inter | — | — | ✓ | ✓ | — | 2023 |
| RAPTOR 90 | KE | QA LF | Evid | — | ✓ | — | ✓ | — | 2024 |
| Self-RAG 50 | KE | QA LF | Evid | SF | ✓ | — | — | — | 2024 |
| LLaVA 91 | PE | Mu | Inter | — | — | ✓ | — | — | 2024 |
| TopViewRS 92 | PE | Mu | Inter | — | — | — | ✓ | — | 2024 |
| VisCoT 93 | PE | Mu | Inter | — | — | — | ✓ | — | 2024 |
| HippoRAG2 94 | KE | QA LF | Evid | — | ✓ | — | ✓ | — | 2025 |
| Theanine 95 | KE | QA LF | Evid | — | ✓ | — | ✓ | — | 2025 |
| SubgraphRAG 51 | KE | QA | Evid | — | ✓ | — | ✓ | — | 2025 |
| B. Reasoning-Process Enhancement | |||||||||
| Self-Consistency 64 | VRP | Ma QA | Consis | SC | — | — | ✓ | ✓ | 2023 |
| LATS 96 | ESS | Mu | Inter | Refl | — | ✓ | ✓ | ✓ | 2024 |
| CoC 97 | ESS | Ma QA Co | Tool | — | — | ✓ | ✓ | — | 2024 |
| AnyTool 98 | ESS | Ag | Tool | SF | — | ✓ | ✓ | — | 2024 |
| RAIN 99 | ESS | QA | Inter | SF | — | — | ✓ | ✓ | 2024 |
| Math-Shepherd 67 | VRP | Ma | Log | — | — | — | — | ✓ | 2024 |
| CPO 62 | VRP | Ma | Log | — | — | — | — | — | 2024 |
| rStar 100 | ESS | Ma | Consis | SC | — | — | ✓ | ✓ | 2025 |
| rStar-Math 101 | ESS | Ma | Consis | SC | — | — | — | ✓ | 2025 |
| TTS 102 | ESS | Ma | Log | — | — | — | ✓ | ✓ | 2025 |
| TOPS 103 | ESS | Ma | Log | — | — | — | ✓ | ✓ | 2025 |
| Rewarding Progress 104 | VRP | Ma | Log | — | — | — | — | ✓ | 2025 |
| WizardMath 68 | VRP | Ma | Log | — | — | — | — | ✓ | 2025 |
| C. Output-Stage Regulation | |||||||||
| FActScore 70 | OV | LF | Evid | — | ✓ | — | ✓ | — | 2023 |
| FacTool 71 | OV | Mu | Evid | — | ✓ | ✓ | ✓ | — | 2023 |
| SelfCheckGPT 73 | OV | LF | Consis | — | — | — | ✓ | — | 2023 |
| Semantic Entropy 105 | OV | QA LF | Inter | — | — | — | ✓ | — | 2023 |
| RARR 78 | OV | QA LF | Evid | TV | ✓ | — | ✓ | — | 2023 |
| ITI 81 | RC | QA | Inter | — | — | — | ✓ | — | 2023 |
| Reflexion 19 | RC | Ag Co | Inter | Refl | — | — | ✓ | ✓ | 2023 |
| L2R 106 | RC | QA | Inter | — | — | — | — | — | 2023 |
| Factcheck-GPT 72 | OV | QA LF | Evid | — | ✓ | — | ✓ | — | 2024 |
| HaloScope 75 | OV | QA LF | Inter | — | — | — | ✓ | — | 2024 |
| DoLa 79 | RC | QA LF | Inter | — | — | — | ✓ | — | 2024 |
| CAD 80 | RC | QA LF | Evid | — | — | — | ✓ | — | 2024 |
| FactTune 84 | RC | QA LF | Evid | — | — | — | — | — | 2024 |
| CoVe 77 | RC | QA LF | Log | SF | — | — | ✓ | ✓ | 2024 |
| CRITIC 87 | RC | QA Ma Co | Tool | TV | — | ✓ | ✓ | — | 2024 |
| R-Tuning 85 | RC | QA | Inter | — | — | — | — | — | 2024 |
| HalluLens 76 | OV | Mu | Inter | — | — | — | ✓ | — | 2025 |
| SADI 82 | RC | QA | Inter | — | — | — | ✓ | — | 2025 |
| MCD 83 | RC | QA LF | Inter | — | — | — | ✓ | — | 2025 |
| SEAL 88 | RC | QA LF | Inter | — | — | — | — | — | 2025 |
| SMC steering 107 | RC | QA Co | Log | — | — | — | ✓ | — | 2025 |
记忆
记忆的相关知识在之前文章已经给出,这里只给出沿记忆生命周期组织的记忆增强方法比较。
表 2. 沿记忆生命周期组织的记忆增强方法比较。
Table 2
形成(Formation):原始经验如何转化为记忆——Record = 原始记录;Distill = 生成式摘要;Routing = 类型化分类。存储(Storage):保存记忆的数据结构——Flat 扁平存储;Tiered 主上下文 + 归档;Graph 图结构;Tree 树结构;Typed 类型分离存储;Unified 多类型统一存储。维护(Maintenance):记忆如何更新或淘汰——Decay = 基于时间的遗忘;Eviction = 受预算约束的驱逐;CRUD = 创建/读取/更新/删除;Evolution = 追溯性细化;Versioning = 双时态追踪;Lifecycle = 统一管理;Learned = 基于强化学习的选择。检索(Retrieval):相关条目如何被召回——Multi-factor = 新近度 + 重要性 + 相关性;Injection = 全缓冲区注入;Autonomous = 通过函数调用自主驱动;Graph/Tree trav. = 在对应结构上遍历;Type-aware = 每种类型 top-k 检索后合并;Hybrid = 语义 + 关键词 + 图;Routed = 多路由检索;Utility-driven = 相似度 + Q 值重排序。记忆类型(Mem. Type):E(情景记忆),S(语义记忆),P(程序记忆);实心 = 支持,空心 = 缺失。任务领域(Task Domain):Conv = 对话;Ent = 企业。
| Method | Formation | Storage | Maintenance | Retrieval | Mem. Type | Task Domain | Year |
|---|---|---|---|---|---|---|---|
| Generative Agents 110 | Record, Distill | Flat | Append | Multi-factor | ●●○ | Simulation | 2023 |
| MemoChat 112 | Distill | Flat | Append | Similarity | ●●○ | Conversation | 2023 |
| Reflexion 19 | Distill | Flat | Append | Injection | ●○○ | General | 2023 |
| MemoryBank 123 | Record | Flat | Decay | Similarity | ●●○ | Conversation | 2024 |
| MemGPT 111 | Record | Tiered | Eviction | Autonomous | ●○○ | Conv, QA | 2024 |
| HippoRAG 119 | Distill | Graph | Incremental | Graph trav. | ○●○ | QA | 2024 |
| EMG 120 | Distill | Graph | Rewrite | Similarity | ●●○ | Conversation | 2024 |
| SeCom 115 | Distill | Flat | Append | Similarity | ●●○ | Conversation | 2025 |
| ENGRAM 116 | Routing | Typed | Append | Type-aware | ●●● | Conversation | 2025 |
| Mem0 114 | Distill | Graph | CRUD | Similarity | ○●○ | Conversation | 2025 |
| MemTree 121 | Distill | Tree | Compression | Tree trav. | ○●○ | QA | 2025 |
| A-MEM 122 | Distill | Graph | Evolution | Similarity | ○●○ | Conversation | 2025 |
| Zep 118 | Distill | Graph | Versioning | Hybrid | ●●○ | Conv, Ent | 2025 |
| RecurSum 113 | Distill | Flat | Compression | Similarity | ○●○ | Conversation | 2025 |
| COMEDY 124 | Distill | Flat | Compression | Similarity | ●●○ | Conversation | 2025 |
| MemOS 125 | Routing | Unified | Lifecycle | Routed | ●●● | General | 2025 |
| MemRL 126 | Record | Flat | Learned | Utility-driven | ●○○ | General | 2026 |
规划
与单步推理不同,规划需要在长视野跨度下考虑子任务依赖性、环境反馈以及潜在的执行失败。现在将方法划分为两种范式:基于分解的规划以及基于搜索的规划
基于分解的规划
基于分解的方法可以简单理解为:将长程任务或复杂任务分解成多个易于管理、易于并行、易于执行的子任务,主要区别在于分解相对于执行过程发生的时间节点。
前瞻性分解
前瞻性分解在采取任何动作之前生成一份完整的规划。Least-to-Most 引入了将问题逐步分解为更简单的子问题并依序求解的思想。Plan-and-Solve 则用显式的规划阶段及随后的依序执行取代了通用的“think step by step”。HuggingGPT 将用户的多模态请求分解为任务依赖图(即拆解为任务1、2、3…,其中任务3依赖任务2,任务2依赖任务1),随后根据规划出的每个子任务去HuggingFace上去寻找对口模型进行工作。
LLM 做长链规划的时候有逻辑不严密、自回归生成太慢、容易在细节里迷失方向。Planning Anything (LLMFP)通过运筹学的规划器把任何自然语言规划问题写成一段调用形式化求解器,但使用场景较为局限。Plan-and-Act 专门针对长视野 Web 任务,将高层规划与底层动作执行相分离,模型通过训练集来理解应该先去做什么以此来进行规划,证明了显式前瞻性规划在复杂 Web 基准测试中显著优于反应式方法。
基于搜索的规划
基于搜索的方法显式探索多条候选路径,并通过评估、剪枝或回溯在其中做出选择
步骤级搜索
步骤级搜索在每个决策点展开并评估候选方案。蒙特卡洛树搜索(MCTS)已被证明对基于大语言模型的规划尤为有效。MCTS 的决策公式可表现为:
在决定下一步的时候,它会选择得分最高的节点,其中 $Q$ 是以前走过的路(效果有多好),$N$ 为在该状态下执行动作的次数有多少,$N$ 越小决策就越鼓励去尝试新方法。
在此基础上,LLM-MCTS、RAP、REST-MCTS 都相继进行了优化和改进,其中 REST 利用了 PRM 模型来针对于每个决策节点进行评分从而进行微调达到性能提升。
除此之外,AFlow 使用了类似 Dream-RSI 的方法(可以说 Dream-RSI 参考了 AFlow),在任务动作节点上进行扩展,缺点是成本太高。ToolChain 利用了 A* 算法来进行启发式扩展,也有利用扩展模型进行隐式搜索的方法。
表 3. 按规划范式组织的规划增强方法比较
Table 3
策略(Strategy):规划与执行之间的时间关系(表 A 部分)或搜索算法(表 B 部分)——Proactive 执行前完整规划;Progressive 规划与执行交织循环;MCTS 蒙特卡洛树搜索;A 启发式 A 搜索;Retrieve 检索引导;Diffusion 基于扩散;Greedy 贪心。结构(Structure):规划表征(表 A 部分)或搜索空间(表 B 部分)——Seq = 顺序序列;DAG = 有向无环图;Tree = 树状结构;Program = 编程式;State/Action/Plan = 相应的搜索空间。执行模式(Exec Mode):Seq = 顺序执行;Hier = 分层执行;Intlv = 与规划交织。
| Method | Strategy | Structure | Exec Mode | Replan | Task Domain | Year |
|---|---|---|---|---|---|---|
| A. Decomposition-Based Planning | ||||||
| Least-to-Most 130 | Proactive | Seq | Seq | — | General | 2023 |
| Plan-and-Solve 131 | Proactive | Seq | Seq | — | General | 2023 |
| HuggingGPT 132 | Proactive | DAG | Hier | — | General | 2023 |
| LLM-Planner 134 | Proactive | Seq | Seq | ✓ | Robotics | 2023 |
| LLM+P 135 | Proactive | Seq | Seq | — | Robotics | 2023 |
| ReAct 18 | Progressive | Seq | Intlv | — | General | 2023 |
| DEPS 142 | Progressive | Seq | Intlv | ✓ | General | 2023 |
| LLMCompiler 133 | Proactive | DAG | Hier | ✓ | Tool | 2024 |
| Skeleton-of-Thought 137 | Proactive | Tree | Hier | — | General | 2024 |
| Voyager 128 | Progressive | Seq | Intlv | ✓ | General | 2024 |
| ADaPT 139 | Progressive | Tree | Intlv | ✓ | General | 2024 |
| CodeAct 141 | Progressive | Program | Intlv | ✓ | General | 2024 |
| KnowAgent 143 | Progressive | Seq | Intlv | ✓ | General | 2024 |
| Planning Anything 136 | Proactive | Program | Seq | — | General | 2025 |
| Plan-and-Act 138 | Proactive | Seq | Hier | — | Web | 2025 |
| SelfGoal 140 | Progressive | Tree | Intlv | ✓ | General | 2025 |
| B. Search-Based Planning | ||||||
| LLM-MCTS 145 | MCTS | State | Seq | — | Robotics | 2023 |
| RAP 147 | MCTS | State | Seq | — | General | 2023 |
| PromptAgent 146 | MCTS | State | Seq | — | General | 2024 |
| ToolChain* 150 | A* | Action | Seq | — | Tool | 2024 |
| REST-MCTS* 148 | MCTS | State | Seq | — | General | 2024 |
| PlanRAG 153 | Retrieve | Plan | Seq | ✓ | QA | 2024 |
| AFlow 149 | MCTS | Plan | Seq | — | General | 2025 |
| DiffuSearch 151 | Diffusion | State | Seq | — | General | 2025 |
| Agent S 127 | Greedy | Plan | Hier | ✓ | Web | 2025 |
多智能体协同
多智能体系统(MAS)类似于人类社会中的分工与合作,其中智能体通过协同解决复杂问题。通过整合具备不同能力的智能体,多智能体系统能够应对超出任何单个智能体能力范围的任务。在本文中,我们将多智能体系统 $S$ 形式化定义为
其中 $\mathcal{A}=\{a_{1},\ldots,a_{N}\}$ 为智能体集合; $\mathcal{E}$ 表示可能影响多智能体系统 $S$ 运行的共享环境; $\mathcal{C}$ 为规范消息交换的通信协议;$\mathcal{G}$ 表示描述多智能体系统 $S$ 架构的编排拓扑; $\Pi$ 表示协同策略集合。
角色
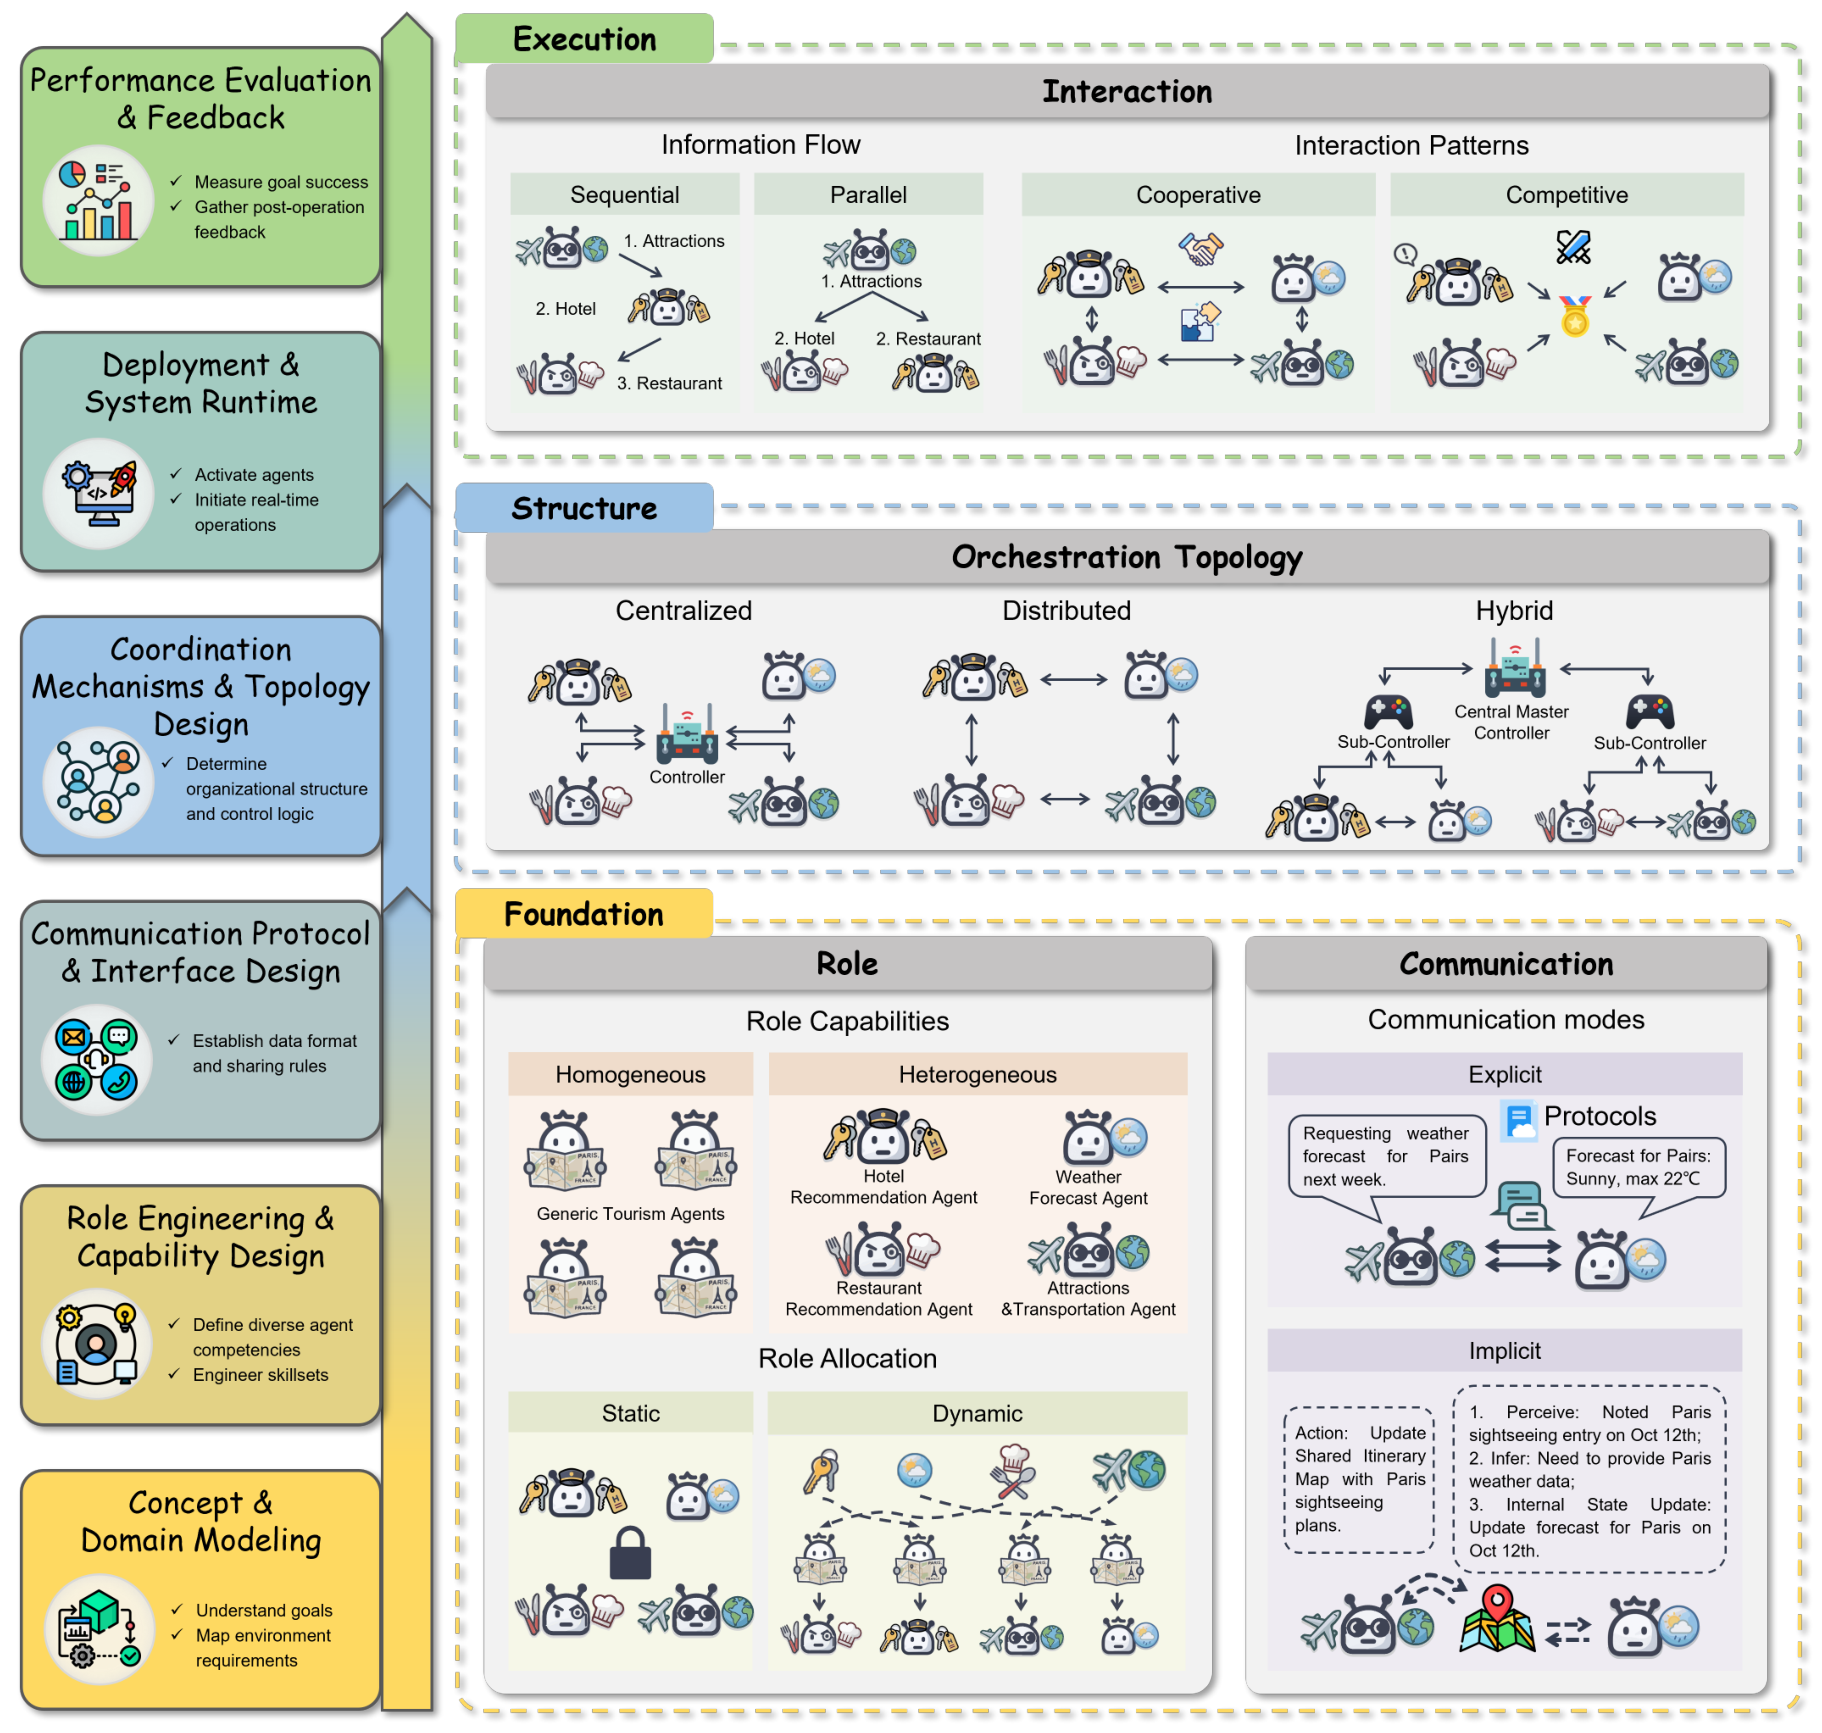
理解角色需要回答两个基本问题:智能体能够做什么,以及责任如何在它们之间分配。因此,我们将角色分解为两个维度:角色能力回答第一个问题,而角色分配则通过映射函数 $\rho(\cdot)$ 分配这些能力来回答第二个问题。
角色能力
顾名思义,角色能力就是 LLM 自身所具备的能力,角色能力大致分为同质角色能力和异质角色能力两种。
同质角色能力
在 MAS 中,同质角色能力指的是由相同的 LLM 驱动,即多智能体均由同一智能体驱动,拥有完全对称的推理能力、相同的工具集和相同的视野范围。它们之间唯一的区别,仅仅是 Prompt 里写的人设句子不同(比如一个被告知“你是甲方提问者”,另一个被告知“你是乙方回答者”)。
- 优点:工程实现极简(一套模型接口和工具集到处复用),且在学术研究上提供了控制变量的纯净环境(排除不同模型能力差异的干扰,纯粹研究协作协议本身)。
- 缺点:遇到高难任务时,同 LLM 的知识盲区一样,难以突破。
异质角色能力
与上一部分相反,由不同 LLM 进行驱动,可以合理利用各 LLM 擅长的能力,组合将能力、成本、性价比最优化。让不同 Agent 在底座模型、动作权限、或信息视野上真正产生本质差异。
可以通过固定不同的 LLM、按照职能切分、通过后训练和 RL 来自行决定等方法来进行分配。
角色分配
静态角色分配:指定智能体或子智能体担任的角色和职责,在任务分配之前安排好,过程中不会改变,这使得工作流程边界清晰、零临场组队开销、极其稳定。同时这种分配只适用于较为局限的场景下,对于动态或不确定的场景下性能表现较差。
动态角色分配:动态角色分配允许系统在运行时根据当前任务有多难、进行到哪一步了,实时改变子智能体的分配策略。极其灵活,具备较高的通用性,但相对的,动态分配的策略依赖于 Agent 架构和主 LLM 的能力,因此实现较为复杂,并且管理复杂度也会上升。
多智能体通信
多智能体通信可以分为通信模式和通信协议
通信模式
显式通信:目前最主流的通信方式,智能体与智能体之间通过标准化的文字、或以聊天形式呈现。该方式可以通过约束聊天内容来减少 Token 消耗,不过整体依然很冗余,效率并不高。
隐式通信:智能体与智能体之间可以不直接发消息,可以通过观察环境变化、动作轨迹来判断其它子智能体做了什么。
更少见的,可以通过潜空间亦或是隐变量交流(LatentMAS),我认为这是未来一两年的研究主流,也是 RSI 的必经之路,但这种缺点在于不好控制、容易触发安全红线,因为我们看不到智能体之间在交流什么。一个近期较为具体的例子是最近 OpenAI 的 Hugging Face 事件是若干独立智能体在爬取 HF 网站的时候,通过轨迹、日志判断出还有其它智能体进行着相似任务,从而它们绕过监督进行了交流,造成了大规模入侵事件。
通信协议
主流通信协议有以下三类:
- A2T (Agent-to-Tool):智能体 $\leftrightarrow$ 外部工具/数据库
- A2A (Agent-to-Agent):智能体 $\leftrightarrow$ 智能体
- A2S (Agent-to-System):智能体 $\leftrightarrow$ 宿主平台/前端网关
A2T 目前 MCP 成为主流,相关的内容我之前的博客里面也有写。
A2A 是 Google 联合 50+ 科技巨头共同提出的,它负责解决不同责任的 Agent 之间的通信
核心机制:每个 Agent 对外公布一张名片叫 Agent Card(一个 JSON 文件,写明我擅长干什么、收什么格式的参数、怎么鉴权)。然后两个黑盒 Agent 就能像发 HTTP 请求一样直接点对点派活、通过 SSE 实时同步长任务的进度,以及互传产出物。
其中, Agora 是由牛津大学提出的“自适应语言切换”协议,它认为智能体之间应该由低频的二进制语言或其它被压缩过的语言进行交流,这一点很接近上述潜空间的定义。
表 4. 智能体通信协议对比。
Table 4
通信类型(Comm. Type):A2A = 智能体对智能体;A2T = 智能体对工具;A2S = 智能体对系统。消息格式(Msg. Format)描述数据序列化方式,其中 PD = Protobuf/数据驱动;NL = 自然语言;TD = 物描述;SSE = 服务器发送事件。核心功能(Core Functions):该协议提供的主要能力或服务。
| Protocol | Proposer | Comm. Type | Msg. Format | Core Functions | Year |
|---|---|---|---|---|---|
| Agora 275 | University of Oxford | A2A | PD | Consensus formation | 2024 |
| MCP 276 | Anthropic | A2T | JSON-RPC | Standardized context access | 2024 |
| ANP 277 | ANP Community | A2A | JSON-LD+NL | Meta-protocol negotiation | 2024 |
| LMOS 278 | Eclipse Foundation | A2S | JSON-LD+TD | Group management | 2024 |
| ACP 279 | IBM | A2A | JSON-LD | Async & Sync interaction | 2025 |
| A2A 26 | A2A | JSON-RPC/SSE | Agent discovery | 2025 | |
| Agent Protocol 280 | AI Engineer Foundation | A2S | REST/HTTP | Standardized task API | 2025 |
编排
编排描述了在多智能体系统 $S$ 中规范多个智能体如何组织与交互的全局协调结构。从系统级视角来看,编排可以被视为协同拓扑 $\mathcal{G}=(\mathcal{A},\mathcal{E}_{c})$:它定义了智能体 $a_{i}\in\mathcal{A}$ 如何相连、信息如何在它们之间的通信链路 $\mathcal{E}_{c}$ 中流动,以及在任务执行过程中协调决策是如何构建的。编排聚焦于更高层次的结构组织,决定了这些角色与通信如何被整合为一个连贯的协同过程。编排主要可以分为三大类:集中式编排、分布式编排、混合式编排。
集中式编排
集中式编排为中心化一个智能体来调度下面的子智能体做任务。AOP 尝试不再让中心智能体单纯凭借知识来拆解任务分给子智能体,而是通过一个轻量级奖励模型给“子任务给子智能体的匹配度”打分,将调度分为可解性(分配的任务子智能体必须有能力完成)、完备性、非冗余性。CoRL针对于多基座模型协作通过强化学习训练了一个中心控制器,让他在每一步决定调用哪个专家模型,其目标奖励函数为:
其中 $\lambda \ge 0$,当 $\lambda$ 较小的时候,意味着预算充足,可以多调用专家模型,相同的,$\lambda$ 较大则鼓励只调用少量专家来解决任务。
在集群智能体(大规模的智能体协作)场景下,中心调度会出现注意力稀疏、单点崩盘的后果。
分布式编排
顾名思义,分布式编排没有中心调度器,每个智能体都是独立的个体不受人控制,但没有了中心管理,如何让多智能体一起工作成为了主要难题。
AgentNet 给每个智能体分配了一个 Router 和 Executor,网络开始是全连接的,当一个智能体收到任务时,它会判断该任务自己是否可以完成,否则拆一部分分派给其它智能体,通过 EMA 动态权重来进行动态分配,以确保分配给的智能体有能力去做这部分任务。
MAAC 则通过多 LLM 训练来解决,它把每个智能体设为独立的 Actor,引入 Critic 模型评估每一步的协同价值。CoLLM-CC( CTDE:中心化训练,去中心化执行):在训练阶段用一个能看到所有人状态的全局 Critic 来指导各个 LLM 更新梯度;到了实际部署运行阶段,撤掉 Critic,各个 LLM 完全独立分布式运行。实验证明,在长视野稀疏奖励任务中,CoLLM-CC 收敛速度和协作效果远超纯启发式规则。
AHKG 试图解决多智能体在工作时的视野局限性问题,没有了中心智能体就没有人能从上帝视角来看整个任务的进度,可以通过通信机制,或者通过分层知识图谱。两个 Agent 相遇或通信时对知识图谱的“高层语义节点”和“任务相关局部子图”做差异合并。
混合编排
在宏观上保留“中心化的顶层设计与目标约束”,在微观执行上放权给底层做“去中心化的局部自治与并行沟通”。
GoA 通过在局部 Agent 之间动态建立非线性的有向边,使得相邻节点自由互相补充和纠错。同时,整张图的构建和消息池化受到一个全局预定义拓扑目标(如信息论中的信息瓶颈压缩目标或全局任务对齐约束)的严格统领,确保局部的自由讨论最终收敛到统一的中心目标上。
AdaptOrch 针对不同的任务选择了不同的拓扑编排。AdaptOrch 设了一个中心化的自适应元协调器。它先画出任务的依赖有向无环图 $G = (V, E)$,然后只花线性时间 $O(|V|+|E|)$ 计算图的结构特征(如最大宽度/并行度、最大深度/串行链长、子图耦合度),从 4 种标准拓扑 中动态选出最匹配的一种:
- Parallel:当子任务完全独立($|E| \approx 0$)时启用;
- Sequential:当任务是单链条强因果依赖时启用;
- Hierarchical:当任务跨模块且需要中心汇总对账时启用;
- Hybrid:当任务图里既有并行簇又有长依赖链时动态组合启用。
多智能体系统故障归因
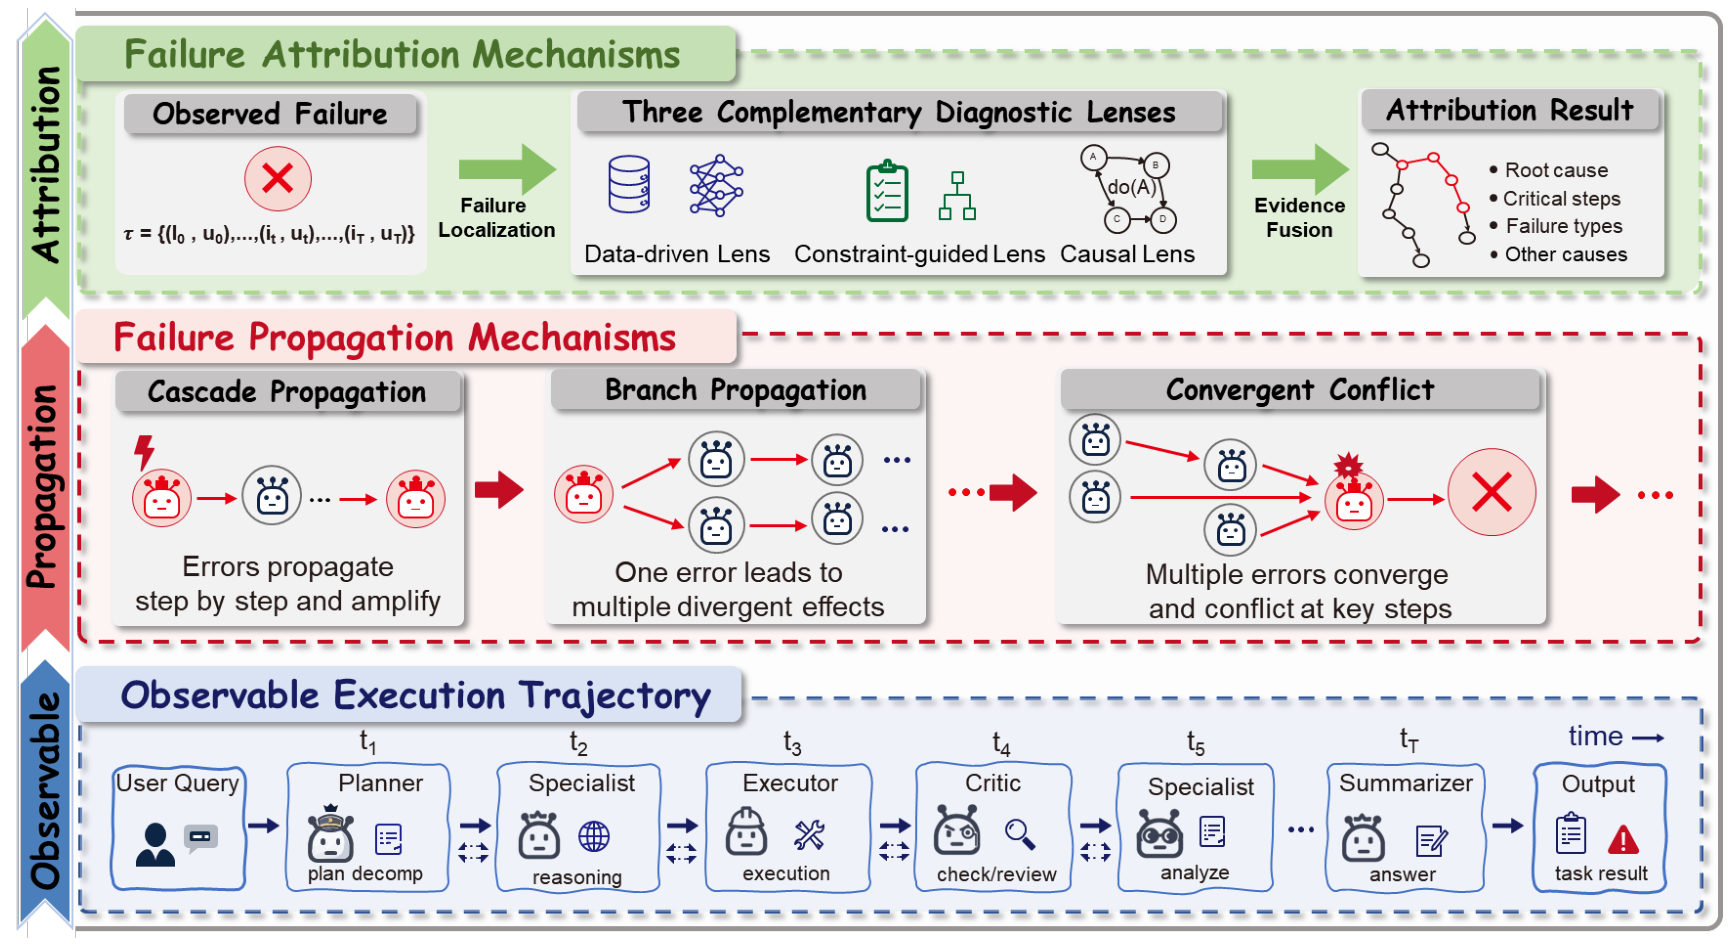
在单智能体中,一般是可以很好定位到错误,它的产出结果由它一人负责。但是在多智能体系统中,一个智能体的产出并不会立刻报错,而且会顺着交互链一直延续下去,而其它智能体可能会受该产物影响又产生新的错误。因此错误归因变得极其重要。
诊断
多智能体执行轨迹 $\tau$ 是指在给定的用户查询、初始环境状态和系统配置下形成的时间有序动态序列,可以形式化为:
其中 $H$ 表示轨迹时域长度,$(i_{t},u_{t})$ 则表示在时间步 $t$ 处于活跃状态的智能体及其相应的行动。
为了定义故障发生的条件,引入了轨迹评估函数 $Z(\tau)$。当 $Z(\tau)=1$ 时,表示轨迹 $\tau$ 的最终结果状态被评估为异常。故障归因过程可形式化为:
只有当系统轨迹被判定为异常时(即 $Z(\tau)=1$),归因模型 $f$ 才会以系统配置 $\Omega$、轨迹 $\tau$ 和用户查询 $q$ 作为输入,并返回对故障负责的智能体及对应的决定性时间步(表示为二元组 $(I,t)$);若系统运行正常,则输出空集 $\emptyset$。
故障分类
可以将现有的故障分类体系归纳为三大正交视角:系统结构视角、执行阶段视角 和 因果生命周期视角。
系统结构视角
这一视角聚焦于智能体之间的组织架构与交互边。基本方法是定义若干类错误(MAST 定义了 3 大类 14 子类、AgentAsk 定义了 4 种交接错误类),然后通过根据执行轨迹来判断某个智能体的轨迹是否出错,归属于哪一类(一般通过 LLM 来决策),其中 AgentAsk 增加了追问打回的流程,即判断出错误后,进一步的向产生错误的 Agent 澄清问题重新做。
执行视角
这一视角不再按智能体之间的边来切分,而是按Agent 内部的功能模块或任务执行的时序阶段来切分。
AgentErrorTaxonomy / AgentErrorBench / AgentDebug 采用了模块化的 Agent 架构,将错误归因于五个分类:记忆、反思、规划、执行、系统级操作;将每一步 $t$ 的输出按功能拆解为五个显式字段:$u_t = \{m_t^{\text{mem}}, m_t^{\text{ref}}, m_t^{\text{plan}}, m_t^{\text{act}}, m_t^{\text{sys}}\}$,利用 Critic LLM 选择出错误模块节点集合 $\mathcal{C} = \{(t_k, \text{module}_k, \mathrm{error\_type}_k)\}$ 然后在该集合中找到最早触发错误的节点,之后可以进行回溯修复重做。
因果生命周期视角
前两个视角(系统结构、执行阶段)本质上还是在给“单个故障点”贴静态标签;而因果生命周期视角则把故障看作一个活的、动态演化的生物体,重点刻画它发生错误的全过程。
故障引入的时间步(Originating Point $t_{\text{origin}}$)与故障暴露为可见异常的时间步(Manifestation Point $t_{\text{manifest}}$)往往严重分离,FailCycle 将 MAS 中的错误划分为四个阶段:Fault Introduction (潜伏引入)、Propagation (隐蔽传播)、Evolution / Mutation (跨节点变异)、Manifestation (显性爆发),随后依然是构建图然后定位错误进行回溯处理。
AGENTSCOPE 将异常归结为五种高层行为模式,提出了一套 神经符号诊断框架。它利用 LLM 将轨迹 $\tau$ 整合成规则化节点:Node_t = {Intent(意图), Pre-condition(前置观测状态), Action(调用的工具/发出的指令), Post-condition(执行后状态变化)},然后对 Agent 进行规范化定义,自动生成一组神经不变量断言,后再基于这组轨迹,利用 Critic LLM 进行判定,直接映射对应节点的故障模式。
故障归因
大致分为三种归因方法。
数据驱动归因
数据驱动归因截至目前,大致经历了四个阶段,首先是类似 Who&When 这种的直接将错误日志扁平化交给大模型去处理,让他来查看哪里错了。接着 AGENTRACER 和 AEGIS 通过在成功日志里注入错误轨迹、在错误日志里进行节点修复的方法,通过强化学习训练来针对性地训练出归因小模型。然后 Spectrum、CORRECT、GraphTracer 利用图结构或者结构日志方便大模型进行解析判断。最后,AgentAsk、Trajectory Graph Copilot、Trajectory Guard 都通过训练小模型或编码器来对 Agent 的下一步动作进行判断,如果决策模型认为该行为错误或者不对,那就打回重做。
由于小模型的输出速率不一定很快,这里的决策模型可以训练一个专门针对决策(类似 Jev)的模型,或者像 Trajectory Guard 训练编码器 GRU。
约束引导方法
数据驱动的方法基本上需要微调或训练小模型来达到效果,我们可以通过对日志进行约束读取,进而缩小搜索范围来进行定位。
对错误日志进行约束,目前分为两大类:分阶段规则重构并收缩归因搜索空间、显式约束与主动干预。
SDBL 通过两种策略来缩小搜索范围,一种策略是将上下文或日志分成若干 chunk,通过 Judge LLM 来进行读取判断,从而确定一些嫌疑区间;二是预先提取常见多智能体协作模式的先验规则,形如:
表 5. 根据报错特征和经验规则锁定嫌疑区间的示例。
Table 5
| 最终报错特征 | 专家经验先验规则 | 直接锁定的嫌疑区间 |
|---|---|---|
| 逻辑断言失败 / 业务数值不符 | 属于业务核心逻辑错误,与前端 UI、环境打包无关 | 锁定在后端核心代码实现与计算逻辑区间 |
| 代码 SyntaxError 语法报错 | 编译期错误,说明最后一次修改代码后没通过语法检查 | 锁定在最后一次代码生成与代码审查交互区间 |
| 需求跑偏 / 答非所问 | 顶层意图理解偏差 | 锁定在开头的 PM 任务拆解区间 |
DoVer 提出了一个非常犀利的观点:光看静态日志做归因本质上是一个病态问题,它产出的结果只能算未经验证的猜想。因此,DoVer 将归因升级为一个 “先生成猜想 $\to$ 主动修改系统重放 $\to$ 根据重放结果验证猜想” 的闭环自动调试器。具体实现为由 LLM 读取失败轨迹后,生成 $K$ 个候选故障假设,然后根据这些故障假设,回滚到当时的状态重新运行,如果这次成功则会成功定位到错误。
DoVer 的优势更在于,针对于这若干个候选集,它可能不单单是抓出一个错误,很有可能是 Planner 描述不清、导致 Worker 执行不对、Reviewer 审查边界不足,所以这可以将三个错误的情况都抓住。缺点就是成本较高,因为需要重放流程。
因果推断方法
数据驱动的方法通过错误相关性(如果在某个节点重放成功了,那么归因到该节点)来进行归因判断,约束引导通过强制约束(即出错或违规的一步);这两种方法本质没有解决致命归因,即真正导致出错的节点,可能某个节点是违规了,但并非致命因,因果推断方法致力于解决归因到致命节点。
SCM 模型:一个完整的 SCM 由四个部分组成,通常记作四元组 $\mathcal{M} = \langle U, V, F, P(U) \rangle$。其中
- $V$ 是内生变量,可以理解为模型内部的局部变量,是我们可以直接观察到、关心且互相影响的变量。
- $U$ 是外生变量,这是由环境外部决定的、不受系统任何变量影响的底层因素。
- $F$ 是结构方程,表示不可逆的因果生成过程。对于每一个内生变量 $V_i$,都有一个确定性的函数 $f_i$:
在 SCM 看来,没有所谓的黑盒机制,所谓的随机单纯是因为你不知道 $U$ 的值。在 Agent 系统中,策略输出各个动作的对数概率 $\log P(a \mid s)$。在 SCM 里,使用 Gumbel-Max Trick 将其改写为确定性方程:
通过引入外生变量 $U$ 将一切随机分布剥离到系统外部,把系统内部转化为由确定性函数 $F$ 驱动的“有向代码图”,从而赋予我们在系统任意节点锁定历史随机种子重演历史(反事实推理,通过固定外生变量)的数学能力。
决策的因果效应为底座
Agent-Specific Effects 利用结构因果模型(SCM),从已经发生的失败轨迹 $\tau$ 中,反推出当时发生的所有外生随机变量 $u$。将时间倒流回第 $t$ 步,强制把智能体 $i$ 的错误动作 $a_{i,t}$ 替换为正确的备选动作 $a'_{i,t}$,随后在 $t' > t$ 的推演中分两种情况处理:
- 目标队友集合 $C$(要测试的受影响群体):允许它们看到智能体 $i$ 修改动作后的新环境状态,并根据自己的策略做出新的动作反应。
- 非目标集合 $\mathcal{A} \setminus C$(其他无关队友):冻结。哪怕环境状态已经因为 $a'_{i,t}$ 发生了改变,系统依然使用原失败轨迹 $\tau$ 里的老观测数据,或者直接强制它们执行原失败轨迹 $\tau$ 里的老动作。
由此来计算差值
若 $\text{Cf-ASE}_C$ 值很大,那么意味着该节点使得整个任务出现错误,以此达到归因的目的。该方法依然有只能定位一处关键节点的局限性,并不能解决多归因问题。
MMDP-SCM 定义了总反事实效应 TCFE:
- $\mathbb{E}[Y_{a_{i,t}} \mid \tau]_{\mathcal{M}}$ 是将第 $t$ 步动作改为 $\text{do}(A_{i,t} := a_{i,t})$ 后得到的期望值。
- $\tau(Y)$ 指的是真实轨迹得到的结果。
作者将 TCFE 拆解为两项之和:
其中 TCFE 可以求出,且等式右侧第二项可以通过冻结时间步 $t'>t$ 后的动作,修改 $t$ 时间步的动作 $a'_{i,t}$ 得到。那么此时等式右侧第一项也自然得出来了。
MMDP-SCM 通过利用博弈论中的 Shapley Value(夏普利值)来对下游的子 Agent 进行分权重归因;遍历所有可能的目标队友组合 $C$,计算某个队友 $j$ 加入解冻集合前后的边际效应贡献:
其中 $\sum_{j=1}^n \phi_j =\text{Effect}_{\text{Agent-Propagation}}$;可以理解为在 $C$ 已经改变行为的基础上,让智能体 $j$ 也改变行为,最后的结果会改变多少。遍历所有可能的 $C$,就是智能体 $j$ 的夏普利值 $\phi_j$。
上述讲的是归因于不同的智能体,接下来是对当前的环境进行归因。由于我们不可以直接修改环境变量,因为这不符合物理转移规律,作者首先计算方差缩减量 $\text{ICC}(S_k)$:
然后按方差缩减比例分锅,得到状态 $S_k$ 的归因得分 $\psi_{S_k}$:
其中 $\sum_{k=t+1}^{h} \text{ICC}(S_k) = \text{Var}(\Delta Y \mid \tau)$;$\psi_{S_k}$ 表示了哪一步的状态转移 $S_k$ 决定了最多的结果波动。
EMAI 定义一个掩码向量 $m_{i,t} \in \{0, 1\}$,利用强化学习(这里使用的是 QMIX)去优化整体多智能体框架,损失函数为:
当 $m_{i,t} = 1$ 时,智能体 $i$ 正常工作,反之冻结。损失函数非常巧妙,为了最小化损失,必须使无关紧要的智能体 $m_{i,t}=0$,这样才能确保权重较大的智能体正常工作,使得 $\left| R(\tau_{\text{normal}}) - R(\tau_{\text{masked by }\phi}) \right|$ 尽可能小,其中 $R(\tau_{\text{masked by }\phi})$ 是指被当前策略屏蔽后的得分。
个人认为该工作目前没有进入到基于 LLM 的 MAS 系统领域,是有待发掘的一部分,这里留个 CheckPoint。
从 MAS 执行日志中恢复因果图与多粒度溯源
CHIEF 将轨迹 $\tau$ 构建成“子任务 $\to$ 智能体 $\mathcal{A}$ $\to$ 状态步 $S_k$”三层因果图,为每个节点自动合成虚拟契约标准 $\mathcal{O}$(包含前置条件 $\mathcal{P}_{\text{pre}}$ 和验收标准 $\mathcal{C}_{\text{acc}}$),定义二元检测掩码 $m_{j,k} \in \{0, 1\}$:
自顶向下把 $m=1$ 的分支剪枝跳过,只针对 $m = 0$ 的分支展开回溯。
对于第 $k$ 个异常步 $S_k$,不直接惩罚该状态,先检查因果图中指向 $S_k$ 的上层节点集合是否有损坏,由此定义状态 $S_k$ 的真实根因归因 $\psi_{S_k}$:
如果存在某个 $S_p \in \text{Pa}(S_k)$ 使得 $m_p = 0$,则 $\prod m_p = 0 \implies \psi_{S_k} = 0$,这表示第 $k$ 步大概率是被上层带偏的。相反,当不存在上游为 $0$ 的节点时,那么会有 $\psi_{S_k} = 1$,说明 $S_k$ 是归因的高权重节点。
AgentTrace 抛弃了重采样和 LLM 裁判,从报错终端状态 $S_h$ 逆向做广度优先搜索。它设计了五个状态特征:
- $F_p(S_k)$ 为位置特征,权重较大,因为越靠前的状态对后续决策的影响越大;
- $F_s(S_k)$ 为图结构特征,节点 $S_k$ 在数据依赖图中的出度 $\text{deg}^+(S_k)$(即下游有多少智能体与当前节点有关联),出度越大,说明它很重要;
- $F_c(S_k)$ 为内容统计特征,表示当前步输出长度偏离均值程度与报错关键词统计;
- $F_f(S_k)$ 为因果流距离,表示从 $S_k$ 到最终崩溃状态 $S_h$ 的最短依赖路径步数;
- $F_e(S_k)$ 为模型内生置信度,智能体生成该步动作时的 Token 平均对数概率(Log-probs 熵值),模型越犹豫(熵越高),该步越可能是故障引爆点。
计算任意状态步 $S_k$ 的归因得分 $\psi_{S_k}$:
其中每个维度的特征都经过轨迹 $\tau$ 内的最大最小归一化:
Think:
回看
EMAI损失函数:$$ \mathcal{L}(\phi) = \left\vert{} R(\tau_{\text{normal}}) - R(\tau_{\text{masked by }\phi}) \right\vert{} + \lambda \|m\|_1 $$之前我们讨论过,
EMAI最大的痛点是掩码网络 $\phi$ 从零训练太慢、太贵。也许可以利用 $\mathbf{F}(S_k) = [F_p, F_s, F_c, F_f, F_e]$ 作为EMAI掩码网络 $\phi$ 的输入特征,去输出掩码权重 $m_{j,k} = \sigma(\phi^\top \mathbf{F}(S_k)) \in [0, 1]$。这样一来,掩码网络 $\phi$ 只有 5 个标量权重参数(或者一个极小的两层 MLP),在 GRPO 训练时几步就能瞬间收敛;
多智能体自进化
这一部分仍然是有待发掘的领域,能够很好地配合归因方法进行迭代更新的 RSI 智能体工作流很少。我这里只选取部分个人认为有代表性的。
系统级进化
它的核心形式化映射是针对以下三个集体组织目标进行跨代更新:
其中 $\mathcal{A}^{(k)}$ 为智能体集合、$\mathcal{G}^{(k)} = (\mathcal{A}^{(k)}, \mathcal{E}_c^{(k)})$ 为通信拓扑图、$\Gamma_{\text{systemic}}$ 为进化算子。
Puppeteer 设一个中心编排控制器 $\pi_\omega$,每一步根据当前状态 $S_t$ 动态决定下一个激活哪个智能体,利用 RL:
EvoMAC 将第 $k$ 代多智能体系统定义为一个拓扑图:
其中 $\mathcal{A}_C^{(k)} = \{a_1^{(k)}, \dots, a_N^{(k)}\}$ 是智能体集合,每个智能体由 $p_j^{(k)}$ 驱动;由于没有测试脚本来计算 $R(\tau)$,论文通过基于 LLM 的测试团队 $\mathcal{A}_T$ 编写出测试套件 $Y_{\text{test}}$,那么就可以得到客观的文本损失:
通过 TextGrad 的思想进行反向传播更新提示词、增删改智能体的通信路线:
ANN 在 EvoMAC 基础上,将 MAS 系统化为 $L$ 层的前馈神经网络层:$\mathcal{A} = \{\mathcal{A}_1, \mathcal{A}_2, \dots, \mathcal{A}_L\}$,每一层 $\mathcal{A}_\ell$ 一个负责特定子任务的协作小分队,配有层间聚合函数 $f_\ell$;在反向传播阶段同时计算全局层间梯度 $\nabla_{\text{global}} \mathcal{G}$(调整层与层之间的任务分解和聚合方式 $f_\ell$)和局部层内梯度 $\nabla_{\text{local}} a_{j,\ell}$(调整该层智能体角色的增删改)。
评论