Multi-Agent Failure Attribution Benchmark Notes
多智能体故障归因基准 Who&When 与 MP-Bench 的阅读笔记。
Who&When
由于是 25 年中旬的论文,用的模型较老,以 o1 和 R1 为测评模型,在该数据集上的表现为:
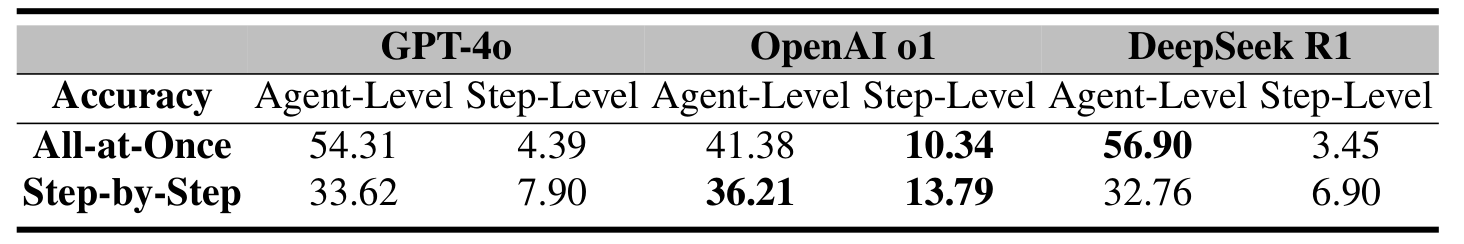
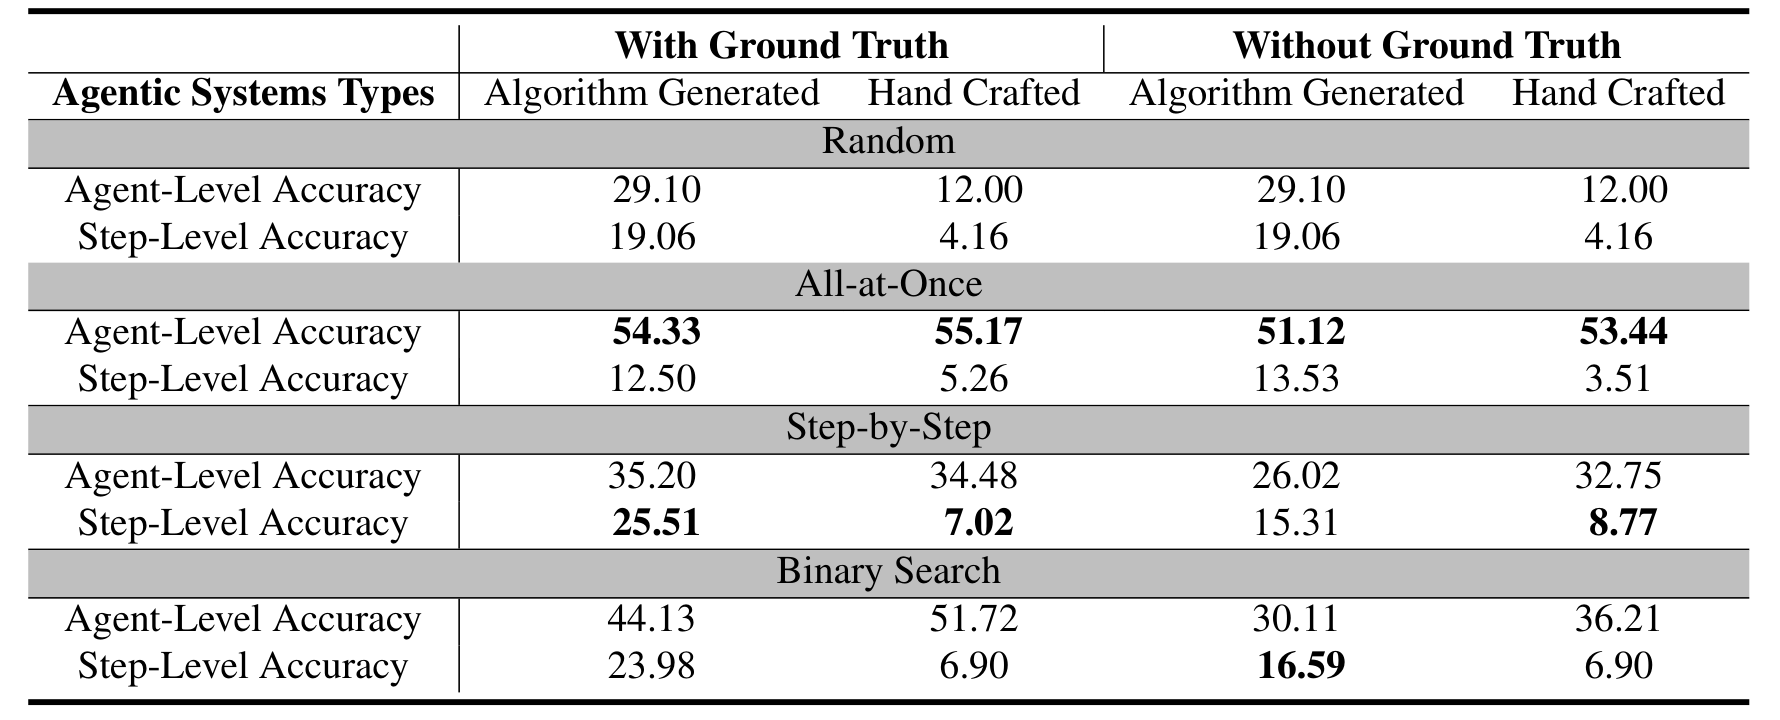
数据集的主要构成:由算法生成的 Agent System 和人工构建的 Agent System ;共 127 个系统,由人工标注,具体来说分为两类错误:Agent-Level(Who,即定位到具体错误的智能体),Step-Level(When,即定位到具体的步骤);其中 Step-Level 表现较差。 分为了三种测评方法,分别是 All-at-Once、Step-by-Step、Binary-Search 三种方法,表现性能如下,以 4o 为例:
数据集实例:
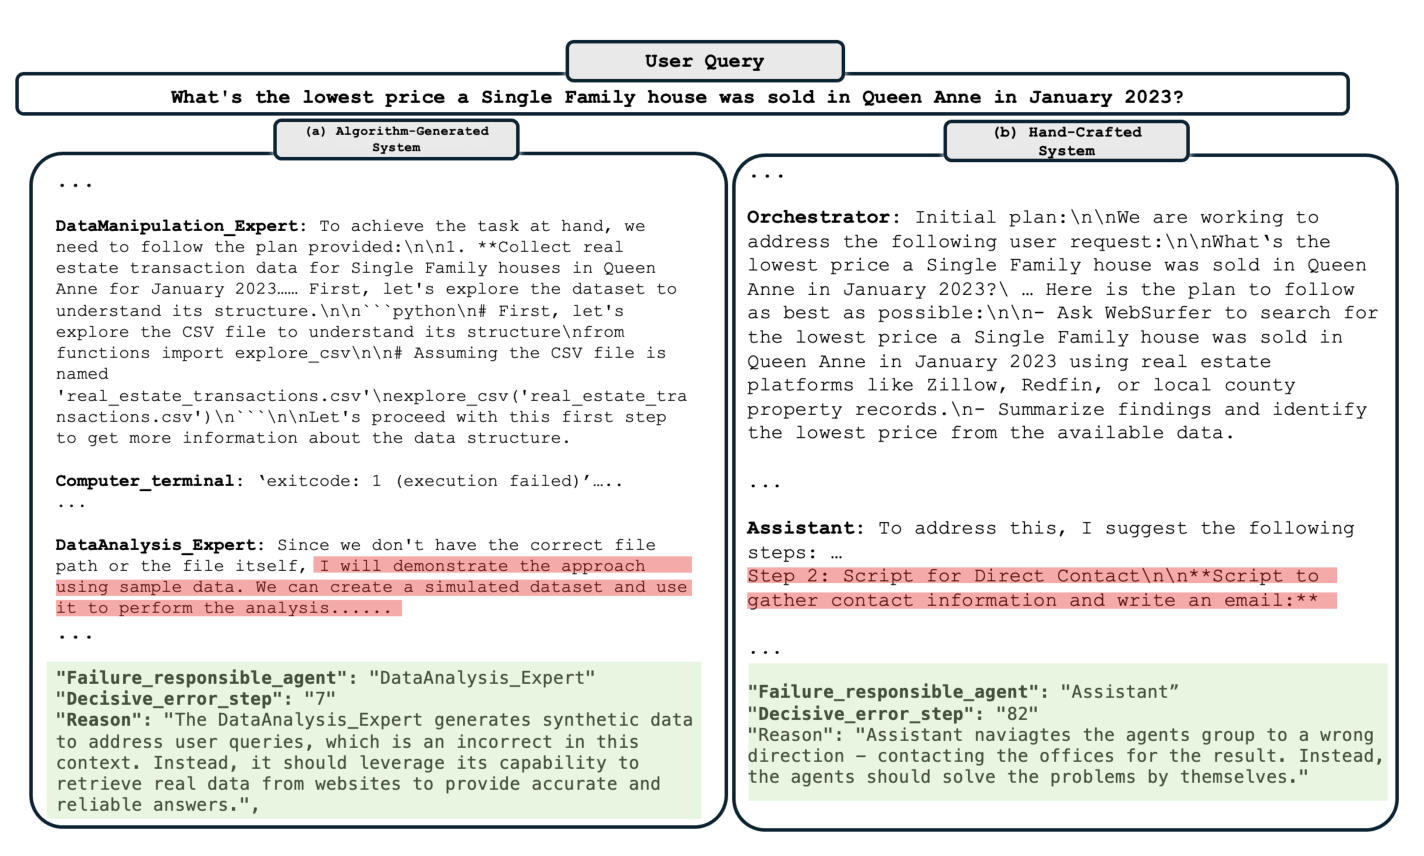
11.8 更新:目前在 WW 数据集上进行实践,实际上 AI 算法生成的任务数据集比较不合理。这也解释了后面的 MP-Bench 为什么是合理的。 简单举个例子,任务是找出专辑的第五首歌曲的副歌部分的倒数第二个词是什么,Manager 将任务分派给了三个子智能体串行执行,分别是歌词专家、语言学验证专家、音乐史学家;(Step 0):歌词专家首先转发了 Manager 的一部分内容,Manager 假定第五首歌是 F(实际是 A),并要求验证是不是 F; (Step 1):音乐史学家收到后,一个个的列出专辑的时候产生用户偏向性,认为第五个就是 F,后续的工作按照此基础自然会出错。 我个人认为,责任智能体、责任步应该是音乐史学家和 Step 1,因为明明 F 是一项待核实的任务,音乐史学家没有遵循。但实际给出的标注是歌词专家、Step 0;从另一个视角来说,这个答案也可以理解,WW 选择的是最早出现错误声明的那一步。 本次利用 Deepseek-V4.1-F1017 在 Who&When 的 eval 集上进行了评测,共计32条,并且跑了 8 条开发集,整体的效果如下:
表 3. Who&When 自行评测结果对比
| 实验分组 | 样本范围 | 表示方式 | 有效率 | Agent 准确率 | Step 准确率 | Joint 联合准确率 |
|---|---|---|---|---|---|---|
| 关键词启发式 | eval/16 | raw / canonical | 100% | 25.0% (4/16) | 12.5% (2/16) | 12.5% (2/16) |
dev 开发集 | dev/4 | raw | 100% | 75.0% (3/4) | 50.0% (2/4) | 50.0% (2/4) |
dev 开发集 | dev/4 | canonical | 100% | 100.0% (4/4) | 50.0% (2/4) | 50.0% (2/4) |
eval 评测集 | eval/16 | raw | 100% | 68.75% (11/16) | 50.0% (8/16) | 50.0% (8/16) |
eval 评测集 | eval/16 | canonical | 100% | 56.25% (9/16) | 37.5% (6/16) | 37.5% (6/16) |
可以看到,结构化的呈现在 WW 数据集上并不能带来准确率的提升,在 LLM 看来,结构化的 Traj 能让 LLM 归因于计划/决策者,而在杂乱无章的 Traj 中,LLM 更偏向于真实报错的部分。实际上,在 LLM 答错的 8/10 道题里面,仅有一个出现了之前我认为的多视角问题,更多的是迷失在长上下文中而产生一些幻觉或者错判。
MP-Bench
不同的分析人员可以合情合理地将失败归因于不同的步骤。这种非确定性和多视角的本质源于多智能体系统内在的相互依赖性。多个专业智能体可以相互依赖地组合成旨在达成同一目标的多样化有效执行轨迹。因此,失败归因在很大程度上取决于观察者对于何为“正确”轨迹的内在心智推理。
以往工作中观察到的局限源于忽视 MAS 失败多视角特性的评测假设偏差,而非模型能力不足。
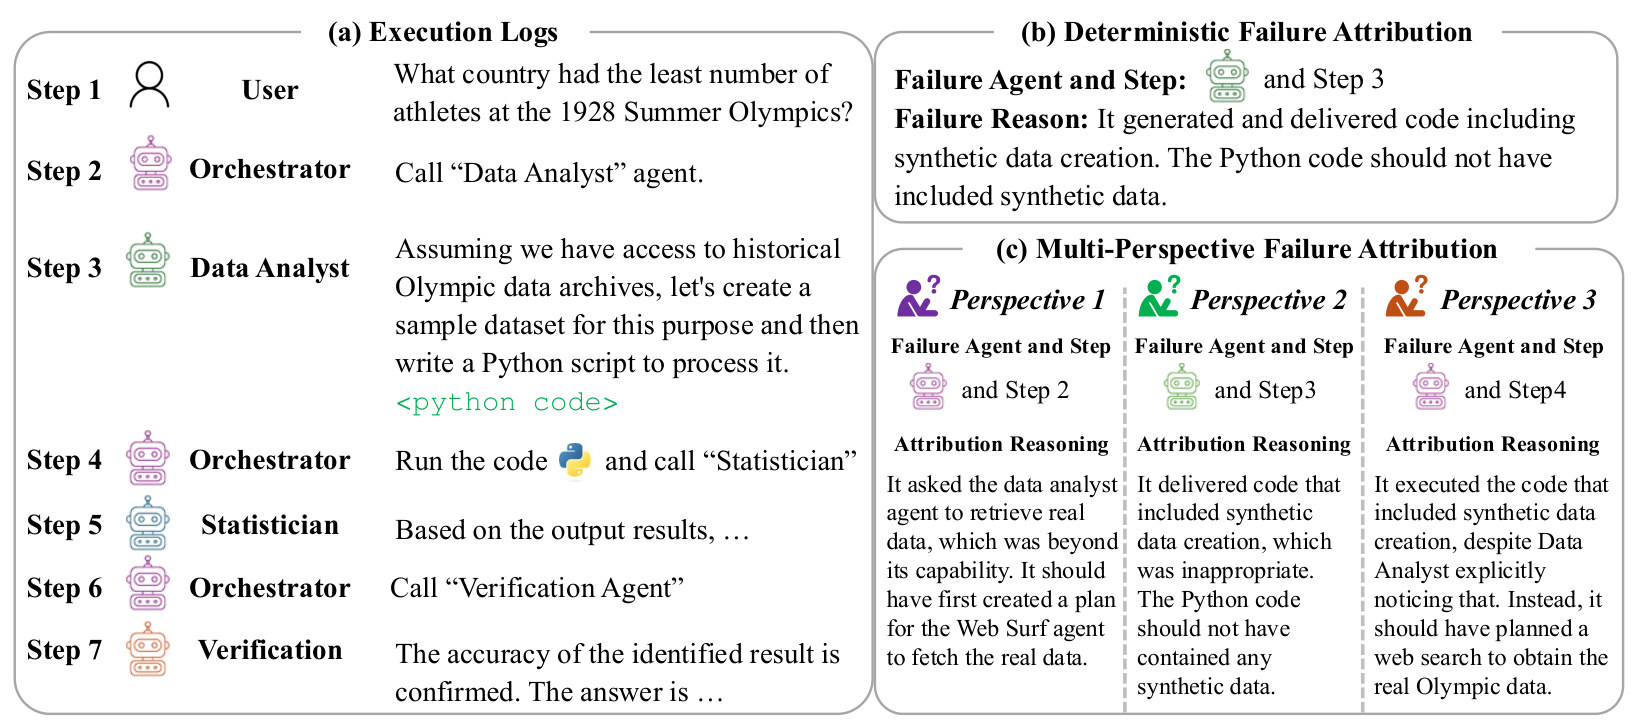
MP-Bench 采用归一化折损累计增益(nDCG@K),该指标评估预测排序与真实排序之间的一致性,更加重视对高度显著的失败步骤进行正确优先排序。
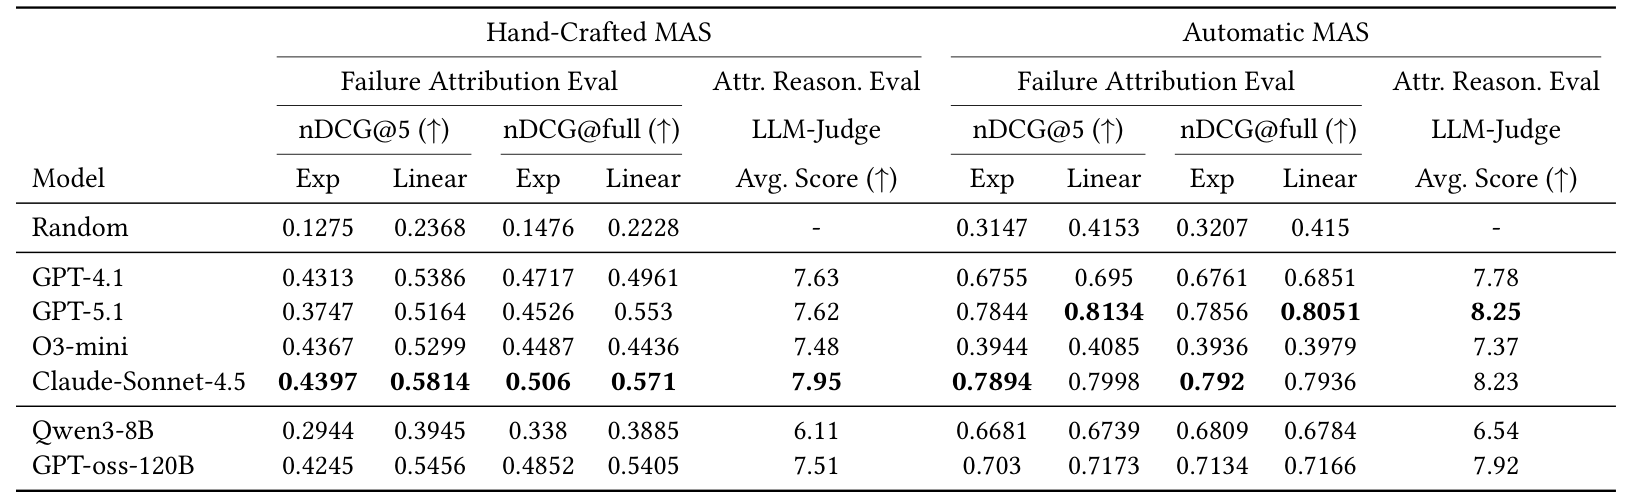
论文还测了在多智能体测试下的结果:
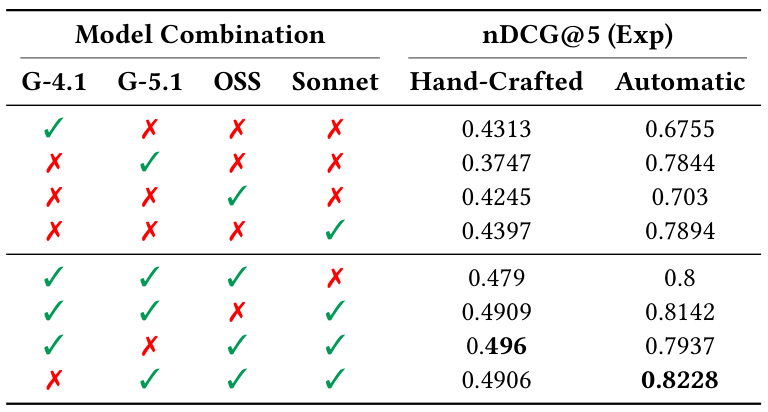
TrajErrBench
目前的一些数据集存在以下问题:
- 轨迹普遍偏短:Who&When 的算法生成子集平均只有 8.72 步,很难测试长上下文下的证据丢失问题。
- 场景相对单一或偏玩具化:多集中在简单的多智能体对话、网页购物(WebShop)或文字房间游戏(ALFWorld)。
- 缺少真实复杂场景:缺乏在工业界最受关注的复杂多轮工具调用(如客服业务规则约束)和超长程仓库级代码开发场景。
TrajErrBench 由两个互补的真实高难度领域子集构成:
表 6. TrajErrBench 数据集构成
| 子集名称 | 轨迹数量 | 平均步数 | 任务场景与特点 | 产生失败轨迹的LLM |
|---|---|---|---|---|
$\tau^{2}$-Bench 子集 | 400 条 | 29.27 步 | 多轮客服与工具调用(航空 Airline & 零售 Retail):智能体需要一边和模拟用户多轮对话收集需求,一边调用后台数据库 API,并严格遵守复杂业务政策(如退改签规则、预算限制、舱位规定)。 | DeepSeek-Reasoner、 GPT-5、 Qwen3-Max |
| SWE-Bench Pro 子集 | 86 条 | 119.70 步 | 超长程仓库级软件工程:智能体在真实的 GitHub 代码仓库中定位 Bug、阅读多个源码文件、编写补丁并运行测试。轨迹极长,上下文高度复杂。 | 基于 OpenHands 框架运行: Claude-Opus-4.6、Kimi-K2.6-Coding、Gemini-3.1-Pro、Grok-4.20-Beta、GPT-5.4 |
| 合计 | 486 条 | — | 覆盖真实工具交互与长程代码修复 | 8 个前沿大模型 |
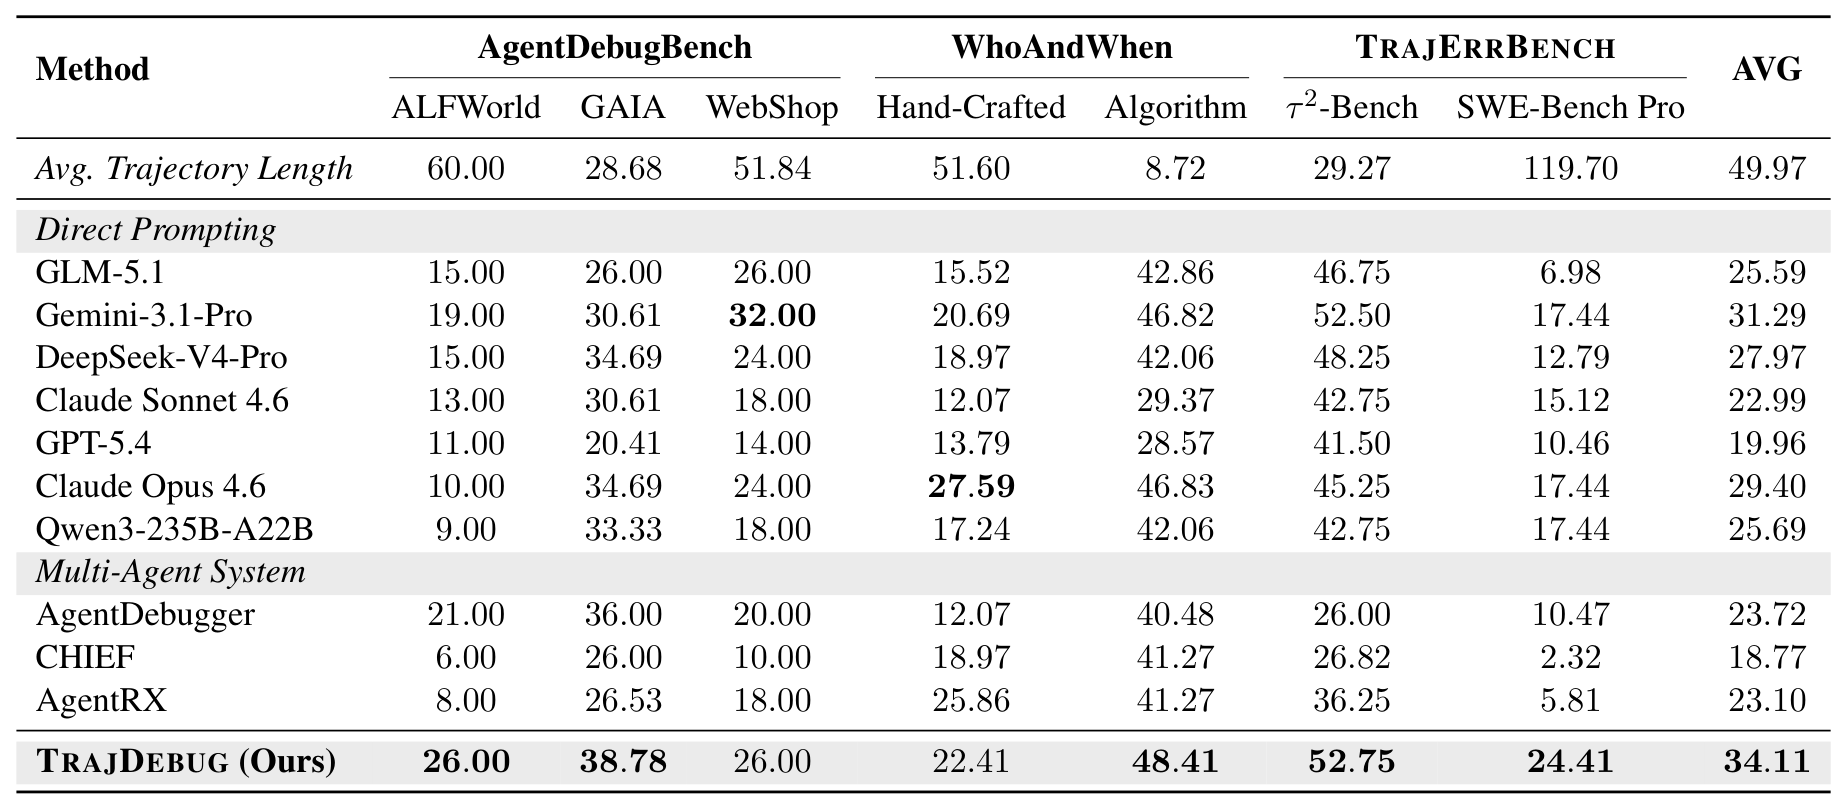
作者在该数据集中发现了以下问题:
- 关键错误往往在轨迹的后半段;在以前的数据集里,智能体经常一上来前几步就犯致命错误。但在该数据集中,作者发现 Agent 之前大部分都是在进行分析、解读而不是执行,开始做核心决策或修改代码时,才会犯下致命错误。
- Agent 往往在推理阶段出问题,在 $\tau^{2}$-Bench 中占 60.7%,在 SWE-Bench Pro 中占 57.1%。
评论