LoRA
LoRA 学习笔记:低秩更新、参数量、缩放、初始化及常见变体。
直接微调整个模型需要大量的计算资源和显存。对于 Qwen3-0.6B(0.6B 参数),全量微调的显存需求不能只看 FP16 或 FP32,还取决于优化器、序列长度、批大小,以及是否使用梯度检查点或卸载等技术。对于更大的模型(如 7B、13B),在单张消费级 GPU 上全量微调通常会更困难。
LoRA(Low-Rank Adaptation)是一种参数高效微调方法,它只训练少量的额外参数,而保持原模型参数冻结。LoRA 的核心思想是:模型微调时的参数变化可以用低秩矩阵表示。
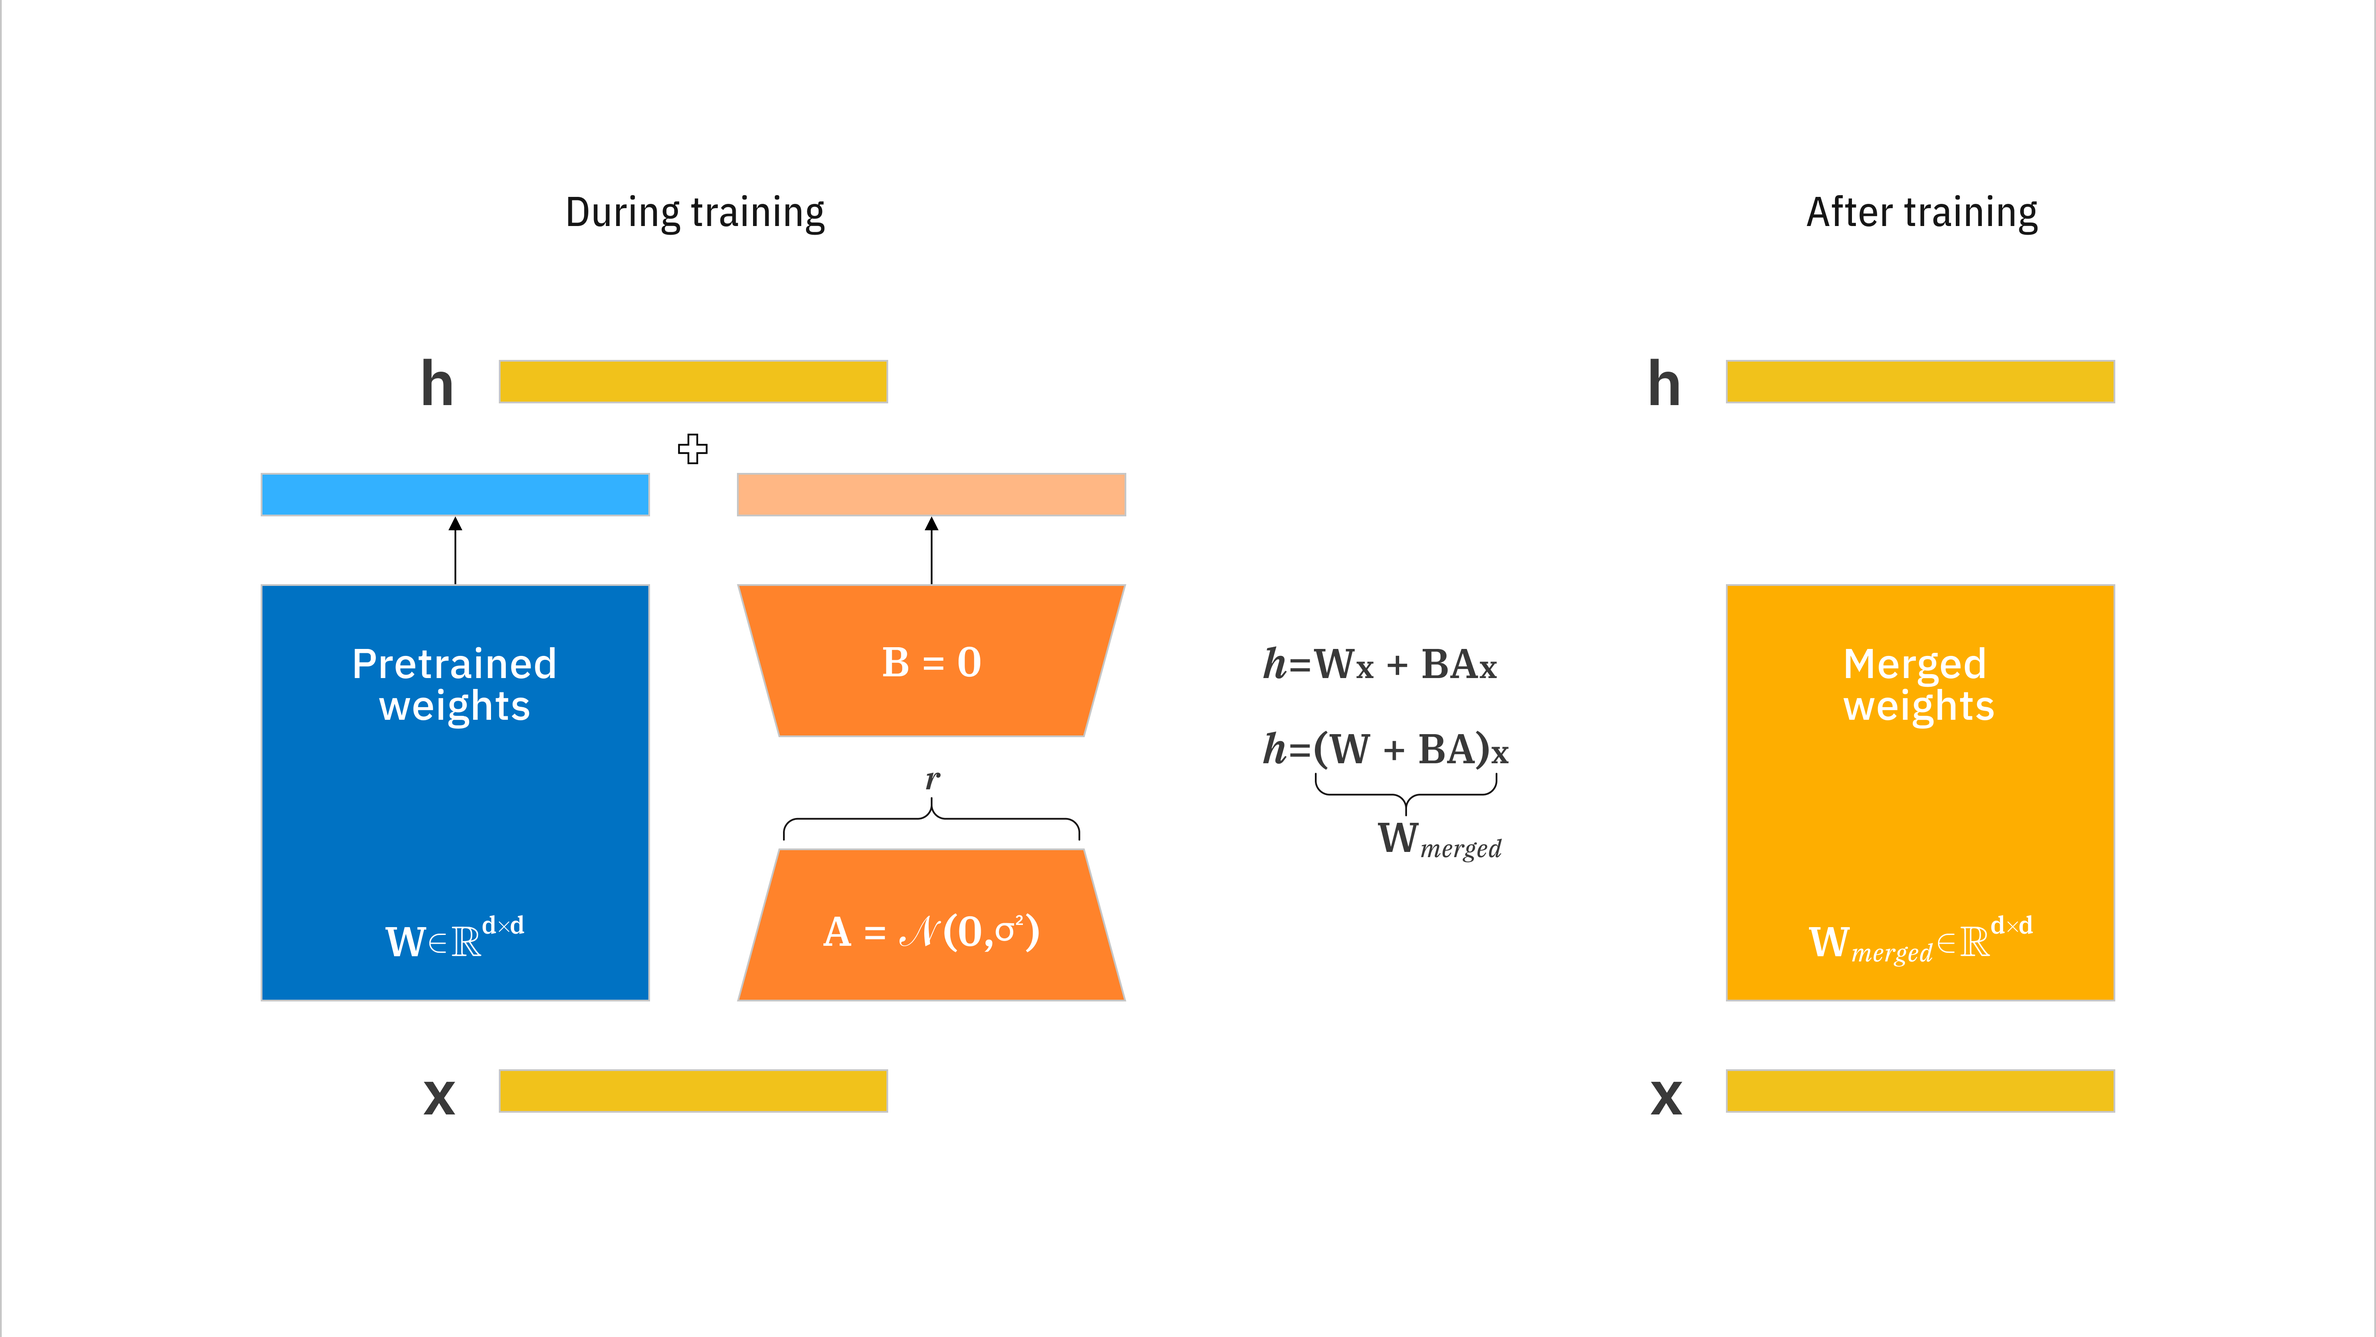
图源:IBM。
低秩更新与参数量
假设原模型的权重矩阵为 $W \in \mathbb{R}^{d \times k}$,微调后的权重为 $W' = W + \Delta W$。LoRA 假设 $\Delta W$ 可以分解为两个低秩矩阵的乘积:
$$ \Delta W = BA $$其中 $B \in \mathbb{R}^{d \times r}$, $A \in \mathbb{R}^{r \times k}$, $r \ll \min(d, k)$ 是秩(rank)。
前向传播时,输出为:
$$ h = Wx + \Delta Wx = Wx + BAx $$原模型参数 $W$ 保持冻结,只训练 $B$ 和 $A$。
参数量对比:原模型参数量为 $d \times k$,LoRA 参数量为 $d \times r + r \times k = r(d + k)$。当 $r \ll \min(d, k)$ 时,LoRA 参数量远小于原模型。例如,对于 $d=4096, k=4096, r=8$ 的情况,原模型参数量为 $4096 \times 4096 = 16,777,216$,LoRA 参数量为 $8 \times (4096 + 4096) = 65,536$,参数量减少了 256 倍!
这个降幅来自参数计数:可训练矩阵的每个元素贡献一个标量参数。对于正整数维度 $d,k,r$,乘积矩阵的秩至多为 $r$,未必恰好等于 $r$。对这一个权重矩阵,可训练参数量与全量参数量之比为:
$$ \begin{aligned}\frac{\text{LoRA parameters}}{\text{full parameters}}&=\frac{dr+rk}{dk} =\frac{r(d+k)}{dk} =r\left(\frac1k+\frac1d\right),\\\frac{8(4096+4096)}{4096\cdot4096}&=\frac{65{,}536}{16{,}777{,}216} =\frac1{256}=0.00390625,\\\frac{16{,}777{,}216}{65{,}536}&=256.\end{aligned} $$直观地说,两个窄矩阵替代了一个稠密的可训练更新。冻结的基座权重和激活仍占显存;这个比例不意味着总显存或运行时间也降低 256 倍。偏置及其他额外训练的模块还需另行计数。
秩的含义
这约束的是更新的可表示范围,并非断言每个有效的全量微调更新都具有低秩。选定的秩是否足够,取决于任务和所适配的层,应通过验证判断,不能只看参数量。
全量微调允许这个权重矩阵在参数空间中自由变化,而 LoRA 要求变化量满足:
$$ \Delta W=BA $$这带来一个数学限制:
$$ \operatorname{rank}(\Delta W) = \operatorname{rank}(BA) \leq r $$当 $r=8$ 时,无论怎样训练 $A,B$,最终得到的更新矩阵的秩都不会超过 $8$。可以从输入到输出的过程理解:
$$ x\in\mathbb{R}^{4096} \ \xrightarrow{A}\ z\in\mathbb{R}^{8} \ \xrightarrow{B}\ \Delta h\in\mathbb{R}^{4096} $$设 $B$ 的 8 列分别是 $\mathbf b_1,\ldots,\mathbf b_8$,那么:
$$ \Delta h=Bz =z_1\mathbf b_1+z_2\mathbf b_2+\cdots+z_8\mathbf b_8 $$这意味着:对这个训练好的 LoRA 分支,不同输入产生的输出修正,都由最多 8 个独立方向组合而成。其中:
- $A$ 根据输入决定每个方向使用多少,也就是计算 $z_1,\ldots,z_8$。
- $B$ 提供这些可以组合的输出方向。
- 训练过程中,$A$ 和 $B$ 都会学习,所以这些方向并不是预先固定死的。
原始 $W$ 可以是满秩的,加上低秩更新以后,$W'$ 仍然可以是满秩的。
| $r$ 的选择 | 可训练参数 | 能表示的更新范围 | 实际效果 |
|---|---|---|---|
| 较小 | 较少 | 限制较强 | 可能足够,也可能欠拟合 |
| 较大 | 较多 | 范围更广 | 可能改善,也可能收益很小或泛化变差 |
因此,LoRA 的主要优势是减少可训练参数及其优化器状态,并便于保存和部署适配器。实际显存、训练速度、过拟合程度,以及相对全量微调的效果,仍取决于任务和配置。
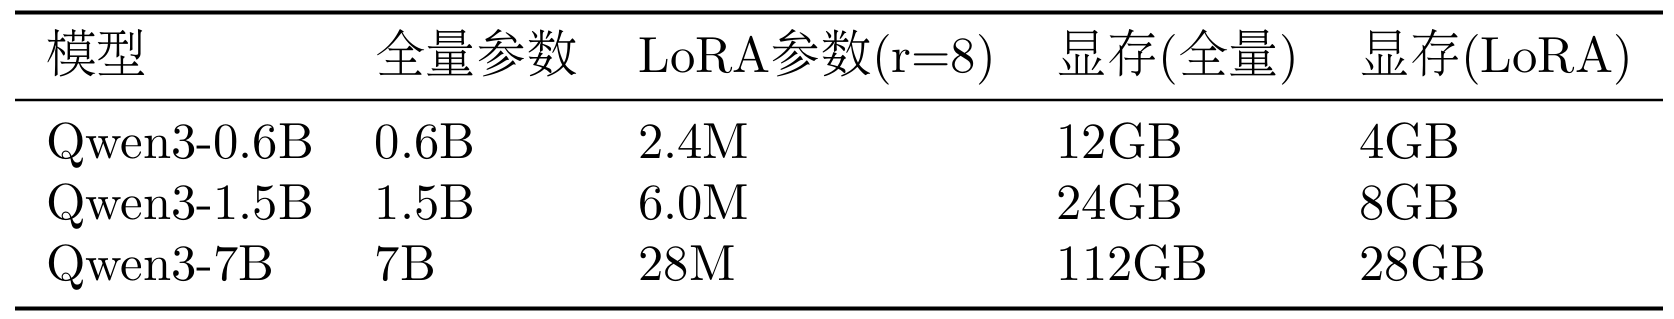
如表所示,这是原学习材料中不同模型规模下的参数量和显存对比示意。表里的显存数字依赖具体训练配置,不是固定要求。
超参数与缩放
LoRA 的关键超参数包括:秩(rank,r),控制 LoRA 矩阵的秩,越大表达能力越强,但参数量也越多,典型值为 4-64,默认 8;Alpha($\alpha$),LoRA 的缩放因子,实际更新为 $\Delta W = \frac{\alpha}{r} BA$,控制 LoRA 的影响强度,典型值等于 rank;目标模块(target_modules),指定哪些层应用 LoRA,通常选择注意力层(q_proj, k_proj, v_proj, o_proj),也可以包括 MLP 层(gate_proj, up_proj, down_proj)。
把缩放写作 $c_{\mathrm{LoRA}}=\alpha/r$,其中 $\alpha>0$。为说明除以秩补偿的是什么,设 $z_j$ 为 $BA$ 某个固定元素中的独立标量贡献,索引为 $j=1,\ldots,r$,各项具有共同均值 $\mu\in\mathbb R$ 和方差 $\sigma^2>0$,且两者都不随 $r$ 改变。固定 $\alpha$ 时,利用期望的线性性与方差相加,得到:
$$ \begin{aligned}\mathbb E\left[\frac{\alpha}{r}\sum_{j=1}^{r}z_j\right]&=\frac{\alpha}{r}\sum_{j=1}^{r}\mu=\alpha\mu,\\\operatorname{Var}\left(\frac{\alpha}{r}\sum_{j=1}^{r}z_j\right)&=\frac{\alpha^2}{r^2}\sum_{j=1}^{r}\sigma^2 =\frac{\alpha^2\sigma^2}{r},\\\operatorname{Var}\left(\frac{\alpha}{\sqrt r}\sum_{j=1}^{r}z_j\right)&=\alpha^2\sigma^2.\end{aligned} $$因子 $1/r$ 把求和变成平均,在上述假设下抵消了均值随分量数量增加而增长的部分。这说明的是均值层面的补偿。方差仍随 $r$ 改变,因此更新幅度或范数未必保持不变。训练后的分量,其均值、方差或相关性都可能随秩改变;下述初始化的更新则恰好为零。让 $\alpha$ 与 $r$ 成正比,只能保持 $c_{\mathrm{LoRA}}$ 固定,不能保持学到的更新固定。初始化、学习率和优化器状态也会影响训练。
| 缩放方式 | 期望 | 方差 |
|---|---|---|
| $\dfrac{\alpha}{r}\sum z_j$ | $\alpha\mu$ | $\dfrac{\alpha^2\sigma^2}{r}$ |
| $\dfrac{\alpha}{\sqrt r}\sum z_j$ | $\alpha\sqrt r\,\mu$ | $\alpha^2\sigma^2$ |
在这套假设(各项独立,而且 $\mu,\sigma^2$ 不随 $r$ 改变)下,除以 $r$ 稳定的是均值,除以 $\sqrt r$ 稳定的是方差。
初始化与权重合并
采用 $A_0$ 随机初始化、$B_0=0$,并定义 $H_W=\partial\ell/\partial W^\prime\in\mathbb R^{d\times k}$。
$$ \begin{aligned} \Delta W_0&=c_{\mathrm{LoRA}}B_0A_0=0,\\ \frac{\partial\ell}{\partial A}&=c_{\mathrm{LoRA}}B^\top H_W\in\mathbb R^{r\times k},\\ \frac{\partial\ell}{\partial B}&=c_{\mathrm{LoRA}}H_WA^\top\in\mathbb R^{d\times r},\\ \left.\frac{\partial\ell}{\partial A}\right|_0&=0,\\ \left.\frac{\partial\ell}{\partial B}\right|_0&=c_{\mathrm{LoRA}}H_{W,0}A_0^\top. \end{aligned} $$模型初始时保持基座输出,同时只要梯度非零,$B$ 就能立即学习。$A$ 的首次任务损失梯度为零,但权重衰减仍可能改变它。若两个因子都初始化为零,两者的任务损失梯度都会受阻。
训练结束后,可以把权重合并为:
$$ W_{\mathrm{merged}}=W+c_{\mathrm{LoRA}}BA,\qquad h=W_{\mathrm{merged}}x. $$直观地说,合并把训练得到的修正折入一个权重矩阵,推理时便不再需要额外的适配器矩阵乘法。前文的 $BA$ 简写省略了缩放,或将 $c_{\mathrm{LoRA}}$ 吸收到一个因子中。代数等式要求适配器固定,并关闭任何 LoRA dropout。有限精度可能引入舍入差异;量化权重的合并可能需要反量化及重新量化。
关键技术变体:LoRA 家族的进化
QLoRA:量化版 LoRA,内存再减负
核心思想:将基础模型量化为 4-bit 精度(相比 16-bit,基座权重的存储位宽降为四分之一,但总显存还包括其他开销)
效果:在合适配置下,能在 24GB 显存的消费级显卡上微调 130 亿参数模型
LoRA+:差异化学习率
- 发现:LoRA的A矩阵(降维)和B矩阵(升维)重要性不同
- 改进:为 B 设置比 A 更大的学习率,即 $\eta_B/\eta_A>1$;具体比例取决于模型与任务,需要结合基础学习率调节。
AdaLoRA:智能分配“注意力预算”
- 问题:所有层都使用相同的秩r可能不是最优的
- 解决方案:动态为不同层分配不同的秩,相同参数量下,性能提升显著
评论