考研 408 笔记:数据结构、组成原理、操作系统与网络
数据结构、计算机组成原理、操作系统场景题与计算机网络的完整备考笔记。
这篇笔记整理备考中的概念辨析、例题、推导和复习提醒,并按主题安排标题与配图。阅读时结合每个结论所需的条件,以及题目给定的模型和数据。
- 数据结构
- 链表
- 并查集(代码, 优化操作, 根的合并可视化)
- Prim, Dijkstra 算法的非优先队列代码实现
- 十字链表与多重邻接表的模拟(会画)
- 堆代码的实现, 以及堆模拟优先队列代码的实现
- 红黑树(定义结论, 插入删除)
- 败者树与选择置换(败者树+序号), 败者树在归并中的作用, 以及败者树的深度
- 计算机组成原理
- 浮点数特殊值, 标志位生成
- 乘除法原理电路以及 Booth 乘除法的移动次数, 舍入
- 过程调用的过程, 栈帧以及各自的任务
- 多处理器, 现代处理器
- 袁书的单周期数据通路大汇总
- 操作系统
- 进程通信方式
- 资源分配图的简化与判断死锁条件
- 虚拟机, SPOOLing 的具体过程
- 文件系统挂载(mounting)
- 位示图, 成组链接法
- 多处理器调度
- 磨损均衡
- 计算机网络
- OSI, TCP/IP 各层作用与差异区别
- 物理层数字数据的线路编码方法,如曼彻斯特编码;同时区分模拟信号的调制表示。
- PPP, P2P 协议
- 虚电路
- OSPF, BGP, DHCP 的报文以及具体地址
- IP 多播过程以及 IGMP
- 海明码的校验与纠错
- 802.11 中预约的时间计算以及 NAV 值的计算
- 移动 IP
数据结构
需要记住的: 外部排序的各种实现过程; 三种线索二叉树; 十字链表与邻接多重表的适用范围与作用与画法; 会完整的写 Dijkstra、关键路径 的手算过程; 平衡树、红黑树、B树的增删; 败者树的序号以及在选择-置换排序的用法
栈与队列
- 链式队列和栈的插入、删除需要修改相应结点的链接字段以及队头、队尾或栈顶指针。队列从空变为非空时通常要同时设置队头和队尾。删除队列最后一个数据结点后,应同步恢复空队列的指针状态:无头结点时队头、队尾均为 NULL;有头结点时通常让队尾重新指向头结点。 栈的插入和删除则在栈顶完成。
- 前缀表达式中的逻辑只是把后缀表达式反过来, 即后缀表达式是从左到右进行转化的, 那么前缀表达式就正好相反, 这里举个手算过程的例子, 对于 ${((1 + 2) * 3) - (4 + 2)}$ 来说: 从左向右, 从内向外, 将运算符移动到前面, ${(1+2)}$ 变为 ${(+12)*3}$, 然后处理右侧 ${(4+2) \Rightarrow (+42)}$, 所以 ${((+12)*3)-(+42)\Rightarrow (*+123)-(+42)\Rightarrow -*+123+42}$, 对于计算机程序来说, 做的步骤如下:
- 反转中缀表达式。
- 将所有左括号
(换成右括号),将所有右括号)换成左括号(。 - 对反转后的记号序列使用中缀转后缀算法,以栈临时保存运算符;同优先级运算符的结合性处理也必须相应反转,不能照搬通常的出栈条件。多位数应作为一个完整记号进行反转。
- 将最终的结果再次反转,得到前缀表达式。 对于前缀和后缀来说, 转中缀的思路是一样的, 利用栈来保存操作数, 碰到运算符就依次出栈, 若是后缀表达式就从左往右, 若是前缀表达式就从右往左模拟
树结构
树的结构
- 设一个树中的最大度数为 ${max_d}$, 则节点总数 ${\displaystyle n=\sum_{i=0}^{max_d}n_i=\sum_{i=1}^{max_d}i\times n_i+1}$ 注意两个下标不一样
二叉树
- 对于关键字互异的二叉排序树,中序遍历得到严格递增序列;给定同一组关键字,该中序序列固定,但仅凭中序序列不能确定树的形态。含 $n$ 个结点的不带编号二叉树,其不同形态数为 $C_n=\frac1{n+1}C_{2n}^{n}$;若结点带互异编号且不同标号安排视作不同的树,则数量为 $C_n n!$。这两个公式统计树的形态或有标号的树。结点标识互异时,前序或后序序列与中序序列配合,可以唯一确定二叉树。
- 对于 ${n}$ 个节点的树转二叉树, 树的边数 ${w=n-1}$ 会被分为左指针和右指针, 左指针指向子节点, 右指针指向兄弟, 故有如下性质:
- 左指针数:每个非叶节点保留一条指向其第一个孩子的左指针,因此左指针条数等于非叶节点数
- 右指针数:其余边都用于兄弟关系,即右指针。
- 将含 $n$ 个结点的一棵有序树转换为左孩子、右兄弟二叉树时,根没有兄弟,因此根的右子树为空;其余 $n-1$ 个结点组成根的左子树。相应形态数为 $C_{n-1}$。这里减去的是根结点后的结点数,不能把树高代入卡特兰数公式。
- 对于森林转二叉树, 若森林存在 ${n}$ 个非终端节点, 那么对应的二叉树应有 ${n+1}$ 个节点无右儿子. 证明: 对于 ${x}$ 个根节点, 最右边的根节点一定没有右儿子, 对于 ${n}$ 个非终端节点, 类似与根节点, 每个非终端节点的儿子都会有一个最右儿子没有有兄弟节点, 故总计 ${n+1}$ 个
- 对二叉排序树进行中序遍历会得到升序序列(不是前序遍历)
- 二叉搜索树的查找过程是一个节点一个节点的比较, 并不是看树的高度或路径长度, 而是路径上经过了几个节点
- 树的路径长度定义为从根节点到所有节点的总长度之和, 那么若要求该树的路径长度最小, 每个节点都会尽可能地向上走, 而这恰恰符合了完全二叉树的定义, 因此完全二叉树有最小的路径长度;
- 二叉树或 B 树等, 若要寻找一个结点的前驱, 应是它的左子树中的最右节点, 但该节点可能没有左子树, 此时需要返回到父节点寻找前驱或后继;
- 线索二叉树
- 非空二叉链表中,$n$ 个结点共有 $2n$ 个孩子指针域,$n-1$ 条真实边占用相应指针,因此空指针域为 $2n-(n-1)=n+1$ 个。这些空域可以用作线索:空左指针指向前驱,空右指针指向后继。 对无额外头结点的非空中序线索二叉树,首结点没有前驱、尾结点没有后继,故有 $2$ 个空线索和 $n-1$ 个非空线索。前序、后序线索树的首尾结点可能已有真实孩子指针,应按具体结构重新计数。
- 线索二叉树使用二叉链表存储,构建时按所需次序遍历。若结点没有左孩子,把左指针设为前驱线索;若没有右孩子,把右指针设为后继线索,并用标志位区分线索与真实孩子指针。
- 对前序、中序、后序线索二叉树,要按对应遍历顺序寻找前驱、后继。后序中,若右指针为空且已建立后继线索,可直接沿该线索访问后继;若右指针指向真实孩子,通常还需双亲信息。结点可能以下一个后序访问的双亲作为后继,也可能转到双亲右子树中的第一个后序结点;后者不一定只沿左指针就能找到。三叉链表保存左孩子、右孩子和双亲指针,便于处理一般情况下的后序后继;二叉链表实现则可能需要栈或从根查找双亲等辅助方法。
- 折半查找树
- 计算折半查找的成功查找长度时,将给定序列的位置构造成折半查找判定树。某结点的成功比较次数是它从根起算的层数,根为第 1 层;计算平均成功查找长度时,再按各结点的查找概率加权。
- 折半查找树的形态是趋同的, 即若是一个尽可能向左的二分搜索, 那么就是左子树优先, 否则就是右子树优先, 不可能两种情况同时存在
平衡搜索树(AVL、红黑树、B 树与 B+ 树)
AVL树
- 在平衡二叉树中, 平衡因子是左子树和右子树的高度差, 所以能构成平衡二叉树的最小节点数就是每个非叶节点的平衡因子均为 1, 根据高度有如下公式: ${C_n = C_{n-1}+C_{n-2}+1}$, 其中 ${C_0=0,\,C_1=1,\,C_2=2}$; 最多的节点数即为满二叉树; 问: 16个节点的平衡二叉树的最大深度:由于 ${C_5=12 \lt 16 \lt C_6=20}$ 故为 5
- 平衡树中删除一个节点再添加, 由于其可以自平衡, 导致可能与原树一样, 但排序树无平衡要求, 故若删除的不是叶节点则一定不同
- 给定任一序列, 确定不同的平衡二叉树数量, 由于需要平衡左右子树大小, 所以要选择中间尺寸的节点作为根节点, 然后分别对这些节点进行讨论, 若确定一个根节点后, 其左右子树仍然按照上述方法进行递归确认, 以一个例子说明:
序列{1, 4, 5, 10, 16, 17, 21} 所能确定的平衡二叉树的数量: 首先由于自平衡要求, 选中根节点集合{5, 10, 16}, 考虑对称,5和16是对称的, 看5, 左子树确认为1, 4, 有两种可能, 右子树最大高度为 3, 根节点集合为16, 17, 共四种可能, 所以共 ${2\times 4=8}$ 种; 接下来考虑根节点为10, 左右子树 size 均为 3, 由于高度为 2 的平衡树最小节点数为 2, 高度为 3 的平衡树最小节点数为 4, 故左右子树只有一种可能, 所以总的数量为 ${8+8+1=17}$ 种;
B树、B+树
- B 树的插入与删除操作
插入操作:$m$ 阶 B 树的非根结点至少有 $\lceil m/2\rceil-1$ 个关键字,最多有 $m-1$ 个;非空根结点至少有一个关键字。常见插入算法先把新关键字放到合适的叶结点,若结点暂有 $m$ 个关键字,则选取第 $\lceil m/2\rceil$ 个关键字向双亲提升,将两侧关键字分别留在两个结点中。提升的关键字成为双亲中的分隔关键字;只有根分裂时才需要创建新根。 若双亲也溢出,则继续递归向上分裂。取中间位置时必须明确取整规则。
删除操作: 这里一定注意一点, 删除操作是把当前节点替换为叶节点(终端节点), 即若被删节点不是叶节点, 那么就要找其前驱或后继, 然后进行替换, 替换后删除, 所以本质是删的叶节点, 具体看王道书, 可分为三种: 直接删除, 左右兄弟够借, 兄弟节点和父节点合并
这里补充一个左右兄弟不够借的例子:
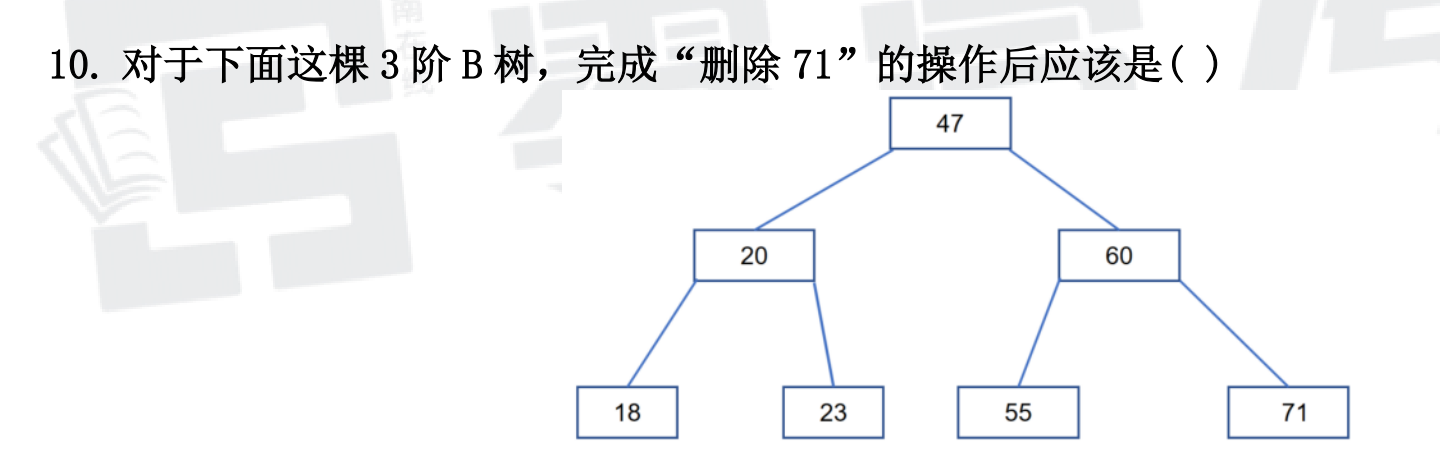
原笔记配图 1 由于 71 为叶节点, 直接删除, 变成空节点, 然后观察左兄弟(55)是否够借, 发现不够借, 于是把父节点和左兄弟合并成叶节点, 又发现父节点变成空节点, 于是观察左兄弟(20)是否够借, 发现不够, 于是把父节点和左兄弟合并, 得到根节点为
20,47, 三个孩子分别是[18],[23],[55, 60]
- 定长编码集是将数据转化成固定长度的二进制, 所以其形成的二叉树是固定的, 并且每个数据位都在叶节点
堆
- 关于堆的插入和删除过程中比较次数
- 在堆的插入中, 是直接插入到最右叶节点, 此时需要调整堆, 方法是: 从该节点开始, 依次与父节点比较, 若大于则交换, 由于原堆性质仍存在, 故不需要其他比较
- 在堆的删除中, 首先删除根节点, 然后最右叶节点代替称为根节点, 此时调整堆的方法是: 从根节点开始, 首先比较其两个子节点的值, 选择一个最值, 然后再与其比较, 直到根节点不往下交换为止
- 若给定一原始序列要求调整成堆, 需要从最后一个非叶节点往前调整
败者树(冠军树)
- 败者树(冠军树)
- 败者树适用于多路归并, 所以要先利用外部选择算法选择出初始的归并段, 然后构建败者树, 设初始文件经过内部排序后得到四个初始归并段:
{6,8}; {3,9}; {1, 5}; {2, 7}, 采用败者树构建过程如下 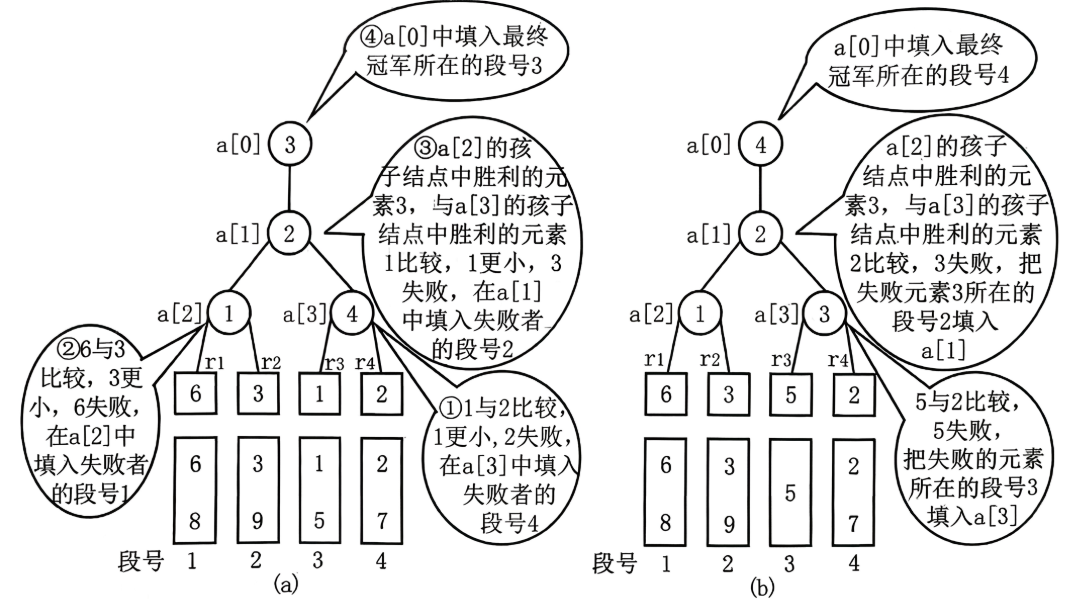
原笔记配图 2 - 败者树的是一颗完全二叉树, 根节点指向最小数, 节点内保存的是归并段号
- 由图可知 ${k}$ 路-败者树的深度为 ${\lceil log_2k \rceil+1}$, 但败者树的高度为 ${\lceil log_2k \rceil}$(不计入冠军节点和叶节点), 与节点数无关
- 败者树每次选出的是当前最小记录,调整所需比较次数与树高相应,通常约为 $\log_2 k$。增大归并路数 $k$ 会增加树高及单次调整的比较次数,但可减少归并趟数和磁盘 I/O,因而在内存允许时往往能提高外部排序效率。总比较次数还与记录总数、归并趟数及各趟使用的路数有关,应按实际归并过程计算。
- 败者树可以优化生成初始归并段, 即选择-置换排序的效率, 更快的选出 MINMAX
内存工作区中的记录作为败者树的外部节点,而败者树中根节点的双亲节点指示工作区中关键字最小的记录。
为了便于选出MINIMAX记录,为每个记录附设一个所在归并段的序号,在进行关键 字的比较时,先比较段号,段号小者为胜者;段号相同的则关键字小的为胜者。
败者树的建立可从设工作区中所有记录的段号均为 0 开始,然后从 FI 逐个输入w个 记录到工作区时,自上而下调整败者树。由于这些记录的段号为“1”,所以它们对于段号为 0 的记录而言均为败者,从而逐个填充到败者树的各节点中去.
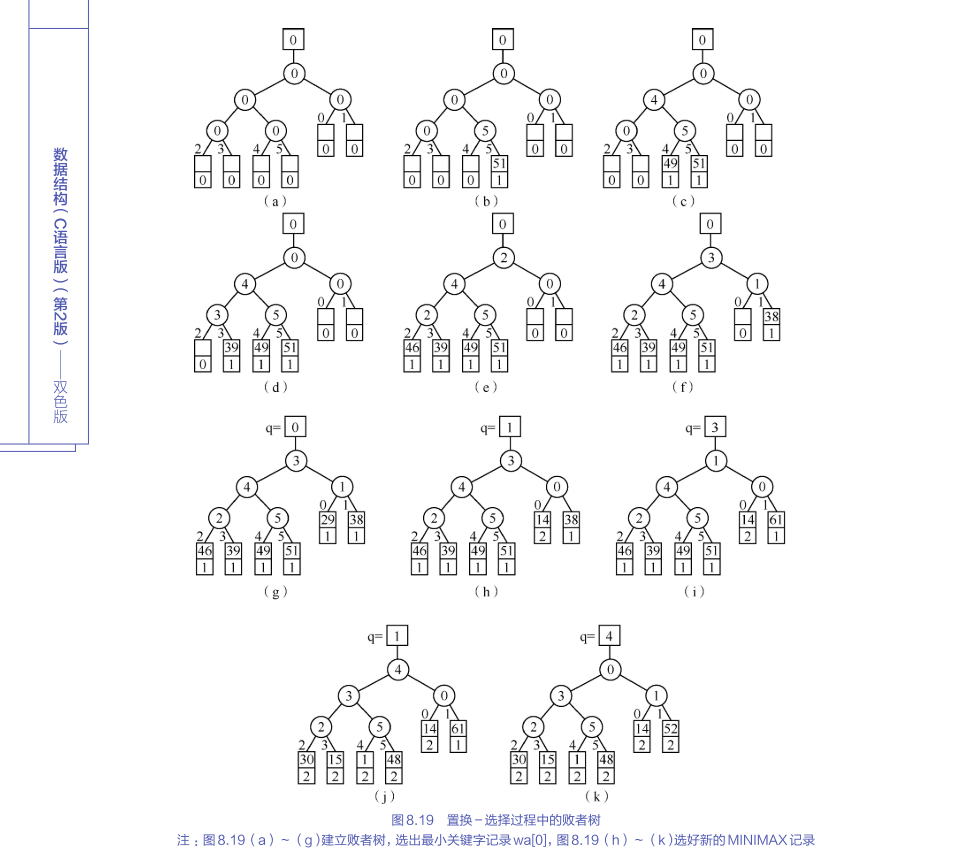
原笔记配图 3
- 败者树适用于多路归并, 所以要先利用外部选择算法选择出初始的归并段, 然后构建败者树, 设初始文件经过内部排序后得到四个初始归并段:
(多路)哈夫曼树、编码集
- 关于多叉哈夫曼树或者多路归并中需要补空的空节点数量, 考虑这种算法: 考虑 ${n}$ 个节点的 ${k}$ 路最优归并树, 设一个严格 ${k}$ 叉树中有 ${n_0}$ 个叶节点, ${n_k}$ 个度为 ${k}$ 的节点, 那么我们有 ${n=n_0+n_k=k\times n_k + 1}$, 消去 ${n}$ 得到 ${n_0=(k-1)n_k+1\Rightarrow n_k=(n_0-1)/(k-1)}$, 令 ${(n_0-1)\mod(k-1)=x}$, 若 ${x=0}$ 则可以构造 ${k}$ 叉归并, 否则会多出 ${x}$ 个节点, 可以肯定的是 ${x\lt k}$, 于是让这 ${x}$ 个节点构成一个新的归并段, 但这需要额外的一个节点来作为 ${\sum x}$ 的合节点, 故只需要加 ${k-x-1}$ 个新节点即可, 有一个节点是在内部, 度为 ${k}$
- 对 ${\displaystyle n}$ 个记录进行多路平衡归并排序, 其归并趟数与选取的归并路数有关, 这里的一个记录是一个归并段, 若给定归并趟数 ${\displaystyle k}$, 那么选取的归并路数应满足 ${\displaystyle k- 1\lt \lceil log_{d}(n) \rceil \leq k}$, 如对 ${\displaystyle 149}$ 个记录只进行 4 趟多路平衡归并, 那么符合条件的有 ${\displaystyle 4,\,5}$, 而 ${\displaystyle \lceil log_{6}(149) \rceil =3}$
图结构
- 无向图中, 每个节点的度是其边数, 所以整个图的度为边数的二倍, 在有向图中, 每个节点的度是其出度和入度之和
- 适用邻接矩阵的情况: 图为稠密图, 频繁查询"任意两点是否存在边", 增加或删除边; 适用邻接表的情况: 图为稀疏图, 频繁遍历邻居或遍历全图; 邻接表使用多很多算法, 如 Dfs, Bfs, Prim, Kruskal, Top Sort;
- 对元素为边的存在标志或重边计数的邻接矩阵 $A$,$A^n[i][j]$ 表示从顶点 $i$ 到顶点 $j$、长度为 $n$ 的游走条数。游走允许重复顶点和边;若“路径”特指无重复顶点的简单路径,则不能直接用矩阵幂计数。
- Prim 算法时间复杂度为 ${O(n^2)}$, 与边数无关, 适用于边稠密的图; Kruskal 算法时间复杂度为 ${O(m\times log_2m)}$, 与点数无关, 适用于边稀疏, 顶点多的图
查找
Hash
- Hash(散列表)的查找不成功平均长度要根据其散列函数来看, 即若数组长度为 10, 散列函数模数为 7, 那么就要计算下标 0~6 的不成功长度, 后面的不算
- 对于 Hash 中查找不成功的计算, 若为拉链法, 则只需搜到有值的指针, 下一个空指针不算做查找次数; 对于探测法, 若当前位置为最后一个有值位置, 且下个位置为空, 则要下一个位置也算做查找次数;
- Hash 映射中拉链法的装填因子计算, 装入 hash 表的节点数要把所有的指针数都算上, 即若对应 2 的链表的 size 为 2, 则这两个都计入装填因子的权值
字符串与杂项
- 对于两个有序序列合并, 比较次数最差为 O(m + n - 1)
- kmp算法计算的时候, 在我的方法中, 数组的下标是从 1 开始, 所以说 0 位置就是开头(即什么都没有, 把整段向前移), 在遇到 next 数组对应的值为 0 的时候, 此时就整段向前移, 然后
i+1, 即j=next[j], i++, j++; 注: 求 next 数组的时候, 要注意头尾不能在一个子串里, 即aaaab, 对于 b 来说, 它的 next 应该是 4, 即 a|aaa = 3 + 1; - 多叉链表通过多个指针域建立不同的链接关系。二叉链表有两个指针域,三叉链表有三个指针域;各域的具体含义由数据结构决定。
- 稀疏矩阵
- 对稀疏矩阵压缩要用到三元组, 一定会失去随机存取的特性
- 转置用三元组存储的稀疏矩阵
A[m][n]至少需要三个步骤:(1) 将矩阵的行列值相互交换;(2) 将每个三元组中的 i 和 j 相互调换;(3) 重排三元组之间的次序便可实现矩阵的转置, 因为三元组是以行序为主序顺序排列的
- 快排中, 若一趟的定义是对所有的元素都做一遍处理, 那么判断当前序列是否可能为第二趟的结果有如下情况:
- 若第一趟处理的中枢在首部或尾部(即最大最小值), 那么这一次确定一个最终位置, 接下来的第二趟, 只有一边可以选, 所以还能确定一个最终位置, 此时有两个最终位置
- 若中枢不在首部或尾部, 那么会确定三个最终位置
计算机组成原理
需要记忆的 IEEE754 浮点数的各种特殊情况; ISA 概念部分; 并行处理技术以及多核处理概念; 计算机内部的各种码表示范围; 移码, 浮点数关于机器零的概念; 浮点数的具体运算, 对阶以及舍入等; 多处理器的基本概念; ISA 的范围
计算机结构
- CPI 是一条指令所需要的时钟周期数, 即反映的是指令在硬件上要跑多少个周期(因为每个时钟周期中的寄存器等等只能用一次), 所以 CPI 与时钟周期无关
- 在计算整个程序段的大小的时候, 题目一般是给出整个代码段, 这个时候根据代码段的第一行, 即起始地址 ${A}$, 以及最后一行, 即终止地址 ${B}$ 来计算, 此时注意, 最后一行的终止地址并非最后一个指令的起始地址, 而是最后一个指令的起始地址 + 指令字长, 设最后的字长为 ${x}$ 个编址单位, 则 ${Lenth=B+x-A\,\,或\,\,B+x-1-A+1}$
- 通用寄存器用于存放操作数和各种地址, 由机器字长确定, 字长/机器字长是数据通路的宽度
- 根据冯·诺依曼计算机结构的原理:
- 指令和数据都存放在同一存储器中,且格式相同,物理上没有分开;
- CPU 通过程序计数器(PC)指定的地址访问存储器取指令;
- 通过指令中的地址字段访问数据;
- 区分指令和数据主要是因为CPU在不同的指令周期阶段访问存储器,即取指阶段访问的是指令,执行阶段访问的是数据。
- 字长、机器字长、指令字长、存储字长的区别与联系
- 字长:处理器一次自然处理的数据位数,通常与通用寄存器和 ALU 的宽度相关。外部数据总线、MDR 和机器字长不一定相等,应根据题设的数据通路与存储接口分别确定。
- 机器字长:处理器的自然运算字宽,常与通用寄存器、ALU 及内部主要数据通路相关;不能无条件等同于外部数据总线或 MDR 的宽度。
- 指令字长:一条指令编码占用的位数。在按整字取指、每次只读一个存储字且不考虑重叠访问的题目模型中,若指令字长为存储字长的 2 倍,就需两次访存;相等时需一次访存。一次访存是否对应一个机器周期仍取决于题设。实际 ISA 也可能按字节编码、采用变长指令,一次读取可以覆盖多条指令或某条指令的一部分。
- 存储字长:题设中一个存储字所含的位数。若 MDR 承接一次整字读写,其宽度与该存储字一致;编址单位还可能与整字读写宽度不同。它与机器字长、指令字长之间是否相等或成整数倍关系,应按具体结构确定。
- 主存地址是可寻址单元的编号,地址位数由可寻址单元数量决定,应与数据字长分别讨论。MAR 的宽度需满足机器支持的地址空间;数据对象是否按边界对齐是另一个问题。
- CPI 按定义计算:$\mathrm{CPI}=\text{总时钟周期数}/\text{完成的指令数}$,即平均每条指令使用的周期数。单位时钟周期完成的指令数为 IPC;在相同统计口径下,$\mathrm{IPC}=1/\mathrm{CPI}$。
数据表示与计算
位数相同的情况下, 移码和补码的表示范围相同
计算浮点数的最值范围的时候, 尤其要注意那个几个特殊情况, 如阶码全 1, 阶码全 0 等, 这部分需要记住
PSW 中标志位的作用以及意义
- CF 是进位/借位标志,可用于无符号运算的范围判断。采用 $CF=Sub\oplus C_{out}$ 的约定时,加法中 $Sub=0$,因此 CF 与加法器输出进位 $C_{out}$ 相同;无进位时二者均为 0。减法用 $A+\overline B+1$ 实现,$Sub=1$:若无符号 $A\ge B$,则 $C_{out}=1,\ CF=0$,没有借位;若 $A\lt B$,则 $C_{out}=0,\ CF=1$,发生借位。有符号溢出应另看 OF,不能与进位或借位混为一谈。
- OF 为溢出标志位, 只对有符号数有意义, ${OF=C_n \oplus C_{n-1}}$, 即若有符号数运算符号位和最高数位进位不同则溢出
- SF 为符号位, 数字的最高位, 只对有符号数有意义
- ZF 为零标志, 对两者都有效
无符号大小比较主要看 ZF、CF,SF、OF 不直接决定比较结果。按减法借位时 CF 为 1 的约定,$A-B$ 不借位的条件是 $CF=0$,其中也包括 $A=B$;严格大于还要求 $ZF=0$,故 $\overline{ZF+CF}=1$ 表示无符号 $A\gt B$,这里的加号表示逻辑或。
强制转换运算符的优先级高于乘除,
(float)(x+y)/2的计算过程为x+y -> (float)(x+y) -> /2。不同类型参与运算时,应依整数提升和通常算术转换判断:例如 float 与 int 运算通常将 int 转为 float;有符号、无符号混合运算的结果类型还取决于转换等级及可表示范围,并非总是无符号。在常见的 16 位 short、32 位 int 补码模型中,负 short 转为 unsigned int 的最终位型可表现为符号扩展,而 unsigned short 转为能容纳其全部取值的 int 可表现为零扩展;从短类型扩展到长类型时应先判断源类型和值域。强制转换通常是数值转换,整数转浮点数等还可能发生舍入,不能一概理解为只改变位模式的解释。下面的代码按上述常见位宽与补码转换模型计算。unsigned int u = 0xffff0fff; short s = -3940; int i = 50000; short temp = u + s; int result = temp + i; printf(" %d\n", result);${\displaystyle result=50155}$
海明码的校验与纠错
- 设海明码有 ${k}$ 位校验位, 数据 ${n}$ 位, 则 ${k}$ 需要满足 ${2^k \geq n+k+1}$, 然后发送发需要把数据转化成海明码的格式, 这里以
1001011举例, 需要 ${k=4}$ 位校验位, 发送的数据共 11 位 - 海明码的校验位通常设置在 $2^i$ 位置,即 $1,2,4,8$。采用偶校验时,位置 $2^i$ 的校验位等于同组数据位的异或;同组位置的二进制下标在对应位上为 1。对本例的数据位位置 $3,5,6,7,9,10,11$,有 $a_1=a_3\oplus a_5\oplus a_7\oplus a_9\oplus a_{11}=1$,以及 $a_2=a_3\oplus a_6\oplus a_7\oplus a_{10}\oplus a_{11}=0$;位置 11 的二进制下标为 1011,因此也属于第二校验组。同理得到 $a_4=1,\ a_8=0$,发送码字为
10110010011。 - 接收方计算各校验组的异或综合 $h_i$,其中也包括该组的校验位。收到
10110110011时,有 $h_1=a_3\oplus a_5\oplus a_7\oplus a_9\oplus a_{11}\oplus a_1=0$,$h_2=a_3\oplus a_6\oplus a_7\oplus a_{10}\oplus a_{11}\oplus a_2=1$,同理 $h_4=1,\ h_8=0$。综合按 $h_8h_4h_2h_1$ 排列为 0110,在最多一位出错的假设下,表示第六位出错,将它取反即可。综合为 0000 表示未检出错误;在最多一位出错的模型中可判断无错,但多位错误也可能产生零综合。
- 设海明码有 ${k}$ 位校验位, 数据 ${n}$ 位, 则 ${k}$ 需要满足 ${2^k \geq n+k+1}$, 然后发送发需要把数据转化成海明码的格式, 这里以
机器中既可以表示真实的零,也可能把过小的结果舍入为零。讨论浮点数时,要区分零、非规格化数和下溢。传统浮点格式中,实际尾数为零时数值为零;IEEE 754 则把指数域和尾数字段均为零的位型定义为正零或负零,符号位区分二者。规格化数即使存储的尾数字段全零,仍含隐藏的前导 1,因此通常不为零。下溢可能得到非规格化数,也可能按舍入规则成为零。移码用偏置编码指数,但全零位型是否表示零取决于具体格式,不能仅由指数采用移码推出。
IEEE 754 浮点数的数值范围
- 规格化数的指数域既不全为 0,也不全为 1。令指数域有 $k$ 位、存储的尾数字段有 $p$ 位,$\mathrm{bias}=2^{k-1}-1$,则最小正规格化数为 $1.0\times2^{1-\mathrm{bias}}$,最大正规格化数为 $(2-2^{-p})\,2^{\,2^{k-1}-1}$。这里的 $p$ 不包含规格化数的隐藏前导位。
- 非规格化数的指数域全为 0、尾数字段非零,没有隐藏的前导 1。最小正非规格化数为 $2^{1-\mathrm{bias}-p}$,对应尾数字段 0.00…01。binary32、binary64 的存储尾数字段分别为 $p=23,52$ 位,包含隐藏位的规格化精度分别为 24、53 位。
浮点数舍入要区分向零、向正无穷、向负无穷和就近舍入等方式。IEEE 754 默认的就近舍入采用“舍入到最近,恰好中点时取偶数”。应比较全部被丢弃部分与半个最低有效位单位的大小:大于一半时进位,小于一半时截断;恰好一半时,使保留结果最低位为 0。因而不仅要看被丢弃的第一位,还要看后续位是否非零,以及保留结果最低位的奇偶。
两个规格化浮点数运算, 得到的数可能是非规格数, 如: ${\displaystyle A=0x00800001,\,B=0x80800000}$, 则 ${\displaystyle A+B=0x00000001}$
加法器, 乘法器, 除法器
- 无论有无符号数相减, 对于
x-y, 加法器两端应原封不动的送 x, 对 y 按位取反, 然后 sub 取 1 - ALU 中是否进行部分积与被乘数的加法运算由乘数的最低位决定(0不动, 1相加)
- 原码乘法移位时, 应将进位位, 部分积, 乘积部分一起进行逻辑右移
- 快速列阵乘法器不包含移位器
- ${\displaystyle n}$ 位乘除法大约需要 ${\displaystyle n}$ 次加减运算和 ${\displaystyle n}$ 次移位运算, 应注意符号位的一次异或
- 无论有无符号数相减, 对于
存储系统
存储器分类与功能
各种存储器的分类与作用
- 随机存取存储器(RAM, 有易失性); 只读存取存储器(ROM, 也具备随机存取, 写速比读速慢); 顺序存取存储器(磁带, 只能顺序存取); 直接存取存储器(磁盘, 光盘, 在存取的过程中, 既有随机存取(找磁道), 又有顺序存取(找扇区));
- 静态存储器(SRAM, 功耗大, 非破坏性读出, 无需刷新); 动态存储器(DRAM, 功耗小, 破坏性读出, 读后需再生(仅针对读出的单元), 且需要定时对数据刷新(单位位行)以防数据消失);
主存由 RAM 和 ROM 实现, 控制存储器(微程序里的)由 ROM 实现
存储器地址寄存器 MAR 的位数取决于可寻址单元的数量,必须同时知道总容量和编址单位。若容量为 128 KB,且题设按 16 位字即 2 B 编址,则共有 $128\mathrm{KB}/2\mathrm B=2^{16}$ 个地址单元,MAR 至少为 16 位;若按字节编址,则需要 17 位。机器字长为 16 位本身并不能确定编址单位,容量除以编址单位得到的是单元个数。
按题设的边界对齐规则存储时,若要求类型按其大小对齐,则对象的字节地址应为该类型大小的整数倍。例如在 short 为 2 B、int 为 4 B 的模型中,分别按 2、4 字节对齐,不满足时补入所需的填充字节。具体类型大小、对齐要求及浮点编码由目标 ABI 和题设决定;这些常见位宽及 IEEE 754 约定并非 C 语言对所有实现的统一保证。
主存地址是主存块号 + 块内偏移位, 主存块号就映射到 Cache 的 ${tag}$ + cache 组号字段, 偏移位一样
存储周期是同一存储体两次独立访问开始时刻之间的最小间隔,包括访问、恢复等限制。数据准备、内部恢复与外部总线传送是否分离或重叠,应按给定时序判断;计算总时间时既不能无条件排除传输时间,也不能把已包含的时间重复相加。
关于 DRAM 的刷新
- DRAM 按行激活和恢复电荷;激活行的数据由感应放大器等静态保持电路构成的行缓冲保存。在给定一次激活一整行的组织中,行缓冲容量等于该行的数据位数,不应把它必然理解为一块独立的 SRAM 存储器。
- DRAM 通常由内存控制器发出刷新命令、芯片内部完成相应行的刷新;自刷新模式下,芯片可自行持续安排刷新。刷新对 CPU 通常透明,但这不等于无需外部控制。读后再生通常也由硬件自动完成,它针对被读出的单元;周期刷新则要保证所有需要保持的数据及时得到刷新。
- 刷新按行进行,不需要列地址来选择行内某个字。行号可以由外部提供,也可以由芯片内部刷新计数器产生;刷新命令及片选、存储体选择等控制信号仍应按器件协议确定。
- 若一个并行芯片组可同时刷新各芯片的同一行,且各芯片行数相同,则该组刷新全部数据所需的行刷新轮数等于单片行数,总时间为轮数乘以每轮刷新时间。若控制器按存储体、rank 或芯片组分批安排,或有并发限制,就必须按实际调度计算,不能仅由芯片数量断言全部并行且耗时不变。
- 下面给出一个综合性的题目: 现在有 16 个 1M X 4 位的 DRAM 芯片,其中每 2 个芯片位扩展构成一个 1M X 8 位的 存储体,对这些存储体进行低位交叉编址构成一个 8MB 存储器。存储器按字节编址,且与 64 位的存储器总线相连,主存每次最多能读写 64 位数据,存储周期为 1ns。:
- 每个 DRAM 芯片是 1M x 4 位,本例按行、列地址各 10 位组织,得到 1024 行、1024 列;容量本身不唯一确定行列划分, 给定一个行号会把该 行对应的所有数据都读出到芯片的行缓冲寄存器里,行缓冲寄存器的单元个数与列数相同, 宽度为 4 位,所以一个芯片的行缓冲寄存器大小为 ${\displaystyle 1024 \times 4bit}$,存储器的行缓冲总大小为 ${\displaystyle 1024*4*16/8=8192B}$ ;这里按给定行组织计算感应放大器等静态行缓冲电路的容量。
- 存储器是按字节编址的, 也就是对于存储器而言一个字节对应一个存储单元。一块芯片可以提供 4 位数据,那么选中存储器一个单元时就会选择一个存储体的一个单元,选择一个存储体的单元同时选中了相同地址的两块 DRAM 芯片的 4bit 的单元,同时输出到存储器总线的 8 根数据线上。位扩展不会影响存储单元个数,会增大存储单元大小,地址数量不变,一个地址对应 的数据宽度增加。字扩展不会影响存储单元大小,会增大存储单元个数,地址编号个数增加,一个地址 对应的数据不变。
- DRAM 复用行、列地址引脚。本例需 10 根地址引脚和 4 根数据引脚,两者合计 $10+4=14$ 根,尚不包括控制、电源等其他引脚。
- double 型变量 x 的主存地址为
01 2345H, 总线是 64 位,同时启动方式下,一个存储周期启动 8 个体, 各提供 1B 数据,由于采用低位交叉编址,则主存地址构成为:20bit 块内地址 + 3bit 块号, 所以这 8B 数据的地址前 20 位相同,后三位地址从 000 到 111,分别代表 8 个存储体。x 的地址低三位是 101,第一个存储周期同时启动后得到01 2340H到01 2347H的 8B 数据,其中01 2345H到01 2347H是 x 的前三个字节,第二个存储周期会得到从01 2348H到01 234FH这 8B 数据,01 2348H 到 01 234CH 是 x 的后五个字节,所以读取 x 需要两个存储周期。 - 在各芯片同一行可以同时刷新、每次刷新占一个 1 ns 存储周期的题设模型下,只需按一个芯片的 1024 行计数,刷新所有行累计占用 $1024\mathrm{ns}$。集中刷新会形成连续死区,异步安排各行刷新时则把这段累计死区分散开。每个刷新周期内必须覆盖全部行;若额外给定刷新周期为 $20480\mathrm{ns}$,死区比例才可算为 $1024/20480=5\%$。仅凭题干给出的 1 ns 存储周期,不能确定这个百分比。
SRAM 和 DRAM 芯片的排线数和数量计算
- 对
8M × 8 位的芯片组织,8M 表示 $2^{23}$ 个存储单元,每个单元为 8 位,总容量为 8 MB。独立地址引脚需 23 根、数据引脚需 8 根,两者合计 $23+8=31$ 根。DRAM 可将 23 位地址拆为 11 位行地址、12 位列地址,分两次复用 12 根地址引脚;较少的行数可减少按行刷新的次数。此时地址加数据引脚为 $12+8=20$ 根。这些合计未包括片选、读写、时钟、电源等其他引脚。 - 若要求需要的 Ram 芯片, 则首先观察计算机按什么单位编址, 然后计算需要使用的总地址空间大小以及单个 RAM 芯片的大小, 然后相除向上取整即可
- 若芯片进行双扩展, 这里给出例子: “若干 8K x 8位的芯片组成一个 32K x 32 位的存储器, 存储字长为 32 位, 内存按字编址, 求地址 41F0H 所在芯片的最大地址”; 首先进行位扩展, 4 个芯片组成一个 8K x 32位的芯片, 直接接到数据线即可, 无需片选; 然后进行字扩展, 明显的需要 4 组位扩展后的芯片, 所以高 2 位进行片选, 每组芯片可表示 ${8K=2^{13}}$, 即 13 位的地址空间, 所以第 ${1 \sim 13}$ 位表示地址空间, ${14 \sim 15}$ 进行片选, 故 ${41F0H=010|0...}$, 对应最大地址为 ${010|1FFFH =5FFFH}$
- 对
一次总线事务过程包括:
- 送首地址和命令
- 存储器准备或读取数据;首份数据的准备时间记为 $T_{\mathrm{prep}}$,其值由访问时序给出,只有题目采用相应简化模型时才直接取一个存储周期。
- 将数据放到数据总线传送数据
- 在按流水方式准备数据的多模块交叉存储器时序模型中,发送首地址和命令后,先等待第一份数据准备完成,再依次传送后续数据。 若地址和命令传送占一个总线周期 $T_{\mathrm{bus}}$、第一份数据准备时间为 $T_{\mathrm{prep}}$,之后每周期传一份数据,共 $n$ 次传输,则总时间为 $T_{\mathrm{bus}}+T_{\mathrm{prep}}+nT_{\mathrm{bus}}$。题设若把首份准备时间取为一个存储周期,可再代入该值;$n$ 表示传输次数或每次传一字时的字数,多位总线一周期通常传多个比特。
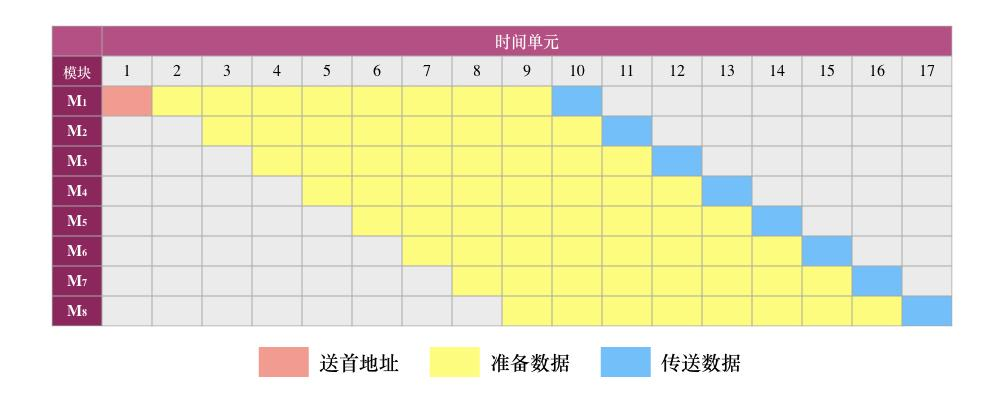
原笔记配图 4 多模块存储器的低位交叉编址分为两种启动方式, 一种是轮流启动方式, 另一种是同时启动
- 多体并行存储器拥有多个模块, 每个模块拥有自己的存储体, MAR, MDR, 读写/控制电路, 每个模块都是一个独立的存储器
- 当每个模块传输的位数等于数据总线位数, 就采用轮流启动, 其具体存储过程在前面的一次总线事务提到过, 设其存取周期位 ${T}$, 总线周期为 ${r}$, 则模块数应大于等于 ${m=T/r}$, 每隔 ${1/m}$ 个存取周期就会有读写一个数据, 在此过程中可能会发生冲突
- 当同时启动的一组模块总数据宽度等于总线宽度时,可以并行拼成一次总线传输;若目标数据没有按这组传输的边界对齐,可能读入无用字节。例如,若题干同时给出 4 个
64KB × 4 位DRAM 模块和 32 位总线,则模块合计只有 16 位,尚不能推出一次并行传输填满 32 位总线,必须进一步核对存储组织。若用四个按字节组织的 8 位模块说明 32 位同时启动的对齐过程,读取起址为 …AH 的 8 B double 时,低两位为 10,需要访问三组:[00,01,10,11]; [00,01,10,11]; [00,01,10,11]。其中有效部分依次是第一组的 10、11、第二组的 全部四个字节、第三组的 00、01,其余四个字节不属于所需数据。 - 对于多体交叉存储器来说, 访问的过程中可能会产生体冲突, 例如对 4 体交叉存储器, CPU 访问的主存地址序列为
03,09,11,02,33,25,0D,04,08,29,43,0A(均为16进制), 理想情况下,每隔 1/4 周期可读写一个数据,假定这个时间为 𝛥𝑡。每个存储模块内的地址分布为地址二进制的后两位, 即模块 0:00、04、08、0C、10; 模块 1:01、05、09、0D、11、25、29; 模块 2: 02、06、0A、0E、12; 模块 3: 03、07、0B、0F、13、33; 很显然,如果相邻 4 次访问中给定的访存地址出现在同一个模块内,就会发生访存冲突。所以 11 和 09、25 和 11、0D 和 25、08 和 04… 会发生冲突。29 和 0D 也在同一个模块内且访问间隔小于 4 个 𝛥𝑡,但是,由于访问第 08 单元发生冲突而使其访问延迟 3 个 𝛥𝑡 进行,从而使得 29 号单元 也延迟 3 个 𝛥𝑡 访问,因而,其访问不会和 0D 号单元的访问发生冲突. - 由于多模块存储器是按照流水线启动的, 所以当稳定下来之后, 其平均传输速度应按照流水线情况, 即一个周期传送一个体
Cache
- 对于一个指令, 一定要仔细观察到底访问几次, 如: a[x] = a[x] + 1; 这里的 a[x] 实际上是被访问了两次
- 直写方式若无特殊说明, 就算是写入队列缓冲也算作一次访存
- 计算 Cache 效率时,先明确时序模型和命中率 $H$。若 $T_C$ 为命中时间、$T_M$ 为一次未命中的完整访问时间,或采用相应的并行查询模型,则 $T_A=HT_C+(1-H)T_M$。令 $r=T_M/T_C$,可得 $e=T_C/T_A=1/[H+r(1-H)]$。性能提升应与无 Cache 的基准访存时间 $T_{\mathrm{base}}$ 比较,$X=T_{\mathrm{base}}/T_A$;在 $T_M=T_{\mathrm{base}}$ 的模型下就是 $X=T_M/T_A$。若先查 Cache,失败后另花 $T_M$ 访问主存,则应改用 $T_A=T_C+(1-H)T_M$,不能遗漏首次查询时间。
- 主存和 Cache 各自有独立的地址空间, Cache 地址映射到主存地址空间, 其中对于不同的 Cache 映射方式有不同的 Cache 地址结构:
- 直接映射的 Cache 地址结构: 行号 + 块内地址
- 全相联映射的 Cache 地址结构: 行号 + 块内地址
- 组相联映射的 Cache 地址结构: 组号 + 行号 + 块内地址
- 注: 虽然 Cache 地址包括组号与行号, 但是 Cache 结构是不包括组号与行号的, 其中包括有效位, Tag, 数据(行长), LRU(若有), 脏位(若有).
- 注: Cache 的容量是指 Cache 的存储容量, 不包括标记阵列(标记位、有效位、脏位等), 但 Cache 总位数或 Cache 总容量计算时包括标记阵列
- 注: Cache 的控制字段即为标记阵列, 即有效位, Tag, 脏位, LRU位等等
- 在 $d$ 路组相联 Cache 中,组号先选出一组,通常由 $d$ 个比较器并行比较各路 Tag,并结合有效位确定命中行。通常一行对应一个主存块;多路选择器按命中路选取该行的数据,再用块内偏移选择所需的字或字节。选择信号的位数取决于路数和行内数据组织,不能把一条 Cache 行理解为包含若干个主存块。
磁盘
- 在计算磁盘平均读写时间时, 一定要记住刚开始滑到目标扇区下边的平均时间是转半圈的时间(若题目特别说明磁头一开始的位置, 则不用这个计算); 磁盘的数据存取速率可能不会显式的给出, 但是根据磁盘一圈的数据量和转一圈所需要的时间便可得出数据传输速率
- 道密度是半径方向单位长度包含的磁道数, 位密度是磁道单位长度存储的数据量, 随着半径增大, 道密度不变, 位密度减少
- RAID 独立冗余磁盘阵列
- RAID0: 无冗余和无校验的磁盘列阵, 利用条带化技术, 使得读写速度在 RAID 中最快
- RAID1: 采用镜像磁盘阵列, 两个磁盘当一个磁盘用, 提高了安全可靠性
- RAID2: 采用海明码纠错, 提高了安全可靠性
- RAID3~5: 均采用奇偶校验, 提高了安全可靠性
指令系统与 CPU
指令系统
指令格式
- 顺序执行时,PC 增量等于指令字节数除以编址单位字节数。机器字长并不单独决定编址单位:若 16 位机器按字节编址,指令长 2 B,则 PC 加 2;若题设按 2 B 字编址,同一条指令才对应 PC 加 1。分支、跳转等指令还应按其指定目标更新 PC。
- 开关中断、修改中断屏蔽、访问受保护 I/O 端口、设置内存管理寄存器或 PSW 的特权字段等,通常属于特权操作。用户态一般可以执行普通算术逻辑、数据传送以及一般的调用、返回、条件或无条件转移指令,但只能访问其被授权的资源。触发系统调用的陷阱或软中断指令可以允许用户态执行,具体权限边界由 ISA 与操作系统规定。
- 指令格式, 计算机对应的编码
- 设计算机为 16 位计算机, 则对于定长操作码编码有: 半字长指令(8位, 常见于 RR 型指令), 单字长指令(即指令长度为 16 位, 具体格式由题目给出), 双字长指令(32位, 一般第二个字是偏移量或有效地址)
- 对于指令格式, 有如下几种常见类型: RR 型(寄存器-寄存器型), RX、RS 型(寄存器-存储器型指令, 其中 RX 型格式为
OP R1 X B D, 其中 X 为变址器, B 为基址器, D 为偏移量, 即一个寄存器操作数 R1, 一个存储器操作数EA = D+(X)+(B); 而 RS 型格式为OP R2 R3 B D, 即两个寄存器和一个存储器,EA = (B) + D), SI 型(存储器-立即数型), SS型(存储器-存储器型) - 有了以上的分析, 若题目给出一个指令为: ${(F0F1)_H(3CD2)_H}$ 和 ${(2856)_H}$, 可以看出, 第一个指令为双字长指令, 第二个指令为单字长指令, 因此可以根据题目给出的指令格式去判断其代表的操作
- 要区分定长/扩展操作码与定长/变长指令字。操作码位数决定可编码的操作种类,而非每条指令的操作数个数;扩展操作码也可在定长指令字内实现。例如,20 位指令中两个地址字段各占 8 位,剩下 4 位主操作码。若采用定长操作码,且分别保留两个编码给一地址和零地址操作,则二地址操作最多有 $2^4-2=14$ 种;若采用扩展操作码方案,只保留一个主操作码作为进一步区分一地址、零地址操作的前缀,则二地址操作最多有 $2^4-1=15$ 种。14 与 15 来自不同的保留编码方案,不能仅由指令字是否定长推出。
- 定长和变长指令都需要 PC 来跟踪取指位置。定长指令的顺序增量和边界较易确定,通常使取指与基本译码更简单;变长指令必须通过长度信息或译码识别边界,可以分块预取后在缓冲区内划分,具体是否按最大指令长度读取取决于实现。选择哪种格式还要权衡译码复杂度、代码密度等因素。
- 有两种指令可能有隐藏的操作数, 一是零地址指令, 它的操作数来自于栈顶和次栈顶, 二是一地址指令, 它的操作数来自于 ACC
- MIPS 汇编语言和机器语言
- MIPS 是典型的 RISC 处理器, 按字节编址, 采用 32 位定长指令字, 操作码也是固定长度, 若给出的位数为 16 位, 则需进行符号或 0 扩展
- 经典 32 位 MIPS 有 R、I、J 三类格式。J 型字段为
OP(31–26) target(25–0),用于 J、JAL 等伪直接跳转。若 PC 表示当前指令地址,目标地址由 PC+4 的高 4 位、26 位目标字段、末尾两个 0 拼接而成,相当于将目标字段左移 2 位后与高位组合。由于指令按 4 B 对齐,目标地址低两位为零,不必在指令内另行编码。跨 256 MB 边界时尤其要使用 PC+4 的高位。
指令周期与寻址方式
- 一条指令对应一个微程序, 即两者均用一个指令周期
- 位移寻址必须依据 ISA 确定基准地址、符号扩展方式和位移单位。相对分支通常按“规定的基准 PC + 经扩展及缩放的位移”形成目标;若以当前指令地址为 PC,经典 MIPS 条件分支为
PC + 4 + (sign_extend(imm16) << 2)。变址寻址通常用基址、索引和比例因子形成数据有效地址,便于数组访问;它与相对分支的规则应分别理解,不能统一记成 PC+1+Offset。 - 指令的执行周期结束后, 会检查是否有中断请求, 若有, 则进入中断周期, 中断周期中 CPU 做一些准备工作(保存断点、关中断、取中断向量等),然后跳转到中断服务程序的入口地址。之后, 中断服务程序(ISR)是一个具体的程序(代码, 但不是进程), 具有多条指令
- 取操作数时,
R[R1]表示寄存器寻址,即取得指定寄存器的内容;M[imm]表示直接寻址,其中 imm 是指令直接给出的有效地址,操作数是该地址处的存储内容 M[imm],不是地址本身。 - MIPS 过程调用, 假定过程 P 调用过程 Q, 则过程调用的执行步骤如下
- P 将入口参数放到 Q 能访问的位置,并按调用约定保存返回后仍需使用的 caller-saved 寄存器值。
- P 将返回地址存到特定的地方, 然后将控制转移到Q
- Q 保存自己会改写的 callee-saved 寄存器,并为自己的局部变量分配空间。
- 执行过程 Q
- Q 将返回结果放到 P 能访问的位置,恢复由自己保存的寄存器并释放相应的局部栈空间。
- Q 通过保存的返回地址把控制转回 P;P 再恢复由自己保存的调用者状态。
Cpu与数据通路、控制逻辑
- 寄存器读口 rs 使用的是多路选择器, 这样做的原因是快速, 纯组合逻辑, 并且支持多端口读入; 而寄存器写口 rd 使用的是地址译码器, 因为 rd 需要指令指出, 需要严格的时序控制, 地址译码器确保唯一性, 避免误写
- 单周期与多周期处理器
- 单周期处理器在无停顿的基本模型中,每条指令均用一个周期完成,CPI 为 1,时钟周期需覆盖最长指令的组合路径。多周期处理器将一条指令拆成多个周期,周期长通常按最慢的阶段确定,可复用硬件;各类指令使用的周期数及平均 CPI 由实际执行过程决定。
- 注意单处理周期处理器并不指单总线, 单总线上一个时钟周期只能传送一个信号, 因此不适用单周期处理器
- 在基本单周期设计中,不能把同一项单端口或单运算资源安排成多次先后使用而仍声称整个过程只占原来的一个周期。若指令同时需要不同操作,应提供独立资源或合适的多端口结构;例如寄存器堆可以通过多个读口同时读出多个操作数。
- 最简单的单周期数据通路通常每周期更新 PC,因而 PC 的写使能可固定有效;若设计包含停顿等控制,则仍需控制更新。多周期处理器中,同一条指令分多个周期执行,只有取指、转移等指定周期更新 PC,因此需要写使能使其他周期保持 PC。多周期处理器不必采用流水线,二者是不同的组织方式;流水线中的 PC 更新也要服从停顿、转移等控制。
- 单周期处理器仍会在规定的写入时刻更新 PC、寄存器以及需要写入的数据存储器;寄存器文件、数据存储器通常仍需要写使能。常见单周期数据通路可以不单设 IR,是因为指令存储器在同一周期内持续提供当前指令,供译码与执行使用,而非因为该周期没有状态写入。
- 基本单周期设计的控制信号由当前指令等组合译码产生,并须满足周期内各状态元件的时序要求。多周期控制器则随同一指令的取指、译码、运算、访存、写回等状态逐周期改变控制信号;这些状态不意味着多条指令正在流水重叠执行。
- 若数据通路图中 MAR、MDR 分别通过独立的地址线、数据线访问存储器,那么该次外部访问不必占用内部总线,可与无资源冲突、无先后依赖的内部操作并行。将新值经内部总线装入 MAR 或 MDR 时仍要占用该总线,因此需逐项检查连线、读写冲突和数据依赖。
Cpu流水线
判断数据相关要同时看生产者何时产生或写回结果、消费者何时使用,以及旁路和寄存器读写时序。经典五段流水线无旁路、但允许同周期先写后读寄存器时,生产者与消费者之间插入两条独立指令通常已足够;若不支持该读写时序,可能需要更多间隔。有旁路时应按结果可转发到的流水段判断;load-use 还要单独检查数据产生时间,不能一律用固定的“两条指令间隔”规则。
MIPS 的流水段(IF, ID, EX, MEM, WB)中, IF, MEM 阶段均可能访存从而引起缺页中断异常, EX 阶段要进行溢出判断, 可能引起溢出异常, 外部中断则需要在指令完成后, 即 WB 阶段后, 而 ID 阶段会进行译码等, 可能引起无效指令操作码等异常
Cpu 流水线中, 取指令和译码阶段动作是一致的, 不需要控制信号控制; 控制信号在译码阶段统一产生, 同样和数据一起跟随流水线寄存器进行传递, 传递到具体的相关流水段就把对应的控制信号输入对应接口
流水线技术
流水线性能指标: 吞吐率 = ${TP=\dfrac{n}{T_k}}$, 即单位时间完成的任务; 加速比为不用流水线的时间 ${T_s}$ 与使用流水线的时间 ${T_k}$ 比值 ${S=\dfrac{T_s}{T_k}}$; 效率是流水线中的设备实际使用时间与整个运行时间的比值,即流水线利用率, 对于流水段长相等的流水线, ${e=\dfrac{n\Delta t}{T_k}}$, 也可用定义计算: ${e=\dfrac{时空图中任务所占面积}{时空图总面积}}$
对于流水段长都相等的流水线, 此时的时空图和 Cpu 流水线的时空图无异, 此时完成所有任务需要的总时间为 ${T_k=k\Delta t + (n-1)\Delta t}$
对于流水段不相同的流水线, 其时间最长的流水段称为流水段的瓶颈段, 需要重复设置瓶颈段, 使其每隔一个时钟周期进行一个瓶颈
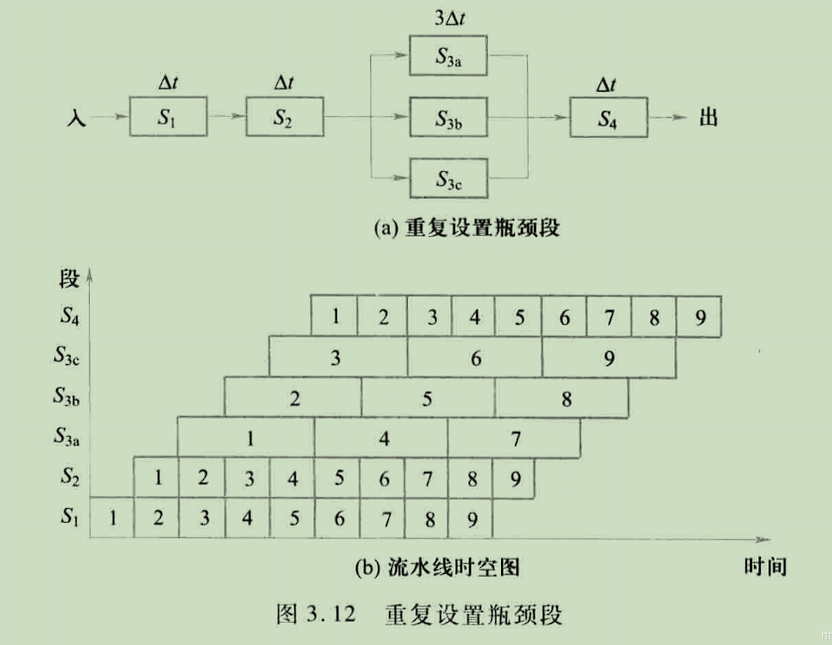
原笔记配图 5
关于 Cpu 流水线方式, 这里总结一下
- 对于一般 RISC 指令集的 Cpu 流水来说, 分为五段, 分别为: IF, ID, EX, MEM, WB; 中间涉及的冲突有: 结构冒险(硬件冲突), 数据冒险, load-use, 控制冒险;
- 以下以相邻的生产者与消费者、经典五段顺序流水线为例。对普通 ALU 数据依赖,无旁路且寄存器必须在 WB 结束后的下一周期才能读到新值时,消费者通常停顿三拍;若支持同周期先写后读,则通常停顿两拍。若具备从生产者运算结果到消费者 EX 输入的旁路,且消费者确实在 EX 使用该值,则通常无需停顿。不同取数阶段、间隔指令和旁路配置应分别分析。
- 对紧邻的 load-use,若消费者在 EX 使用加载结果,而结果到 load 的 MEM 末尾才就绪,则完整旁路配置下通常仍需一拍停顿,之后转发到消费者所需的 EX 输入。若没有旁路,则仍要等寄存器写回:在上述不支持同周期写后读的模型中通常三拍,支持时通常两拍。具体转发路径由数据通路决定,不必经过 ID/EX 流水寄存器。
- 控制冒险取决于转移目标和条件在哪一阶段确定,以及预测、延迟槽和冲刷规则。J 与 beq 不必在同一阶段决议,不能默认都在 MEM 之后更新 PC。例如,明确采用五段流水线、MEM 末尾决议、无预测且等待决议后才取目标指令的模型时,可以得到三拍控制等待;若决议更早,代价可降低。若数据相关另将决议推迟一拍,且这段延迟与原等待不重叠,该特定例子才得到 3+1=4 拍。应画出周期图计算,不能机械地把各种冒险停顿相加。
- 先识别逻辑数据依赖:若 t1 修改 R1,随后 t2 再修改 R1,而 t3 读取 R1,则顺序语义下 t3 需要 t2 的最新结果,而非 t1 的旧结果。再结合产生和使用时刻、寄存器同周期写后读及旁路,判断是否发生需要停顿的硬件冒险。旁路可以消除某些停顿,但不会消除程序中的逻辑依赖。
- 关于分支冒险判断: 只需要判断当前指令是否可能产生分支冒险即可, 常见于(有/无)条件跳转指令
总线与设备 I/O
总线系统
- 在异步总线中, 两个设备由于速度差异过大, 完全依靠双方互相制约的握手信号, 故需要按需分配时间
- I/O 总线中: 数据缓冲寄存器和命令/状态寄存器的内容均通过数据线传输; 地址线用以传送与 Cpu 交换数据的端口地址; 控制线用于给 I/O 端口发送读写信号, 仅用于对端口的读写控制
- 异步串行通信方式在传输字符时由于双方时钟不严格一致, 因此每传输一次字符(一次可能传输多位数据)都要用起始位和停止位作为开始和结束的标志
- 总线的峰值传输速率假设所有可用的数据传输时刻都用于传数据,等于总线时钟频率乘以每周期可传数据量。若每周期可传 $B$ 字节、频率为 $f$,则峰值为 $fB$ 字节每秒;双沿等机制应包含在每周期数据量中。平均传输速率为实际有效数据总量除以总耗时,还要计入地址、命令、数据准备等开销。周期数乘以每周期数据量只得到数据总量。
I/O 系统
中断
- 中断和子程序调用都要保留返回位置,以便继续执行被中断程序或调用者;可由栈、链接寄存器等机制保存,具体依架构和调用约定而定。中断还需保存恢复执行所需的 PSW 信息,包括条件标志、处理器模式及中断状态等。能否发生嵌套中断由中断使能、屏蔽、优先级等控制,保存 PSW 本身不禁止再次中断。普通调用通常在同一处理器模式下执行,不要求无条件保存整个 PSW,需保留哪些状态由调用约定规定。
- 中断响应周期通常是硬件执行中断隐指令、完成保存返回信息和转入中断入口等响应动作的阶段,教材也常将其称为指令周期中的中断周期。响应完成后,中断服务程序作为普通指令序列执行,其中每条指令都有自己的指令周期;服务程序整体不属于单个中断响应周期。
- 中断优先级可通过软件查询或硬件判优等方式确定。判优用于选择本次响应的来源,中断向量用于定位相应 ISR;硬件判优可能同时提供向量,但仅凭存在中断向量不能断定判优必由硬件完成。
I/O 传输方式与计算
- 若输入设备速率为 $x\,\mathrm{B/s}$,接口缓冲容量为 $y\,\mathrm B$,并假定每轮查询能及时取走旧数据,则最长轮询间隔应为 $\dfrac{y}{x}\,\mathrm s$。超过缓冲区被填满的时间,就可能发生覆盖或数据丢失;轮询及处理开销也应包含在实际间隔内。
- DMA 传输通常由 CPU 或驱动先配置源/目的地址、长度、方向和控制信息,再由控制器执行数据搬运。完成通知可按配置采用中断或由软件轮询状态。CPU/驱动读取的是 DMA 的控制与状态寄存器,而非处理器 PSW;控制器可以报告其支持的总线、地址或传输错误,但不能因此保证对数据内容进行了完整的端到端检验。软件再根据完成状态或错误状态进行处理。
- DMA 的字计数器按约定的字节、字或总线传输单元计数,不一定每次计一个完整数据块。对 $n$ 位递减计数器,若装入 $N$($1\le N\le2^n-1$)并在每次传输后减一、到 0 时结束,则传输量为 $N$,最大可装入 $2^n-1$。若从最大值开始,允许计数到 0 后再传输一次,并以该次下溢作为终止条件,则可完成 $2^n$ 次传输;也有把初值 0 编码为 $2^n$ 的约定。实际总量要依据初值、计数单位及终止判定时机计算。
- 外部设备发出 DMA 请求, DMA 控制器收到后, 向 CPU 请求总线, CPU 响应使其获得总线控制权
操作系统
需要记忆的: 各种操作系统的优缺点以及适用性, 对比单处理和批处理; 设备的分配与回收的数据结构(各种表以及实现细节); 微内核与宏内核比较; 虚拟文件系统; 进程的各种通信方式; 文件系统中的各种内存与磁盘的分布方法; 磁盘缓冲的循环缓冲和缓冲池方法; 内存映射文件的定义功能流程;
操作系统功能与进程
操作系统分类与功能
- 操作系统中的引导过程和磁盘初始化
- 磁盘安装操作系统:
- 在传统磁盘模型中,低级初始化(低级格式化)建立磁道、扇区等物理格式;扇区包含头部、数据区和尾部。CHS 地址用柱面号、磁头号、扇区号定位扇区,低级格式通常由厂商完成。
- 对磁盘分区(例如给 C、D 盘安排相应分区)。在传统 MBR 方案中,磁盘的主引导记录(Master Boot Record)包含分区表,用于记录分区的起始位置、大小、类型及活动标志等。PBR 的全称是 Partition Boot Record,即分区引导记录。
- 对磁盘逻辑格式化(高级格式化), 将初始文件系统数据结构(即文件的全局信息等)存储到磁盘上, 建立根目录, 对空闲磁盘块信息初始化
- 操作系统引导:以下采用传统 BIOS/MBR 模型。
- 计算机复位后,CPU 从规定的复位入口开始执行 ROM 或闪存中的固件代码,即 BIOS 引导程序。
- BIOS 完成硬件自检和基本初始化,并按传统实模式环境建立中断向量表等运行条件。自检由固件执行相应检测程序完成。
- BIOS 根据启动顺序和设备状态选择启动设备,再由 CPU 执行 BIOS 代码,将该设备的首个引导扇区加载到内存,开始执行磁盘引导程序。
- 对采用 MBR 引导的磁盘,读入的是主引导记录 MBR。其引导代码通常扫描分区表,找到活动分区,再加载该分区的分区引导记录 PBR,转入分区引导程序。
- PBR 通常位于相应分区的第一个扇区,其代码继续寻找并加载后续引导加载程序;具体文件位置和读取方式由文件系统及引导方案决定。需要选择多个操作系统时,由引导管理器提供选择功能。
- 引导加载程序将操作系统内核及必要的启动内容加载到内存,再移交 CPU 控制权,操作系统继续初始化。UEFI 使用不同的固件引导机制,不直接套用上述 MBR/PBR 链条。
- 需要注意:ROM 或闪存保存固件引导代码,执行硬件初始化、启动加载程序的是运行这些代码的 CPU。运行时驻留的程序页面、数据和文件缓存通常在 RAM 中,处理器寄存器和 Cache 还会保存正在使用的部分内容。
- 磁盘安装操作系统:
- 多道程序系统的四个特征:并发、共享、虚拟、异步;其中并发和共享是基本特征。单道程序在教材模型下具有执行的封闭性,多道程序因共享资源和并发执行而不具有这种封闭性。
- C程序经过预处理 ${\to}$ 编译(将高级语言转化为低级语言(汇编语言)) ${\to}$ 汇编(进一步的将汇编语言转化为机器语言) ${\to}$ 链接 ${\to}$ 装载
- 链接把目标文件和所需库合并,解析符号并确定可执行文件中各段的逻辑或虚拟地址布局。装载器随后创建进程的运行地址空间、映射代码和数据,并建立相应页表等信息;使用动态地址转换时,逻辑地址到物理地址的转换由运行阶段的硬件完成。
- 装载(装入)有三种典型方式。绝对装入适用于装入位置已经确定的程序,教材常以单道作业环境举例,此时使用预先确定的实际地址。静态可重定位装入在装入时,根据选定的起始地址一次性修正需要重定位的地址;相对地址可从 0 开始表示。在教材的连续装入模型中,前两种方式将作业一次装入所需的连续内存区。动态可重定位装入保留相对地址,直到真正访问时才转换,即在程序执行阶段完成地址转换。若使用单个重定位寄存器(基址寄存器),物理地址为基址加相对地址,并用界限寄存器检查偏移是否越界;这种模型仍对应连续物理区域。分页、分段及段页式等动态转换机制则使用页表、段表等结构,可以支持进程整体的非连续物理分配。
- 系统调用使用户进程进入内核态。硬件与入口软件协作保存被中断的用户上下文,包括必要的程序计数器、状态字、寄存器及用户栈指针,通常形成内核栈上的陷阱帧;这与把用户栈内容整体搬入内核栈不同。PCB 保存或引用调度状态、地址空间、打开文件、内核栈位置及上下文保存区等信息。系统调用在允许睡眠的进程上下文中可以阻塞并引起调度;持有自旋锁等原子上下文则受限制。普通硬中断处理程序不能睡眠阻塞,所需延后工作可交给适当的后续机制处理。中断嵌套描述中断处理之间的抢占关系,与进程调度是不同的机制。
- 各类数据的存放区
- 代码段或函数: 存放可执行代码
- 只读数据段(常见名称为 .rodata):通常存放字符串字面量,以及适合只读存储的静态存储期对象。局部或全局对象上的 const 限定本身不能决定其存储段;自动存储期的局部常量可能位于栈、寄存器中,也可能被优化消除,具体取决于语言规则、编译器和平台。
- 已初始化的读写数据段(通常为 .data):常存放非零初始化的可写全局变量和静态变量;零初始化或未显式初始化的可写静态存储期对象通常放在 .bss。实现可采用不同的布局。
- 堆: 存放动态分配(malloc/new)的内存
- 栈:保存每线程独立的执行栈帧,常包含需要栈存储的局部变量(也可包含函数指针变量)、溢出的参数或寄存器以及返回信息;参数和返回地址是否经过栈取决于调用约定与优化。
- 线程中对于各类数据的共享与独享分析
- 对于代码段, 只读数据段, 读写数据段, 堆中的数据, 文件描述符等属于进程内部数据, 堆属于进程地址空间, 可供线程共享
- 每个线程各自维护执行栈和栈指针。但同一进程中的线程共享地址空间,某个线程取得其他线程栈对象的地址后,通常也能访问该对象;这里的独立性是执行状态的独立性,并不构成线程之间的内存保护隔离。
- CPU 指令集决定有哪些可用的陷入或系统调用指令,以及这些指令的编码和硬件行为。操作系统 ABI 决定实际采用的进入机制、调用号、参数寄存器和传参约定。因此,同一 CPU 架构上的不同操作系统可以采用相同的指令,也可以选择不同机制,其系统调用接口和传参方式不必相同;同一操作系统移植到不同 CPU 架构时,通常也需要适配不同的指令编码和入口机制。应区分硬件提供的系统调用指令与操作系统定义的系统调用接口。
进程与线程
- 常见的教学性进程优先级倾向如下,实际取值取决于调度策略,类别也可能重叠:
- 可优先考虑系统进程的服务需求,再安排一般用户进程;具体系统仍可为用户实时任务设置较高优先级。
- 为满足响应要求,交互型进程通常比一般非交互型进程更早获得短暂的 CPU 服务。
- I/O 型进程通常可比计算型进程优先获得短暂的 CPU 服务,让它尽早发起下一次 I/O,从而提高 CPU 与设备并行工作的效率。
- Cpu 时钟是处理器内部的基准时钟, 也称为节拍, 常见的时钟周期就是指的 Cpu 时钟; 而时钟中断是由系统时钟发出的, 属于外中断,作用于操作系统, 所以操作系统来控制系统时钟, 常用于调度, 时间片, 定时中断
- 使得一个进程终止的情况:
- 正常结束
- 异常结束, 发生异常, 使得进程无法继续进行
- 外界干预, 由外界请求而终止, 如管理员或操作系统干预, 父进程请求或父进程终止等
- 比较优先级时,要区分两层机制:中断处理程序的响应和服务优先级属于中断机制;实时进程、交互型进程、I/O 型进程、计算型进程以及后台(非交互)进程的优先级属于调度策略。教学上常强调实时需求、交互响应和及时发起 I/O,并区分系统进程与用户进程,但这些类别不能构成适用于所有操作系统的严格全序。
- 一个进程只有在特殊的内核约束下才不可被调度, 例如原语操作. 即使是进程处于临界区也是可以被调度/抢占的
- 在抢占式优先级调度中,新创建或被唤醒的高优先级进程进入就绪队列后,内核比较它与当前进程的优先级,并在允许抢占的位置进行调度。若内核已经在执行,不必为了这次比较和切换额外产生外部中断;而设备中断可以是唤醒该进程的原因,多处理器上还可能用处理器间中断请求远程 CPU 重新调度。
- 管程的条件变量不要求一个 wait 严格对应一个 signal,也不累积无人接收的通知。调用方在持有管程锁时检查条件谓词,条件不满足则调用 wait,原子地释放锁并等待;被唤醒后重新获得锁,再检查条件。signal 在有等待者时通知其中一个,无等待者时通常不产生保存下来的许可。
- 在互斥方法中, 信号量机制与管程适用于单线程和多线程(多 CPU), test-and-set 由于是原子操作, 仍然适用于多 CPU, 而关中断则不适用于多 CPU, 其他 CPU 仍可访问共享资源, 无法实现互斥
- 原子操作保证相应操作不可被观察为相互穿插的中间步骤,它不等同于关闭再开启中断。现代 CPU 的原子读改写通常借助缓存一致性和对相关缓存行的独占访问完成,特定情形才可能锁总线。在单处理器上,关闭相关中断可保护某些内核临界操作;仅关闭当前 CPU 的中断不能实现多处理器互斥。
- 轮转调度选择时间片时,通常考虑系统响应要求、就绪队列中的进程数量以及处理能力和上下文切换开销。时间片过短会增加切换开销,过长会降低响应性;轮转算法不要求预先知道各进程下一次 CPU 计算段的精确运行时间。
- 发生中断时,CPU 进入内核执行相应处理代码,这本身不等于切换到另一个进程;在未发生调度的情况下,被中断的进程仍是当前运行进程。无论是否为 I/O 中断,都要根据处理结果判断是否需要调度:例如时钟中断可能触发时间片抢占,设备中断可能唤醒等待者,而一次中断处理也可能直接返回原进程。
- 进程间通信
- 管道(pipe):创建普通匿名管道时,系统向创建进程返回读端和写端两个文件描述符,典型实现中它们对应系统打开文件表中的两个端点对象。相关进程可通过继承或传递描述符使用这些端点。一个管道提供一个方向的字节流,双向通信通常建立两条管道;缓冲区管理、读写阻塞、唤醒以及必要的同步互斥由操作系统的管道实现负责。
多处理器与多线(进)程
- 多处理机系统
- 多处理机系统若采用 ${n}$ 个处理器, 因为有硬件处理开销增大的存在, 其加速比并不是 ${n}$
- 多处理机更加可靠, 当一个处理机出问题时, 该任务可由其它处理机来进行
- 多线(进)程系统
- 硬件多线程技术是共享单个处理器的技术, 其每个线程都可视作一个指令序列, 必须为每个线程提供单独的寄存器与程序计数器, 从而线程切换只需更换寄存器即可, 减小了开销
- 关于进程(线程)调度方式, 详细可看汤小丹老师的操作系统
同步与互斥
- 资源分配图
关于资源分配图的化简, 一个进程所要的资源若已经被满足了, 则可以删去这条边, 从而分配其他进程达到化简, 如下:
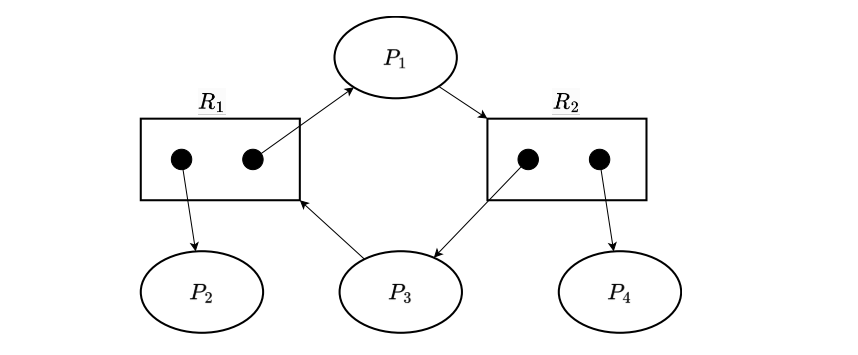
原笔记配图 6 此时的 ${P_2,\,P_4}$ 进程已经拿到了自己想要的资源, 且没有指向其它资源, 所以可以消去这两条边, 于是就可以把 ${R1,\,R2}$ 分配给 ${P_1,\,P_3}$ 从而化简, 此时无死锁
在一个每类资源仅有一个实例的资源分配图中,图中有环路则说明此时系统发生死锁
内存管理与虚拟存储器
内存管理
- 页表基址寄存器保存最外层页表的起始物理地址;按 408 的命名,它是一级页表。后续各级页表的物理位置由上一级表项给出。不同地址空间通常有不同的根页表,切换到另一个地址空间时要选择相应页表。同一进程、同一地址空间内的线程切换通常不改变页表基址;不同进程的线程切换通常伴随地址空间切换,而共享地址空间的进程或某些内核线程切换不一定需要改动页表基址。
- 注意与动态重定位寄存器区分。分页、分段和请求式存储管理都可在执行时完成地址转换,但使用的结构不同:分页使用页表及页表基址;分段使用段表中每段的基址与界限。分段对进程整体属于非连续分配,各段可位于不同物理区域,单个段通常连续。单个基址加偏移的重定位寄存器模型更适用于连续分区分配;段页式则组合段表和页表完成转换。
- 存储管理方式中, 进程在内存中的空间可以不连续的方式有: 分页式分配, 分段式分配(将一整个作业分成若干逻辑段, 按需放入内存), 段页式分配
- 计算 cache 或 TLB 命中率时, 即使是 1000 次中只有一次未命中, 也要计算, 不能直接约等于 100%
- 对于一个进程的访问, 具体的过程应该如下:
- 先查询 TLB;若未命中,再按题设模型访问内存中的页表,题目若规定某些查询并行则按其要求计算。若访问合法但目标页尚未驻留,产生缺页异常,由内核检查映射、分配页框,并从后备存储调入内容或按需创建页面,然后更新页表,按实现刷新或填充 TLB,再返回并重新执行原指令。若地址无效或权限不允许,则应作相应异常处理。按“首次 TLB 未命中、处理缺页后重启访问”的简化流程,常会计入两次 TLB 查询,具体次数以题设为准。此时只完成了地址转换,还需要访问目标数据,计算时间时要把这一步计入。
- 得到对应的物理地址后, 查询 Cache, 若 Cache 未命中, 则只能直接访问内存(可能同时访问), 然后再把对应的存储单元写入 Cache.
- 紧凑技术适合不固定大小的动态分配, 即适合动态重定位分区分配的存储管理方式
虚拟存储器
- 主存—外存(虚拟页 ↔ 物理页框)的映射是 全相联 的,原因是操作系统需要把任意虚拟页装入主存的任意页框以保证灵活性和内存利用率;映射关系由页表记录,TLB 用于加速这种映射的查找;
- MMU(Memory Management Unit,内存管理单元)是执行虚拟地址到物理地址转换的硬件部件,并在转换过程中实施相应的访问权限、地址界限等保护检查。
- 请求分页或请求分段是虚拟存储技术:只要求当前所需的页面或段驻留主存,其他内容可以在后备存储中,也可以在需要时生成;访问合法但尚未驻留的内容时,需要相应的缺页或缺段处理及按需调入机制,因此可以让逻辑地址空间超过可用物理内存。作为对比,教材中的普通或简单分页、分段模型要求程序运行所需内容预先驻留主存,没有按需调页过程,也就没有由频繁页面换入换出引起的抖动。
- 请求段式存储系统中段表对应的物理地址是基地址, 即计算真实的物理地址的方法应是: 基地址 + 段内偏移量
- Cache 通常由硬件自动管理,虚拟存储器由硬件与操作系统共同实现。应用程序直接使用虚拟地址,具体的地址转换、页框分配和换页细节通常对应用透明;系统程序员需要理解和管理这些机制。
- 系统级内容包括:硬件与受保护接口中的特权指令、受保护控制寄存器、设备寄存器、I/O 通道、DMA 控制器、中断向量表等;内核数据结构与机制中的 PCB、就绪队列、阻塞队列、页表、段表、换页算法、文件控制块 FCB、索引节点 inode,以及中断处理程序和驱动程序。指令系统也包含用户态指令,PSW 等状态寄存器也可能含用户可见的条件码,因此应分别判断哪些部分受特权保护。
- 划分多级页表时,要先求虚拟页号位数,再求一页能容纳多少页表项;在每级表不超过一页的要求下确定级数。例如:“64位计算机, 地址线宽 64 位, 虚拟地址空间大小 ${2^{48}}$, 采用虚拟存储系统, 每页 4KB, 页表项长为 8B, 求多级页表的最小级次”;答:按字节编址,虚拟地址为 48 位,与题目给出的物理地址线宽分别考虑。4 KB 页需要 12 位页内偏移,所以虚拟页号占 $48-12=36$ 位。一页能容纳 $4\mathrm{KB}/8\mathrm{B}=512=2^9$ 个表项,每级最多索引 9 位页号,故最少需要 $36/9=4$ 级页表。
- 在地址变化过程中, 可能产生缺页中断, 越界中断, 访问权限/保护中断(表明禁止执行、禁止写或禁止用户访问等;或段/页访问超出权限)
- 关于二级虚拟存储系统的计算问题, 这里举个例子
计算机采用二级虚拟页式存储,内存大小为 4MB,采用虚拟页式存储管理,进程的寻址空间为 256MB,页面大小为 1KB,页目录表和页的大小均为一个页, 且表项大小均为 2B,表项包含存在位和物理页框号以及访问权限位,其中最高位开始的连续 k 位为物理页框号,最低位为存在位,剩下的则全部为权限位。页表基址寄存器 PTBR 的值为 0x000C00H, 已知 P1 访问逻辑地址 0x2000400H,给出计算物理地址的过程
答:保留题给的两级页表结构,逐步完成地址转换:
- 按字节编址,4 MB 主存需要 22 位物理地址;1 KB 页需要 10 位页内偏移,因此物理页框号占 $k=22-10=12$ 位。一个 2 B 表项共 16 位,高 12 位是页框号,最低位是存在位,其余 3 位为权限位。
- 256 MB 进程地址空间需要 28 位虚拟地址。每张 1 KB 表可放 $1024/2=512=2^9$ 个表项,所以格式为 9 位页目录索引 + 9 位二级页表索引 + 10 位页内偏移。逻辑地址
0x2000400的页目录索引为0x40,二级索引为0x01,页内偏移为0x000。 - 由 PTBR 得目录项地址
0x000C00 + 0x40 × 2 = 0x000C80。从这里读取 2 B,按机器端序组合成完整表项。若表项值为0x4523,小端时两个字节为23 45,大端时为45 23。最低位为 1,表示存在;还须根据权限位检查此次访问是否允许。高 12 位给出二级页表页框号0x452。 - 二级页表的物理基址为
0x452 × 1024 = 0x114800,因此索引为 1 的 二级页表项地址为0x114800 + 1 × 2 = 0x114802。 - 继续读取
0x114802处的 2 B 二级页表项,同样按端序组合,检查存在位和权限。若允许访问,取其高 12 位为目标数据页框号 $PFN_{\mathrm{data}}$,最后得到目标数据的物理地址 $PA=PFN_{\mathrm{data}}\times1024+0$,再据此访问数据。若不存在则先处理缺页,若权限不符则处理保护异常。题目未给出这个二级表项的值,因此尚不能得到唯一的数值物理数据地址。
文件系统
- 对于文件操作
- POSIX 的
open按路径查找文件,成功时返回整数文件描述符,例如int fd = open(pathname, O_RDONLY);。C 标准库的fopen则返回流指针,例如FILE *fp = fopen(pathname, mode);;fp的类型是FILE *,*fp表示流对象,在 POSIX 环境下可用fileno(fp)取得底层描述符。后续read(fd, ...)根据已打开的文件对象访问数据,通常无需重新按路径检索目录。 unlink(pathname)按路径删除一个目录项,也就是移除该文件的一个硬链接;参数为路径名。通常要求父目录的写权限和搜索/执行权限,并可能受粘滞位等规则限制,目标文件自身的写权限不是必要条件。移除链接会减少 inode 中的链接计数;链接计数为 0 且所有打开文件等相关引用释放后,文件数据及 inode 才可回收。
- POSIX 的
- 关于读文件操作流程:
- 普通
read接收文件描述符,通过进程的描述符表找到系统打开文件对象,取得当前偏移、访问方式和 inode/vnode 等信息;按文件名查目录通常已经在open阶段完成。 - 检查描述符、读权限和目标缓冲区等访问条件是否合法。
- 查询页缓存等内存缓存;命中时可直接复制数据并更新偏移。若需要磁盘数据,按文件的逻辑与物理组织、inode 中的索引等,把请求的文件偏移或逻辑记录位置转换为磁盘块位置。
- 向设备驱动程序提交所需的 I/O 请求;在阻塞式读取中,数据尚未准备好时,进程随后等待或阻塞。
- I/O 完成后,内核处理完成事件并唤醒等待者,将数据复制到用户缓冲区,更新文件偏移并返回。内存映射文件则通过映射地址访问,缺少所需驻留页时可以由缺页异常触发调页。
- 普通
- 文件系统中,插入记录并计算磁盘块访问次数时,要按分配方式分析。下面的计数采用一条记录对应一个磁盘块、所需数据块未缓存、忽略目录及空闲空间管理等元数据开销的教学模型;若一块含多条记录,应按实际受影响的块数计算。
- 连续(顺序)分配下,为减少访问次数,应根据插入位置决定移动前缀还是后缀,并确认移动方向有相邻空闲空间。例如在 1000 条记录的第 20 个位置插入一条记录,若文件前方有一个空闲连续块,可将前 19 条记录向前移动一块。每个旧块读一次、相应新位置写一次,再写入插入记录,总计 $19\times2+1=39$ 次;还需更新起始位置和长度,其元数据成本按上述假设不计。
- 隐式链接分配下,从首块沿下一块指针读到第 19 块,共读 19 次。找到一个空闲块,将新记录写入其中,并令其下一块指针指向原第 20 块;再改写第 19 块,使其指向新块,共写两次(新块一次、第 19 块一次),总计 $19+2=21$ 次,同样不计分配元数据开销。
- 多级索引下,最大单文件大小要综合考虑单个 inode 的数据寻址能力、文件大小字段上限和可用数据区容量。例如题给 inode 大小为 64 B、簇大小为 1 KB,用 1 M 个簇存放 inode、512 M 个簇存放文件数据,按 $1\mathrm{M}=2^{20}$、$1\mathrm{KB}=2^{10}\mathrm{B}$ 计算,共有 $\dfrac{1\mathrm{M}\times1\mathrm{KB}}{64\mathrm{B}}=16\mathrm{M}$ 个 inode,数据区容量为 $512\mathrm{M}\times1\mathrm{KB}=512\mathrm{GiB}$。16 M 限制的是 inode 数量,一个 inode 可经多级索引指向许多数据簇。题目未给出单个 inode 的指针布局、指针宽度及文件大小字段,所以仅据这些数据不能唯一确定最大单文件大小;它至多为各项容量上限中的最小值。
- 文件存储系统:
- 连续分配在文件控制块 FCB(File Control Block)中记录文件的起始物理块号和长度(或连续块数),因此不必另外建立记录每个数据块地址的索引块。进程控制块的缩写是 PCB。
- 隐式链接分配在文件控制块 FCB中记录起始块号,并可保存末尾块号以便追加,不需要另建一张完整的块地址索引表。每个数据块中的下一块指针会占用块内空间,因而降低可存放的有效数据量。指针位数限制可表示的块号范围和可寻址块数量,从而限制可寻址容量;单个磁盘块的大小则是另一个格式参数。
- 磁盘缓冲区类似于外部磁盘的高速缓存, 需要用到的页面可以从缓冲区获得, 即可以减少磁盘 I/O 次数
- FAT 显式链接表按当前簇号索引,其表项给出下一簇号或结束、空闲等标记。例如
一个簇 2KB, FAT 表中 B 文件对应的簇号链为: 5000 -> 4000 -> 4500, 问 B 文件的第 5000 个字节和第 9000 个字节对应的物理块号。每簇 2048 B,按从 1 开始的字节序号计算,第 5000 字节落在从 0 开始的第 $\lfloor(5000-1)/2048\rfloor=2$ 号簇,即文件第三簇,其物理簇号为 4500。第 9000 字节落在第 $\lfloor(9000-1)/2048\rfloor=4$ 号簇,即第五簇,题目未给出它的簇号;若所列链条已经完整,则总分配空间只有 $3\times2048=6144$ B,第 9000 字节已越界。 - 文件存储方法(顺序、隐式链接、混合索引)描述单个文件如何组织其数据块。连续存储在 FCB 中记录起始物理块号和长度;链接存储记录首块指针,并可维护尾块指针;混合索引的 inode 保存直接数据块地址,以及一级、二级等间接索引块的地址。目录项负责把文件名关联到 inode,与 inode 内部的块索引项是不同结构。给定完整的索引布局后,可以计算单文件的最大寻址大小;这与整个外存容量分别计算。文件数量还受可用 inode、目录元数据空间以及实际数据空间等条件限制。
- 文件共享
- 硬链接:多个目录项指向同一个 inode,共享文件的地址信息和链接计数。对文件内容的修改可通过各个硬链接看到;删除其中一个链接只移除该目录项并减少链接计数,其余硬链接仍然有效。最后一个链接及相关打开引用都释放后,才回收文件。
- 软链接(符号链接):它是具有自身 inode、内容为目标路径名的文件,路径可以是绝对路径或相对路径。访问时按该路径解析目标,因此目标内容变化可见,而目标被移动或删除后可能成为悬空链接。目标 inode 可以由多个目录项或打开文件引用,并非只有文件拥有者才能引用。符号链接可跨文件系统引用路径;访问其他主机仍须依靠已挂载的网络文件系统等机制,单有主机地址和路径并不会自动提供网络访问。
- 软链接增加独立的链接对象和目标路径存储,访问时也可能增加路径解析开销;短路径可以直接保存在 inode 等结构中,不一定单独占用一个数据块。
- 多路径共享可能让不识别链接的遍历或复制程序多次处理同一文件。工具可以用文件系统标识与 inode 号识别同一文件、保留硬链接、选择是否跟随符号链接,并检测循环,因此重复复制取决于工具及其策略。
- 目录结构
- 单级目录结构即只有系统目录, 所有用户使用一个目录, 实现了按名存取, 但速度慢不允许重名
- 两级目录结构分为系统目录和用户目录, 但用户目录下不能再细分, 提高了速度, 解决了不同用户的重名, 可以实现访问限制
- 以上两种方式导致用户不能对自己的文件进行分类管理
外部设备与 I/O
- 设备分配的几个概念
- 设备的静态分配:作业执行前,操作系统一次性分配该作业所需的全部设备、控制器和通道。一般用于独占设备。优点是能够预防死锁,缺点是降低了设备的利用率。
- 设备的动态分配:当作业需要用到某一设备时,系统才会为其分配。一般用于共享设备。优点是提高了设备利用率,缺点是可能发生死锁。
- 设备的安全分配:一个进程在同一时间段内只能使用一个设备。获得设备的进程立即进入阻塞状态,不能再请求任何资源。优点是能够预防死锁,缺点是同一个进程,CPU 和设备只能串行工作,进程推进效率不高。
- 设备的不安全分配:进程在发出 I/O 请求后继续运行而不阻塞,需要新设备时可以继续发出 I/O 请求,仅当请求的设备已被占用时,才进入阻塞状态。优点是一个进程可同时操纵多个设备,使得进程推进迅速。缺点是可能导致死锁。
- 设备的安全分配和设备的静态分配均是破坏了"请求和保持"
- 为了实现独立性, 进程访问设备使用的是逻辑设备名(当然也可以用文件名访问物理设备), 这样操作系统可以根据逻辑设备名映射到物理设备表, 从而选择空闲的设备分配; 系统中有一张系统设备表(SDT), 其有个表项为设备类的驱动程序入口, 也就是如果更换物理设备, 只需要更换其驱动程序入口即可
- 缓冲技术: 主要为了解决 CPU 速度和外设速度不匹配的问题; 通道技术: 为了解决 CPU 不必过多参与复杂 I/O 控制的问题, 不是单纯的速度不匹配 提高 CPU 效率; 并行技术: 为了提高整机的运行效率和吞吐率; 虚存技术: 解决存储系统的容量问题; DMA 技术或其他中断 I/O 技术: 解决 CPU 和 I/O 数据传送效率低 的问题。
- 设备独立性软件与设备驱动程序各自的作用
- 设备独立性用于实现设备命名, 设备保护, 设备分配与释放, 即用户申请使用逻辑设备名时, 由设备独立性软件进行设备分配, 将其映射为物理设备名, 禁止用户直接访问设备;
- 设备驱动程序用于将命令和参数转化为具体要求(例如盘块号转化为盘面, 磁道, 扇区号); 检查用户是否有权限; 查询设备是否空闲, 若空闲则发出 I/O 命令, 给 Cpu 指明具体的中断服务程序入口或中断向量; 由于设备驱动程序需要对 I/O 设备进行控制, 所以不同的 I/O 方式(或不同的设备)对应不同的驱动程序
- 将设备名转为端口地址由设备驱动软件负责, 设备独立性软件负责提供逻辑地址, 即 I/O 接口与通道的逻辑对象并且映射到相关驱动软件, 然后由驱动软件负责映射(驱动可查询设备独立软件维护的设备表)
- SpooLing 技术
- 是设备独立性软件, 建立在多道程序设计基础上, 由系统(井管理程序)控制数据的传送
- 输入和输出服务可以并发执行,其运行态取决于实现。实际系统中的打印假脱机等服务常由用户态守护进程完成,再通过系统调用使用内核驱动;没有待处理的数据或任务时,相应服务可等待或阻塞。
- 通道的工作过程: 1. Cpu 要操作 I/O 设备, 向 I/O 通道发出命令, Cpu 忙别的事情; 2. I/O 通道去内存找到相关通道程序; 3. 启动 I/O 通道, 然后进行 I/O, 组织 I/O 操作; 4. 向 Cpu 发出中断信号告知已经完成;
- I/O 管理与设备管理的功能: 能实时掌握外部设备的状态, 可以实现存取操作, 负责对设备的分配与回收, 对设备的驱动、完成和故障的中断处理, 进行虚拟设备(Spooling技术);
系统性的总结
Scenario 1 - 应用程序执行环境
本场景描述从磁盘被制造出来到形成应用程序执行环境的全过程,磁盘与引导部分采用传统模型。盘片有盘面,每个盘面上有磁道,磁道分为扇区;不同盘面上半径相同的磁道组成柱面。CHS 寻址分别使用柱面号、磁头号和扇区号,磁头对应被访问的盘面。 当可用的磁盘被接入计算机主机中后,计算机便可以通过物理磁盘名+磁盘地址的方式访问到特定磁盘的特定地址。但是,为了灵活使用,我们往往会把整个物理磁盘空间划分为 逻辑上的多个空间,类似于 windows 系统中常用的 C 盘、D 盘等区域,不同的逻辑空间被称为不同的逻辑磁盘,也叫做不同的分区。 此后,根据具体需求,计算机在不同的逻辑磁盘上适配不同的文件系统,此后,不同逻辑磁盘上的文件系统还可以通过虚拟文件系统 vfs 层来进行相同格式的访问。 在传统 MBR 分区方案中,物理磁盘的首扇区通常保存 MBR(Master Boot Record,主引导记录),其中含引导代码和分区表;采用分区引导的卷,其首扇区通常保存 PBR(Partition Boot Record,分区引导记录)。主分区是 MBR 分区表中的一种分区类别,扩展分区内还可建立逻辑分区;操作系统可以根据支持情况安装在主分区或逻辑分区中。MBR/PBR 中的 R 都表示 Record。 计算机加电复位后,PC 指向规定的固件入口,CPU 开始执行 BIOS 等固件代码。BIOS 完成基本初始化并选择启动设备,加载该设备的 MBR。普通 MBR 引导代码通常查找活动分区并加载其 PBR,PBR 再继续加载引导加载程序,由加载程序把操作系统内核及启动所需内容装入内存,最后移交 CPU 控制权。若要由用户选择多个操作系统,该功能一般由引导管理器提供,可能采用不同的后续加载链。 随后,操作系统完成一系列初始化工作,并启动了图形界面相关的程序,将图形界面展现在了用户面前。用户通过图形界面点开了一个可执行文件,程序开始正式执行为用户提供服务。 关于以上过程,请回答下列问题:
- 物理磁盘的存储区域被划分为柱面、磁道、扇区是由哪类过程实现的?这个过程的 提供者是?
- 将磁盘物理空间划分为不同的逻辑磁盘的步骤是?
- 根据文件系统为各个逻辑磁盘装入文件系统相关信息的过程被称为?
- 在传统 BIOS/MBR 引导中,MBR 依据什么信息找到要引导的分区?多操作系统的用户选择通常由哪个组件提供?
- BIOS 被存放在内存还是外存中?存储介质是 ROM还是 RAM?为什么?
- 图形界面相关的程序运行在用户态还是内核态?
- 用户点开图形文件本质上还是与文件系统发生了交互从而访问了目录系统中的某个文件,请问目录系统中的根目录是何时被写入磁盘的?
- 用户双击鼠标后,操作系统会对这次鼠标操作行为进行处理,并最终与文件系统发生了某种交互。请问操作系统对鼠标行为进行反馈利用了何种机制?计算机为何可以对 鼠标点击行为作为对应的反馈?这种建立鼠标操作与系统反馈联系的步骤发生在正文 提及的哪个过程中?
- 操作系统完成加载和初始化后,应用程序将在其支持下工作。这里讨论的应用是可执行二进制文件;按前文细分的 C 工具链,形成可执行文件经过预处理、编译、汇编、链接四个阶段,可执行程序装载后才能运行。关于这个过程,请回答以下几个问题:
- 程序在加载到内存时,会被分为代码段、数据段、.bss 段、堆栈区,这些区域哪些是程序加载前就在逻辑上存在的,哪些是在加载后重新分配的?
- 静态链接下,程序的虚拟地址空间是何时形成的?
- 在静态重定位和动态重定位下,数据的物理地址分别是在什么时候形成的?
- 在现代操作系统中,程序的执行与进程有什么关系?
- 在上述表述中,我们有时候会说是 BIOS 程序加载了MBR,有时候则会描述为 CPU 加载了MBR,这两种表述有什么联系?在后续操作系统的学习中你还可以举出类似的例子吗?
Scenario 2 - 进程控制块
场景一:进程控制块
进程控制块 PCB 是进程存在的唯一标识,其内部存放了操作系统用来管理进程的全部信息。本场景将对所有与 PCB 有关的考纲范围内的知识进行一个串联 进程控制块的基本定义和组织方式第一个问题,进程控制块是什么?我们可以看一下内核代码中对于进程控制块的一个简 单的部分定义:
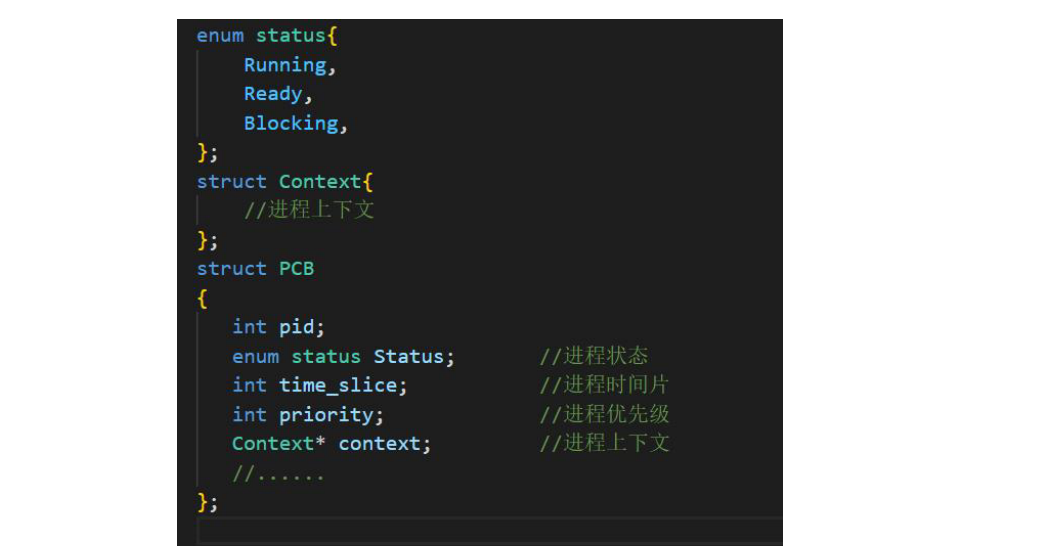
可以看到,PCB 是一个结构体,其中的属性代表了其所对应进程的信息。至于这些属性的功能我们会在下文中讲解。操作系统组织 PCB 的方式非常灵活,在 408 中经常用“队列”来形容 PCB 的组织结构,但是这里的队列不一定就是数据结构中严格的先进先出队列,也可能是用数组,链表,甚至优先级队列等方式来组织的,队列在这里只作为一种特定的称呼。与此同时,不同类型的进程 PCB 也可以设立不同的队列,如就绪队列,不同阻塞条件下的阻塞队列等。当操作系统需要找到某一类型的进程时,只需要去对应的 PCB 队列中寻找即可。例如,在进程调度中,为了寻找占用 CPU 的下一个进程,操作系统会去就绪队列中寻找合适的进程。 根据上述描述,请回答以下问题:
- 用户程序能否访问自身的 PCB?为什么?
- 所有位于阻塞态的进程是否应该位于同一个阻塞队列中?为什么?
场景二:进程控制块与进程调度
这个分场景分析 PCB 是如何参与到进程调度的过程中的,在这个过程中的全部场景都是单 CPU 单核操作系统,也就是说同一时间只有一个进程能够占用 CPU。进程调度的触发依赖 PCB 中存放的信息。 首先,操作系统会维护一个全局变量 current(在不同的 os 中可能实现不同,这里主要介绍原理性的内容),来指向当前进程的 PCB,通过访问 current,操作系统可以获取当前进程的全部信息。每次发生特定的中断或异常时,操作系统都会对 current 进程进行分析,从而判断是否应该发生进程调度。 在这里采用的时间片轮转教学模型中,进程 PCB 维护时间片字段
time_slice。处理时钟中断时,操作系统将当前进程的time_slice减 1;计数为 0 时标记需要调度,在允许抢占的位置选择下一个就绪进程。 在抢占式优先级调度中,发现新进程创建完成或某个进程从阻塞态转为就绪态后,操作系统比较其priority与current进程的优先级。若新就绪进程更高,则请求在允许抢占的位置调度;优先级也保存在 PCB 等调度信息中。 在协作式调度设计中,进程可以通过特定的系统调用主动放弃 CPU,从而完成各进程共同使用 CPU 资源。在现代操作系统中,通常协作式调度和抢占式调度是同时存在的,也就是说,进程既可以主动放弃 CPU,也可能因为特殊时间的触发被抢占 CPU。 进程调度中新进程的筛选依赖 PCB。 当当前进程需要调度时,进程会从就绪进程队列中选出一个合适的 PCB 作为新的 current 进程来使用 CPU。若采取优先级调度算法时,会选择优先级最高的进程来占据 CPU。 若采用多级反馈等调度算法时,不同优先级的进程会组织成不同的就绪队列。 进程切换也需要 PCB 的参与。 进程切换时,操作系统利用当前进程和待运行进程的 PCB 及其引用的上下文保存区完成切换。主要执行上下文包括恢复执行的位置和必要的寄存器值;这些值可以保存在 PCB 本身或其关联的内核栈等结构中,切入时再恢复。对本场景中地址空间相互独立的进程,还需切换地址空间:分页系统的页表基址寄存器 PTR 选择根页表,PCB 中保存或引用相应页表基址,切换时据此装入新值。若是同一地址空间内的线程切换,则通常保留页表基址;共享地址空间的其他切换也应按实际情况处理。 在此处的单线程进程模型中,各进程拥有自己的用户执行栈和内核栈,进程切换也要恢复相应栈指针;PCB 及其引用的上下文保存结构记录这些信息。扩展到多线程时,各线程仍各自维护执行栈,而同一进程的线程共享地址空间。基于以上描述,请回答下列问题:
- 进程切换完成后,current 变量会发生什么变化?原本的当前进程如何处理呢?
- 同一进程的不同线程发生线程切换时,上文描述的上下文切换、地址空间切换和堆栈切换哪些会发生哪些不会发生?为什么?
- 若使用优先级调度算法,应该用什么数据结构来组织就绪队列效率最高?为什么?
- 若根页表总是占用占用一个完整的页框,则 PCB 中保存的 PTR 的值可以做哪种优化?
- 协作式调度与抢占式调度当前进程决定放弃 CPU 的时机有何不同
场景三: 标识状态
进程控制块中保存了进程此时的状态,当一个进程创建另一个进程时,操作系统为其分配进程控制块 PCB,从进程获取 PCB 到创建完成的过程中,进程均属于创建态,此后,根 据具体的状态变化,进程 PCB 中标识状态的字段也会随之发生变化。 PCB 中与文件系统相关的重要资源包括进程级文件描述符表的入口。该表通常以数组或其他结构存放在内核区域,PCB 保存或引用它。打开文件时,操作系统通过
current找到该表,分配一个描述符表项;表项通常先指向系统级打开文件对象(打开文件描述),后者保存当前偏移、文件状态标志,并引用内存中的 inode/vnode 等元数据。成功的open返回这个进程表项对应的整数描述符。后续读写通过描述符找到打开文件对象,再访问元数据和实际数据块。PCB 还保存或引用进程占有的系统设备等资源信息,这些信息对死锁检测、死锁避免等算法很重要。
Scenario 3 - 操作系统系统调用和中断处理全过程
假设在计算机系统中有 4 种类型的可屏蔽中断 I1、I2、I3、I4,其中断响应的优先级为 I1>I2>I3>I4,其中断处理的优先级为 I2>I3>I1>I4,其中,I4 表示键盘设备中断。 进程 P1 的代码如下:
scanf("%d", &a); printf("%d", a);计算机使用阻塞式 I/O方式,回答以下问题:
- 请给出题设涉及到的中断类型的中断屏蔽字表
- P1 进程在执行语句 scanf()前后,请简述进程 P1 的状态变化过程。
- scanf 执行,键盘输入了 5 并按下回车,键盘输入的数据被传递到了对应位置,对于这个过程,回答以下问题:
- 计算机系统通过什么方式得知键盘产生了输入的?此时键盘数据被存放在什么位置?
- 键盘输入后,若无其它中断产生,计算机会进入哪几个处理阶段?
- CPU 是如何从键盘设备取出输入数据的?控制取数据的过程是由什么程序来完成的?这个程序是在中断过程的哪个阶段被调用的?
- 在这个过程中,硬件完成了哪些功能?
- 响应键盘设备中断后,外设又产生了 I1 中断,CPU 一定会立刻响应 I1 中断吗?为 什么?
- 从用户程序视角来看,scanf()实际上就是把键盘存放的数据读入到变量 a 中,对于这个过程,请回答以下问题:
- 传送变量 a 的地址发生在用户态还是内核态?
- 用户程序触发的是中断还是异常?是如何触发中断或异常的?
- 系统捕捉用户申请系统调用的具体类型依靠的是硬件还是软件功能?
- 系统是如何跳转到系统调用服务程序的执行位置的?
- 简述在此例中系统调用执行过程是如何与键盘外设中断发生联动的。
Scenario 4 - 进程与线程
场景一:进程间通信
进程 P1 和进程 P2 希望实现进程间通信,有三种可以选择的方式:
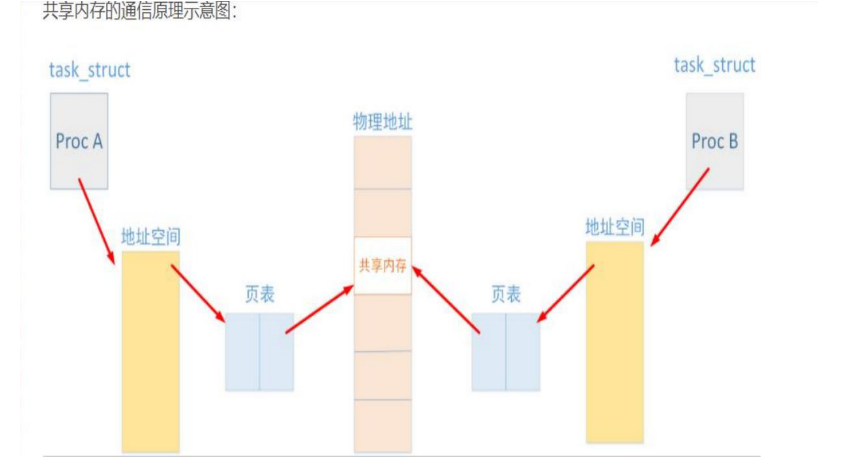
- 共享存储; 共享存储就是修改不同进程的段表/页表,让它们投射到同一块物理内存中:
原笔记配图 8
- 消息传递系统; 消息传递系统分为直接通信方式和间接通信方式
- 管道系统; 进程 A 建立了一个匿名管道 pipe,进程 B 通过 pipe 与进程 A 进行通信
- 共享的内存是位于内核空间还是进程的用户空间?
- 建立共享内存的操作是在用户态还是内核态下完成的?为什么?
- 访问共享数据的操作是在用户态还是内核态完成的?为什么?
- 进程 P1 和 P2 共同使用动态链接库 S,且采用运行时动态链接 的方法,S 装入内存时的物理页帧号M,P1 的页表中关于 S 的页表项对应的页面号为 N, 则下面说法中正确的是()
- A.P2 中关于 S 的页表项对应的页面号也为 N,且其中保存的物理页帧号为M。
- B.S 装入内存时,P1 和 P2 的页表中均包含了物理页帧号为N 的页表项。
- C.该计算机中必须有支持动态重定位功能的硬件
- D.在 P1 和 P2 执行的全部过程中,S 在内存中的位置都不能发生改变
- 直接通信方式下,进程的 PCB 应该增加什么属性?进程发送的message 至少应该 附加什么属性?进程发送和接收消息的区域属于用户空间还是内核空间?
- 间接通信方式下,除了message 以外,发送接口还需要提供哪些信息?接收方呢? 信箱中的消息还应该包含哪些附加属性?
- 进程 B 与进程 A 是什么关系?二者通过什么接口访问管道?答:常见例子是先建管道再 fork,由相关进程继承端点;但仅凭题目描述不能唯一确定二者是父子进程,描述符也可以经其他机制传递。实际读写使用管道文件描述符以及 read、write 等接口。
- 进程 A 希望给进程 B 传送字符 “abcdefg”,B 也希望给 A 传送 “1234567”。若双方尝试使用同一个匿名管道,在 A 写入的数据尚未被 B 读出前,B 能否写入?为什么?答:若 B 持有有效写端且管道有足够空间,未读数据本身不禁止 B 写入;一个管道是字节流,不能据此区分两个通信方向,还可能读到自己写入的数据。为实现这两条消息的双向传递,通常用两条管道,各负责一个方向。
- 仍以第 8 问的发送内容为背景,按阻塞式管道模型,A 写入 “abcd” 后去完成一次 I/O,B 读完这 4 个字符后继续读该方向的管道,会发生什么,何时改变?答:若管道已空但仍有打开的写端,B 等待或阻塞;新的数据写入后可以继续读。若全部写端关闭且已有数据读尽,read 返回 0,表示 EOF。
- 当前所有进程都关闭了管道的读端,管道是否会立即撤销?为什么?答:POSIX 管道此时没有接收者,后续写入会触发 SIGPIPE,并在调用能够返回时以 EPIPE 报错;但尚未关闭的写端仍持有管道对象的引用。对象通常在全部相关引用关闭后才释放,读端全部关闭本身不意味着立即撤销。
- 对管道的读操作需要互斥进行吗?为什么?
- 操作系统中的管道数据结构应该包含的元素有()
- ①内核缓冲区 ②读指针和写指针 ③两个阻塞队列 ④互斥锁
- A. ①②③④ B.①② C.①②③ D.②④
Scenario 5 - 进程地址空间
场景一:进程地址空间
场景描述: 在这个场景中,我们将以请求页式管理为背景,为大家展示“地址空间”这个在操作系统 中至关重要的概念,与此同时,我们也会穿插 TLB 和 chche 等设计,为大家展现用户程序 访存的全过程。 M是一台支持二级页表的计算机,物理内存大小为 4MB,包含 TLB 和 chche,其中 cache 采用直接映射的方式,共有 16 个 cache 行,每个 chache 行的数据部分容量为 256B。M按字节编址,使用定长指令,每条指令的大小均为 4B。 使用操作系统 N 对 M 进行管理,该操作系统支持多进程和内核级线程,采用虚拟页式存储管理,进程的寻址空间为 256MB,页面大小为 1KB,页目录表和页表的大小均为一个 页,且表项大小均为 2B,表项包含存在位和物理页框号以及访问权限位,其中最高位开始 的连续 k 位为物理页框号,最低位为存在位,剩下的则全部为权限位。 现在系统中存在两个进程 P1 和 P2,P1 又创建了三个由操作系统负责管理的线程 T1、 T2 和 T3,我们展示部分内存内容:
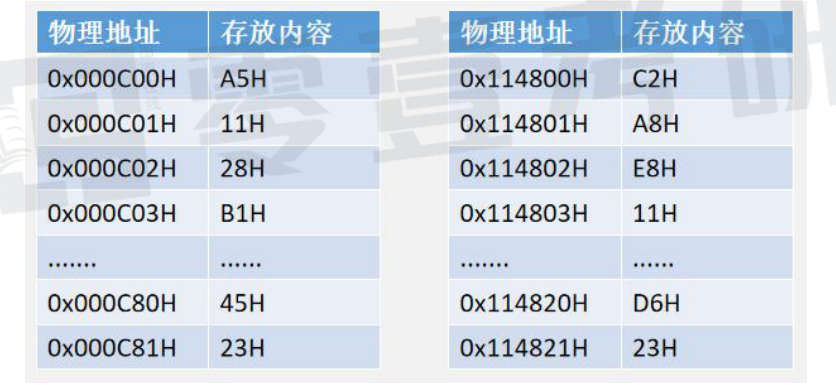
当前正在执行的为进程P1下的线程 T1,此时页表基址寄存器PTBR的值为0x000C00H,SP 的值为 0x0000020H 在这个场景下,请回答下列问题:
- k 的取值是多少?
- 已知 T1 访问逻辑地址
0x2000400H,则其对应的物理地址是多少? - 若该过程中既发生了 TLB 缺失,也发生了 cache 缺失,则 TLB 中应该加入的表项中的逻辑页号与物理页框号分别应该是多少?cache 中哪一行应该被装入内存块数据,其标记位应该为多少?
- 若发生了线程切换,切换到 T2 执行,此时 PTBR 和 SP 寄存器会发生变化吗?T2 希望访问逻辑地址
0x2000000H, 则会发生什么情况?为什么?该过程包含哪些具体操作? - 若发生了进程切换,P2 希望访问逻辑地址
0x2000400H, 此时 TLB 和 cache 是否一定命中?为什么? - 如何防止 P1 进程写一个允许 P1 “只读"的数据,该检测过程由软件还是硬件完成? 若 P1 试图写“只读”数据会造成什么结果?
- 若用户进程试图访问页表,会发生什么现象?为什么?
场景二:内存分配各方式性能分析
场景描述: 内存分配方法 从整体上来说包含连续分配方案和非连续内存分配,其中连续内存分配分为单一连续分配、固定分区分配和动态分区分配;而非连续内存分配主要包含页式管理、段式管理和段页式管理。 关于这些方法,请回答下列问题:
- 哪种方法只能运用于单道程序系统?
- 哪些方法会产生内部碎片?哪些方法会产生外部碎片?
- 动态分区分配中分配空闲块的方式主要有哪些?其中使用哪种方法最容易产生碎片?使用哪种方法会导致大的空闲块总是被破坏?
- 页式分配和段式分配哪个更有利于对程序进行共享和保护?为什么?
- 假设计算机中可分配的物理内存空间为连续的 1024MB,采用伙伴系统来进行内存分配,现有 3 个进程 P1、P2 和 P3 均需要 100MB 的内存空间,请描述一下以下各操作后内存中的空闲内存区域情况,并分析每一次操作涉及几次内存块分割或内存块合并,描述方法 为:${\displaystyle [}$空闲空间起始地址,空闲空间结束地址) 例如若 ${\displaystyle [350MB,400MB )}$ 和 ${\displaystyle [450MB,500MB )}$ 两块内存空间被占用,则描述方式为: ${\displaystyle [0,350MB)、[400MB,450MB)、[500MB,1024MB)}$ 初始时内存空间为空,各进程操作步骤为:
- P1 申请 100MB
- P2 申请 100MB
- P3 申请 100MB
- P2 内存被回收
- P1 内存被回收
- P3 内存被回收
- 请将上述场景和问题制作成思维导图以加深个人记忆与理解。
场景三:缺页中断
场景描述: 在这个场景中,我们将通过一个实例,来解析发生缺页中断时,操作系统所做的工作。 当我们访问某逻辑地址时,若该逻辑地址所在的页面不在内存中时,将发生缺页中断,缺页中断主要做以下工作:
- 页框分配:即准备一个空闲页框来放置从磁盘中装入的进程页面,在这个过程中,如果操作系统分配给进程的页框已经全部被使用,则需要调用页面置换算法,将某个已在内 存中的页换出内存。
- 页面装入:从磁盘中找到对应的页面,将其装入我们分配好的空闲页框内。 在这个场景中,我们使用DMA 方式来实现磁盘与内存间的页面交换,同时研究一些与页面交换相关的知识。
- 关于页面的置换和装入过程,请回答下列问题:
- 一次缺页置换最多需要发生几次DMA传送?什么情况下需要这么多次DMA传送?
- 在DMA 传送之前,设备驱动程序需要先做哪些准备工作?
- 进程何时被阻塞,又何时被唤醒?
- 在DMA传送的过程中,正在被传输数据的物理页框能否被其它进程抢占?为什么?若采用页缓冲的方式进行传送,是否会有不一样的答案呢?为什么?
- 一次缺页中断的处理最多可能有几个页表项发生变化?分别可能发生什么变化?
- 页面存储在磁盘连续的扇区上通常可以节约 I/O 时间?为什么?
- 缺页中断属于中断还是异常?
- 局部置换、全局置换和不变分配、可变分配分别表示什么含义?置换与分配方法之间支持哪些组合方式?
Scenario 6 - 文件系统
场景一:文件系统综合
场景描述 在这个场景中,我们将把整个文件系统部分的所有内容都尽可能串联起来,如果你能在以后的学习中自己把这个场景给重现出来,那么你的文件系统部分就没有太大的问题了。言归正传,我们正式开始。
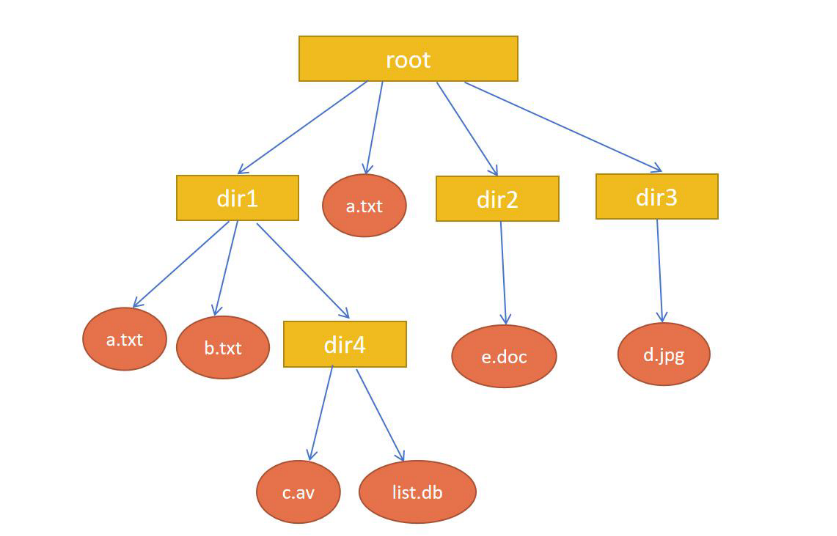
原笔记配图 10
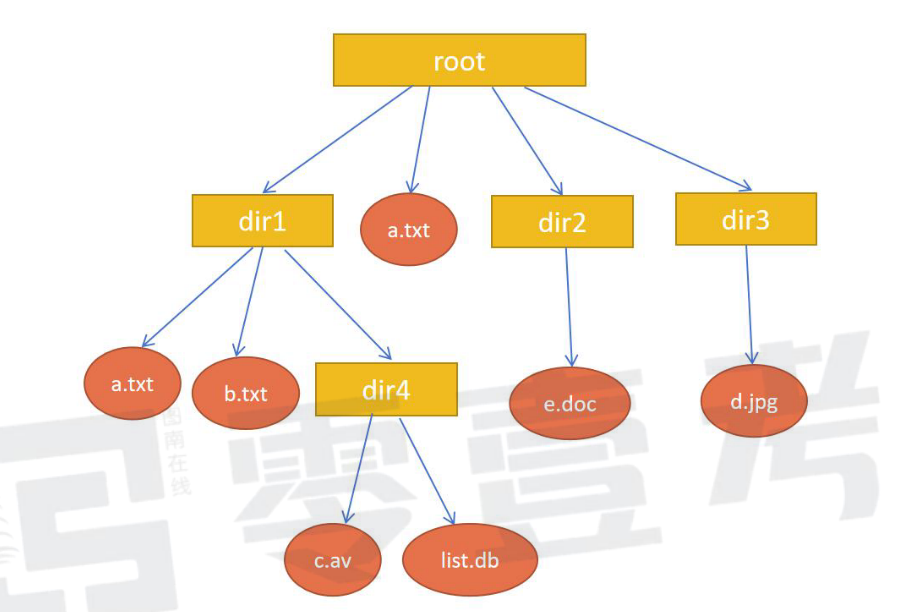
上图是一台计算机中的目录系统结构图,其中 list.db 是数据库文件,其中记录了一个学校的所有学生的信息,单个学生的信息作为文件中的一条记录,由于每个学生的学号都不相同,所以我们以学号作为每一条记录的关键码,我们对这个数据库文件最常见的操作就是依 据学号检索学生的信息以及与之相关的增删改查操作,这些我们会在后面有所展现。 下面,请先回答以下几个问题
- 在访问 list.db 的用户的视角下,文件中的数据是连续存放的还是离散存放的?
- list.db 该文件是流式文件还是有结构文件?
- 当文件的逻辑结构分别为顺序结构、索引结构、直接或散列结构时,如何通过记录的关键码定位该记录在文件中的逻辑地址?
- 文件的逻辑地址是相对用户来说还是操作系统来说的?对于这种设计你还在前面学习过哪个类似的概念?
在该文件系统中,一个磁盘块的大小被设计为 1KB,list.db 文件中所有记录的大小总和为 102656B。现在,某用户希望读取学号为”6661314”的同学的全部信息,经过分析,我们 得知存储该同学信息的记录在文件中的逻辑地址为 51548B,且该信息的大小为 128B。下面 我们将具体分析为了完成这一过程,我们的操作系统做了哪些工作。 首先,为了访问 list.db 文件,进程必须先打开该文件,打开的步骤如下:
原笔记配图 11
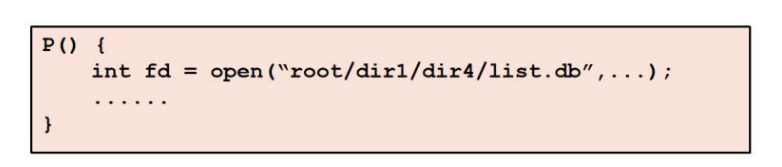
已知 P 进程是第一个打开 list.db 的文件,且一个磁盘块中刚好可以放入两个目录项,关于这个过程,请回答如下问题
- 请问这个过程中被放入内存中的信息包括下面哪些?
- list.db 的 inode
- dir4 的 inode
- list.db 的文件实体
- dir4 的文件实体
- 用户级打开文件表和系统级打开文件表分别发生了什么变化?fd代表了什么含义?
- 若进程 P2 执行了同样的 open 操作,则用户级打开文件表、系统级打开文件表又会发生什么变化?若其返回值赋值给 fd2,则 fd2 和 fd 相等吗?
- 已知目录中的目录项按照顺序结构来组织,则 P 进程打开 list.db 的操作最多需要几次磁盘 I/O?
- root 目录是何时创建的?操作系统如何访问 root 目录?
- 为了后续读取 list.db 中的对应记录,open 操作处文件名外的其它参数有什么要求?
此后,进程开始读取 list.db 中的相关记录,根据上文我们知道其在文件中的逻辑地址为 51548B,读取长度为 128B,我们将记录读入提前准备好的数组 buffer 中,其具体操作如下:
原笔记配图 12
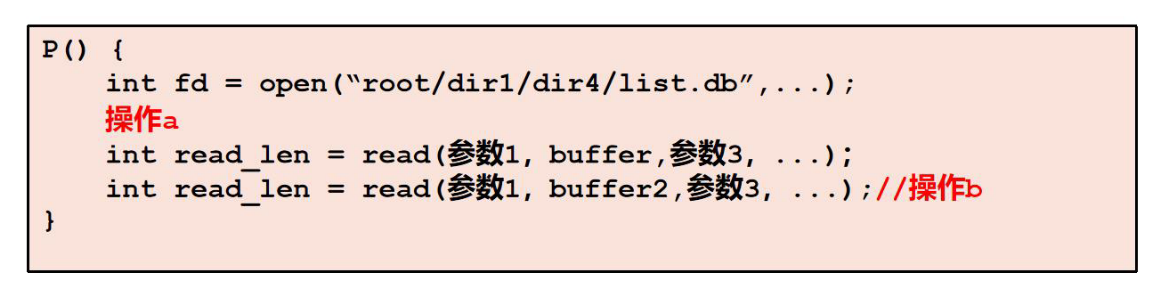
原笔记配图 13
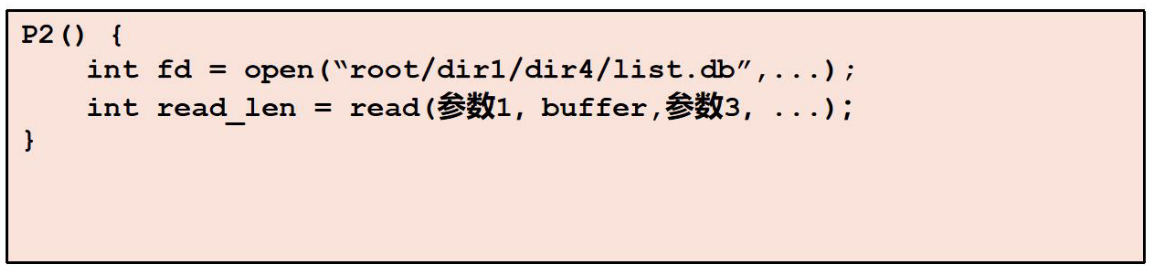
请回答下面的问题:
- 请问图中的操作 a 具体完成什么功能?
- read()函数中的参数 1 和参数 3 分别是什么?
- 若在完成此操作后,P 进程继续执行了操作 b,则 buffer2 中读入的数据在 list.db 中的文件逻辑地址是什么?为什么?
- 刚才同样打开 list.db 的进程 P2 也试图访问文件,其操作如 P2, P2 的参数 1 和参数 3 与 P 的相同,请问 P2 读入 buffer 的数据和 P 读入 buffer 的数据一样吗?为什么?
- 此时又有第三个进程 P3 试图对 list.db 进行写操作,则其 open()的参数与 P 和 P2 比有什么区别?
- 这个 open()操作能够成功的前提条件是什么?完成 open()操作后,用户级打 开文件表和系统级打开文件表又会发生什么变化?
假设以上所有的操作均成功完成了,此时进程P、P2、P3 依次打开和访问了文件 list.db, 接下来P、P2、P3 依次关闭了文件 list.db,其中 P 具体操作如下:
原笔记配图 14
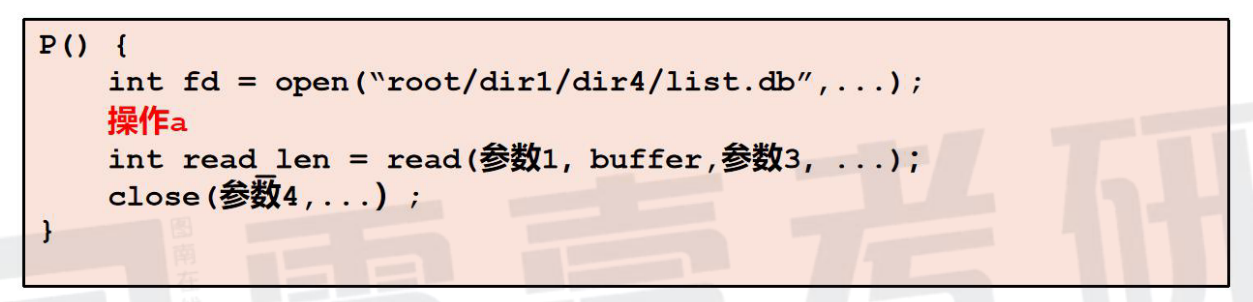
- 上图中的参数 4 是什么?
- P 进程的 close()操作完成后,用户级打开文件表和系统级打开文件表有什么变化?
- list.db 放入内存中的 inode 会被移出内存吗?为什么?P2 完成 close()和 P3 完成 close()后呢?
接下来,我们继续探索操作系统是如何定位该记录(逻辑地址 51548B)在磁盘中的具体位置的,这就涉及到了对文件物理分配的组织方式,针对这一过程,假设 list.db 的文件元数据已经放入内存, 请回答下面的问题:
- 该文件的文件实体(共 102656B)占据了磁盘中的多少个磁盘块(单个磁盘块大小为 1KB)?其中,该记录位于文件的第几个文件块?前一个问题的答案是逻辑上的还是物理上的?
- 若文件物理分配采用连续分配方式,则其文件元数据中存放的物理地址字段中的内容是什么?读取该记录需要几次磁盘 I/O?
- 若文件物理分配采用链式分配方式,则其文件元数据中存放的物理地址字段中的内容是什么?读取该记录需要几次磁盘 I/O?
- 若文件物理分配采用 FAT 方式,则其文件元数据中存放的物理地址字段中的内容是什么?读取该记录需要几次磁盘 I/O?
- 若文件分配采用混合索引方式,文件元数据中包含 10 个直接索引,1 个一级索引和 1 个二级索引,且每个地址项的大小为 4B,则读取该记录需要几次磁盘 I/O?该文件系统支持的最大文件长度是多少?
- 该文件一共分别占用了几个磁盘数据块和磁盘索引块?
上面分析了我们应当对哪些磁盘块进行 I/O操作,下面我们来看一看如何具体来做对对应磁盘块的 I/O 操作。 首先,文件系统想要将磁盘的盘块读入内存或将内存内容写入磁盘块,就需要更底层的程序提供直接读取磁盘块的接口,关于这个过程,请回答下列问题:
- 提供给文件系统直接读取磁盘块接口的是什么程序?该程序可以与 I/O 设备的哪个部分进行数据交互?
- 此处读写磁盘块与上述场景的页面置换均一般使用 DMA 方式进行数据传送
- 操作系统如何得知 DMA 传送已经完成?当 DMA 传送完成时数据被存放在什么位置?如果是采用 I/O 中断方式的字符型设备,当设备发出中断后,被读出的数据位于什么位置
为了提高系统性能,我们在内存中设置了磁盘块的缓存区,关于缓存区,请回答下列问题
- 缓存区位于用户空间还是内核空间?
- 进程想要访问某个磁盘块的话,操作系统会先进行什么操作?
- 若进程想要访问的磁盘块不在缓存区内,操作系统又会进行什么操作?
- 为什么设置缓存区可以提高系统性能?
- 当负责磁盘数据传输的 DMA 控制器发出 I/O 中断时,数据是否已经位于缓存区内了?为什么?
理清了访问 list.db 文件中对应记录的全过程,我们实际上还有一些细节问题还没有解决,关于这些问题,我们来一个个讨论:
原笔记配图 15
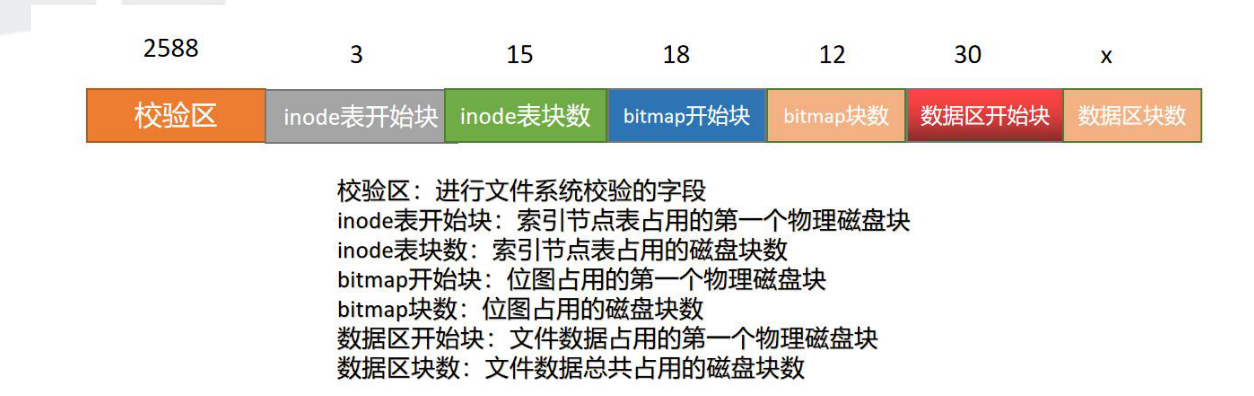
该图展示了超级块 superblock 的各个字段及其含义,在每个字段上方标注了其具体值。该文件系统磁盘块的大小为 1KB,一个索引节点(inode)的大小为 4B,依据上述信息, 请回答下列问题:
- superblock 中的信息是何时写入的?
- 校验区的作用是什么?
- 该文件系统最多可以存在多少个文件?
- 若不考虑磁盘容量,数据区最多可以存在多少个磁盘块?
- 若 list.db 的 inode 编号是 326,则其inode保存在物理磁盘的几号盘块(0开始计数)?它是该盘块中保存的第几个 inode?
若该文件系统被挂载到了另一个文件系统的目录 dir6 下,如图所示:
原笔记配图 16
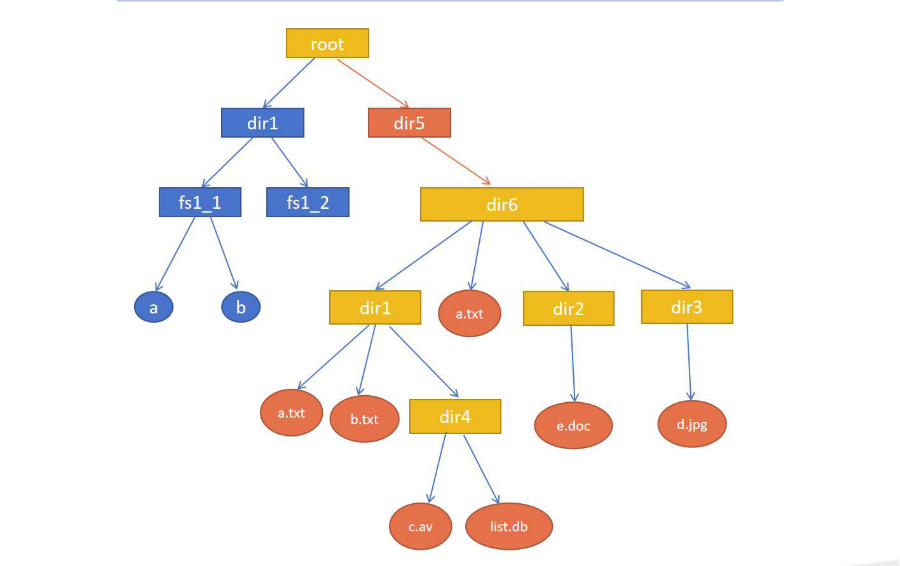
其中,fs1_1 和 fs1_2 是其它挂载的文件系统,请回答下面问题:
fs1_1、fs1_2 和 dir6 所代表的文件系统一定符合同样的文件物理分配方式吗?
对于访问 list.db 中某一记录的全过程, 对应的如下:
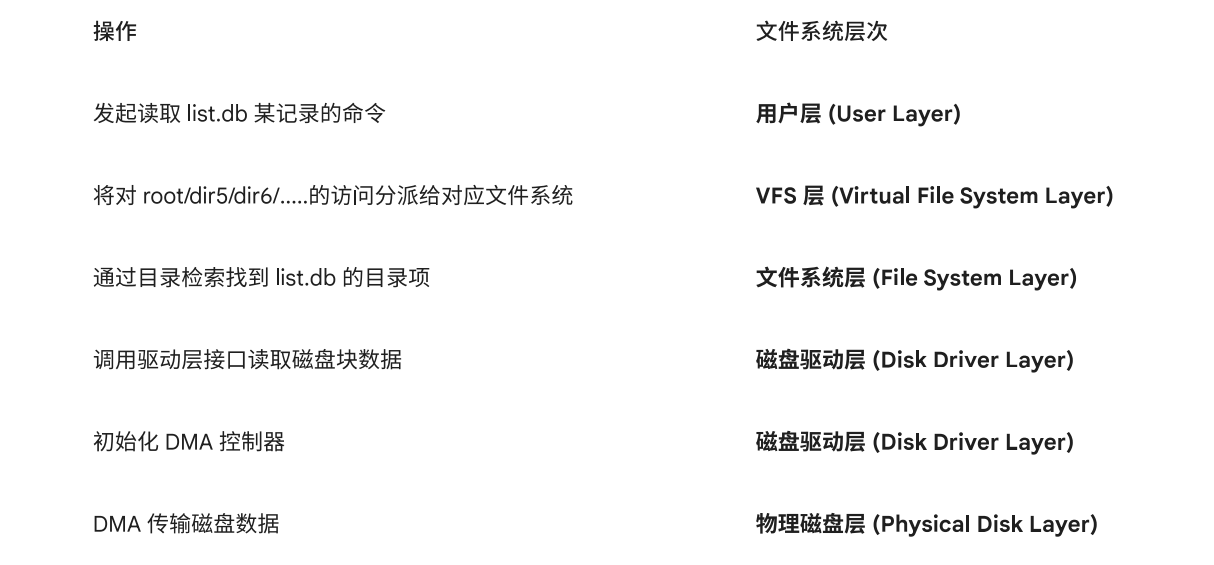
原笔记配图 17
接下来,我们来讨论一些其它的文件操作。为了简便,我们回到我们原来的文件系统下来进行分析:
原笔记配图 18
首先,我们对 list.db 进行写入操作,并且在它的末端一直写入记录,直到分配给该文件的最后一个磁盘块都被写满了,此后我们继续写入,则文件系统需要给该文件分配一个新的 空闲盘块,请回答以下问题:
- 若文件分配采用直接索引分配,则会对该文件的索引做什么操作?
- 若管理空闲磁盘块的方法是位图法,则如何为文件分配一个新的磁盘块?
- 若管理空闲磁盘块的方法是成组链接法,且 0 号分组(即首个分组)中仅剩唯一一个索引块,则进行一次空闲盘块分配后,各分组和内存中的索引块会发生哪些变化
我们删除文件 list.db,当检测到某种条件成立时,系统选择释放 list.db 所占有的全部磁盘空间,请回答以下问题:
- 题干中的某种条件是指什么条件?
- 除了释放 list.db 的所有空间以外,文件系统还会做哪些操作?
- 若管理空闲磁盘块的方法是位图法,则如何释放文件曾经占用的磁盘块?
- 若管理空闲磁盘块的方法是成组链接法,且 0 号分组的盘块数量达到上限,则回收磁盘块后,各分组和内存中的索引块会发生哪些变化?
- 现在,分别建立 root/dir1/a.txt 的硬链接 root/dir1/dir4/01.txt 和软链接 root/dir1/dir4/02.txt, 请回答下列问题:
- 请简述建立硬链接的具体过程;
- 请简述利用软链接访问某记录的具体过程;
- 若删除硬链接 01.txt,还能访问软链接 02.txt 吗?为什么?
计算机网络
目前需要记忆的: 1. 语法, 语义, 时序(同步)的具体含义; 数字数据编码(曼彻斯特等); 802.11 数据帧格式(AP); CSMA/CD/CA 的退避算法具体过程; CSMA/CA 协议帧间间隔, 信道预约过程与 NAV 值; DHCP报文类型; ICMP 报文类型; OSPF 分组类型; BGP 报文类型; 应用层的各个协议的端口号; IPv6; TCP 从建立到结束完整过程(包括阶段名称); 信号调频调制各种模式; IP 地址各字段意义, NAT 的特殊 IP; 网络层中虚电路与数据报的特点; Ip 地址的类别; 2. PPP 帧; SDN基本概念; 移动 IP; FTP;独立的网络文件系统协议 NFS;
未加 VLAN 标签的标准以太网 MAC 帧长度为 64~1518B,其中数据及必要填充为 46~1500B;18B 是 MAC 首部 14B 与 FCS 4B 的合计开销。上述帧长不包括前导码、帧开始定界符及帧间间隔。
波特率 $B$ 与数据传输率 $C$ 的关系为 $C=B\log_2N$。$N$ 是每个码元可选择的不同状态数,不是已经发送的码元个数;每个码元携带 $\log_2N$ 比特。可以把 $N$ 种状态理解成一个 $N$ 进制符号的取值集合。
各个协议对应的网络体系:
- 链路层:PPP、HDLC、CSMA
- 网络层:ARP、ICMP、IP、OSPF
- 传输层:TCP、UDP
- 应用层:DHCP、RIP、BGP、DNS、FTP、POP3、SMTP、HTTP、MIME
对 HTTP/1.x 的简单请求/响应,若要新建 TCP 连接,可使用忽略 DNS、TLS、发送时延、处理时延及丢包重传的理想模型:客户端经过 1RTT 收到 SYN+ACK,第三次握手可携带 HTTP 请求;请求再用半个 RTT 到达服务器,响应再用半个 RTT 返回,合计约 2RTT。服务器收到第三次握手是在开始后的约 1.5RTT,但这不意味着客户端须等待 1.5RTT 后才发送请求。
- 若已经确认 TCP 连接处于建立状态,简单请求/响应在上述模型下约需 1RTT。仅凭某个报文的 SYN=0 不能证明连接已经建立,还要结合连接状态和报文上下文,例如复位报文也可不置 SYN。
- HTTP/1.0 通常按非持续连接计算,每个对象新建 TCP 连接,因而约需 2RTT 加对象发送时间。
- HTTP/1.1 持续连接的非流水方式通常逐个等待响应;流水线可连续发出多个请求,共享一轮请求等待,但响应的数据量、按序返回要求和发送时间仍影响总耗时,不能把多个完整响应的时间一概写为 1RTT。
IPv4 数据报沿传输路径可能变化的字段,应按具体机制判断:
- 私网内部通信不一定需要 NAT。典型出口源地址转换会在出站时按映射修改源 IP,回包则按已有映射修改目的 IP;其他目的地址转换策略也可能存在。是否修改取决于地址映射与策略,而非简单的发送方或接收方身份。
- 每经过一个正常转发它的路由器,TTL 递减,并相应更新 IPv4 首部校验和。
- 当出接口 MTU 较小时,若允许分片,分片会改变总长度、MF、片偏移等字段,并重算各片的首部校验和;同一原始数据报产生的各片保留相同的 Identification。DF=1 时路由器不得分片,不能为了分片擅自清零 DF。
- 移动 IP 隧道增加外层首部,外层目的地址可为转交地址;被封装的内层数据报仍保留移动节点的永久目的地址。
数据链路层既可提供可靠服务,也可提供不可靠服务,取决于具体协议和工作模式。
- Ethernet MAC 通常提供无连接、不可靠服务:FCS 可检测帧差错,错误帧被丢弃,接收端不为 FCS 差错或帧丢失提供 ACK 和重传机制。半双工 CSMA/CD 检测到碰撞后的退避重传属于另一种机制。
- HDLC 的适当有确认工作模式可利用序号、ACK、ARQ 和窗口提供可靠链路服务;标准 PPP 不提供数据帧序号、确认重传或可靠交付,不能把这些 HDLC 机制直接归给 PPP。
- 802.11 无线 MAC 对通常的单播数据帧使用帧级 ACK 和重传,能提高帧交付可靠性,但仍受重试限制等条件约束,不保证绝对交付。
以太网交换机的两种工作模式:
- 直通交换:读出目的 MAC 地址并确定出口后即可开始转发,启动时延较小,通常不能在转发前检查完整帧的 FCS。教材简化模型中的 6B 指启动转发前读取的目的地址长度,交换机仍须转发整帧。
- 存储转发:先接收并缓存整帧,再检查 FCS 和决定是否转发;启动时延较大,未加标签的标准 MAC 帧至少为 64B。它能过滤检测到差错的帧,但不因此提供可靠交付或自动重传。
路由表中可以出现类似 128.20.96.0/23 和 128.20.96.128/25, 因为转发时遵循掩码最优原则
路由协议中, RIP 是应用层协议, 利用 UDP 传输; OSPF 是网络层协议, 利用 IP 传输; BGP 是应用层协议, 利用 TCP 传输;
时延带宽积是任意时刻在信道传输的最大比特数, 时延带宽积 = 传播时延 ${\times}$ 信道带宽, 表示信道能够容纳的最大比特数
香农定理、奈奎斯特定理与信噪比:
- 香农公式给出带限高斯噪声信道的理论最大可靠信息传输速率,即信道容量 $C=W\log_2(1+S/N)$。$W$ 以 Hz 为单位,$S,N$ 分别为信号和噪声功率。公式中的 $S/N$ 必须为线性比值;若以 dB 给出,应先转换。例如 $S/N=1000$ 对应 $10\log_{10}1000=30\mathrm{dB}$,不能把 30 直接代入容量公式。
- 在理想无噪声、带限等条件下,奈奎斯特公式为 $C_{\max}=2W\log_2V$;$V$ 是每个码元可选择的不同状态数,不是已发送的码元总数。
- 区分发送速率与传播速度:前者用 bit/s 或 Baud 描述,后者是信号在介质中前进的速度,通常用 m/s 描述。
- 信噪比提高既可能来自信号功率增加,也可能来自噪声功率减小。在其他条件相同时,更高的信噪比通常有利于降低误码率,但不能由信噪比提高就断定信号功率或每码元能量必然增大。
- 每码元能量满足 $E_s=P_s/R_s$。在信号功率 $P_s$ 固定、调制等条件适当时,降低码元速率 $R_s$ 会增加每码元能量。仅说明信噪比固定不足以推出该能量变化;若讨论比特率,也要明确每码元比特数是否固定。
数据链路层可靠传输机制(ARQ)中的窗口:
- 停止等待协议 S-W:发送窗口和接收窗口均为 1。
- 后退 N 帧 GBN:采用 $n$ 比特序号时,接收窗口为 1,发送窗口满足 $1\le W_T\le2^n-1$;窗口大于 1 时体现流水发送。
- 选择重传 SR:在常见有限序号空间模型中,发送、接收窗口为 $W_T,W_R$,须满足 $W_T+W_R\le2^n$。$W_T\gt W_R$ 并不意味着必然丢帧,是否收到窗口外的帧取决于在途帧和窗口推进时序。$W_T\lt W_R$ 时,发送窗口限制在途帧数,更大的接收窗口不会自动被充分利用。采用对称窗口时 $W_T=W_R\le2^{n-1}$,所以此时接收窗口最大值为 $W_R=2^{n-1}$。
- 计算信道利用率时,分子中的“$n$ 个分组”应根据发送窗口 $W_T$ 理解,不要与序号字段的 $n$ 比特混淆。
在共享、半双工以太网的 CSMA/CD 模型中,$\tau$ 是最远站点之间的单程传播与相关设备延迟,$2\tau$ 是最坏情况下的往返碰撞检测延迟预算,不是最小 RTT。要保证发送方在最迟碰撞信息到达时仍在发送,须有 $L_{\min}/R\ge2\tau$。对于 100Mb/s 以太网,512 比特槽时间为 $512/(100\times10^6)=5.12\mu s$。设备延迟消耗这个固定预算,而不是使槽时间缩短。若设备单程延迟总计为 $\Delta t$,理想模型中留给电缆的单程传播时间最多为 $2.56\mu s-\Delta t$,再乘传播速度求距离。
例题:
一个采用 CSMA/CD 的网络中,信号传播速率为 200m/us, A,B 两个站点中间位置新增一个 100BASE-T 的直通式交换机,则理论上 A,B 两个站点之间的最远距离可缩短多少m交换机隔离冲突域,A、B 不再位于一个端到端共享冲突域中,因此不能把交换机转发时延作为中继器时延,从同一个 $2\tau$ 预算推出距离缩短 96m。各链路须分别满足其冲突检测及物理层长度限制。若另行假设新增设备保持共享冲突域,且它的单程延迟恰为简化直通门槛 $6\times8/100=0.48\mu s$,才有纯算术预算 $2.56-0.48=2.08\mu s$,距离 $2.08\times200=416\mathrm m$,相较 $512\mathrm m$ 减少 $96\mathrm m$;这一额外设备模型不是题目给出的交换机模型。
例题:
主机A和B连接在 800m 长的电缆线两端,并在 t=0 时各自向对方发送一个帧, 长 1500bit (包括首部和前同步码).A和B之间有4个转发器, 在转发帧时会产生20bit的时延. 设传输速率为1OOMbit/s, 而 CSMA/CD 的退避时间是 r 倍的争用期, 争用期为 512bit, 在发生第一次碰撞后, 在退避时A选择 r=0, B选择 r=1. 信号的传播速率是 200000km/s, 求 B 完全收到 A 发送的帧的时间电缆传播时间为 $800/(2\times10^8)=4\mu s$,四个转发器的单程总延迟为 $4\times20/(100\times10^6)=0.8\mu s$,故单程总延迟为 $4.8\mu s$,往返为 $9.6\mu s$。$9.6\mu s\gt5.12\mu s$,因此该拓扑不满足标准 100Mb/s 以太网最小帧的碰撞检测约束,不能给出有效标准配置下的收帧时间。 仅按碰撞预算计算,所需最小发送长度已达 960bit;题中 1500bit 帧能在这次同时发送时检测到碰撞,并不能使整个拓扑符合标准。
若额外忽略强化冲突信号、帧间间隔等细节,并约定双方从信道清空时开始计退避时间,则可计算一个假想时序。题中 1500bit 帧的发送时间为 $15\mu s$:
- $t_0=0$:A、B 同时发送。
- $t_1=4.8\mu s$:双方收到对方第一比特,检测到碰撞并立即停止;已发出的信号仍在电缆中。
- $t_2=9.6\mu s$:残留信号清空。按此假设从这里计退避,A 选 $r=0$,立即重传;B 的退避到 $9.6+5.12=14.72\mu s$ 结束。
- $t_3=14.4\mu s$:A 的第一比特到达 B。由于 $5.12\mu s\gt4.8\mu s$,B 尚处于上述退避期间。B 没有发送,此时是检测到信道忙,并非检测到碰撞。
- $t_4=14.4+15=29.4\mu s$:B 收到 A 的最后一比特。
- 在这个忽略帧间间隔的假想模型中,B 的退避已经结束,可在信道重新空闲后发送。
因而 $29.4\mu s$ 只属于这一明确补充的时序模型;退避起算规则或标准细节改变时不能直接沿用它。
TCP 相关:
- TCP 数据序号按字节编号。若教材取 MSS=1KB=1024B,则发送 2MSS 的新数据使序号增加 2048,而不是增加 2。
- 例题:数据传输速率是 2.5Gb/s, 假设 PDU 的生存时间为 51.2s, 若要尽可能地传送数据, 问 PDU 首部序号字段长度的最小设置为多少位? 按通信速率的十进制单位计算,在该生存时间内最多发送 $2.5\times10^9\times51.2=128\times10^9$ bit,即 $16\times10^9$ B。按字节编号且要求该时间内序号不回绕,有 $2^{33}\lt16\times10^9\lt2^{34}$,所以序号字段至少需要 34 位。
- 慢开始阶段,每个确认新数据的 ACK 通常使拥塞窗口增加约 1MSS;重复 ACK 不能一概这样处理。拥塞避免阶段通常每 RTT 总计增加约 1MSS,而不是每个 ACK 都增加 1MSS。
- 在常见三次握手和正常连接释放流程中,第一个 SYN 的 ACK 标志为 0,其余相应确认段的 ACK 为 1;不能把这个流程口诀推广到所有 TCP 报文,例如复位及其他状态下的报文。
- 教材常讨论四种计时器:超时重传计时器;持续计时器,用于零窗口探测,避免窗口更新丢失造成死锁;保活计时器,启用后探测长期空闲连接的对端是否仍可达;时间等待计时器,对应 TIME_WAIT,通常为 $2\times MSL$。
不要忘记域名服务器 DNS 也有缓存, 可以不用向根域名服务器查询
在 GBN 协议中, 对方的发送的序号是一个一个接收的, 设数据帧形式为 ${R_{x,y}}$ 其中 ${x}$ 代表自己的数据帧序号, ${y}$ 代表确认帧即希望收到的下个序号,若分别收到了 ${R_{2,\,2}}$ 和 ${R_{4,3}}$, 那么此时我们要给对方发送的是 ${R_{3, 3}}$ 即希望收到 3 号数据帧, 而不是 5 号数据帧
ARP 只解析本地链路上的 IPv4 下一跳地址,缓存命中时无需重新查询。
- H1 向同一子网的 H2 发送时,查询 H2,链路目的地址为 $MAC_{H2}$;向其他子网的 H3 发送时,按路由选择本地网关 R1,查询的是 R1,链路目的地址为 $MAC_{R1}$。只有命中 NAT 映射和策略时,出口才需要转换源 IP。
- R1 若直接连接 H3 所在子网,就独立查询 H3 并封装目的 MAC 为 $MAC_{H3}$ 的帧;否则查路由表,独立查询下一跳 R2,目的 MAC 为 $MAC_{R2}$。
- H1 的 ARP 广播不会被路由器逐跳转发到 H3。每个链路上的查询和回复都是独立交换:H2 回复 H1,R1 可回复 H1 对网关的查询,H3 仅回复其本地链路上查询它的路由器。H3 的 ARP 回复不会沿路经 R1 转交给 H1。
- 因此,跨子网传输是在各跳根据需要分别 ARP 并重新封装链路帧;不是一次贯穿全程的 ARP 过程。
子网地址通常由网络前缀加全零主机位表示,识别时必须结合完整掩码。
- 例:给出子网地址 130.130.19.0、130.130.20.0、130.130.11.0、130.130.12.0,掩码 255.255.255.0(/24)是一种可行选择;/25 等更长前缀也可使这些地址成为网络地址。仅凭这四个地址不能唯一确定掩码,还要结合主机数量、是否统一掩码以及是否允许变长子网划分等条件。
- 路由器转发表的目的字段是网络前缀,可以是普通子网路由、/32 主机路由,也可以是 /0 默认路由;转发时使用最长前缀匹配。
虚电路是逻辑连接:建立阶段可使用目的地址选择路径,并在各段分配虚电路标识 VCID;后续数据按已建立路径用相应 VCID 转发,通常不必在每个数据分组中携带完整目的地址,首部开销较小。虚电路标识可具有局部意义,转发时仍需查相应映射。固定路径有利于按序传送,但是否预留带宽、提供确认重传或保证可靠交付,取决于具体技术和服务,不能从“虚电路”这个名称直接推出。
主机 H 从初始状态访问 Web 服务器(示例字符串为
www.bilibili/o-Sakurajimamai-o/home.com)时,需要按地址配置、名称解析、连接和传输的顺序分析,并区分题目模型与实际协议条件。- DHCP 配置。 若 H 尚无 IPv4 地址,典型初次获取过程为 Discover、Offer、Request、ACK。Discover 通常使用源 IP 0.0.0.0、目的 IP 255.255.255.255 和链路广播;初次选择服务器的 Request 通常也广播。Offer/ACK 则可按客户端状态、广播标志及链路可达性采用广播或单播,不能固定成“MAC 单播、IP 总为广播”。DHCP 是客户/服务器应用层协议,使用 UDP。Offer 可提供 主机申请、DHCP、默认网关、DNS 等的 IP 以及子网掩码;具体应区分分配给客户端的 yiaddr、DHCP 服务器标识,以及子网掩码、默认网关、DNS 服务器等配置选项。
- 取得解析器的下一跳 MAC。 DNS 解析的是 URL 的主机部分。这个示例含斜杠,不能把完整字符串当成 DNS 主机名;若按斜杠前为主机的方式理解,主机部分是 www.bilibili,其后是路径,路径末尾的 home.com 并不能说明查询要经过 .com 域。必须先明确题目要访问的有效主机名。DNS 服务器若与 H 同子网且 ARP 缓存未命中,H 才直接 ARP 它;若不在同子网,则 ARP 相应下一跳。交换机在转发时可学习源 MAC,但 ARP 往返不计作 DNS 查询次数。
- DNS 查询。 H 可向本地递归解析器发起一次简化的地址查询;缓存命中时解析器直接回答。否则解析器通常进行迭代查询:根服务器返回转介,解析器继续询问顶级域及权威服务器。对一个 .com 名称,根、.com、权威服务器各一次的“三次查询”只适用于无缓存且委派层级等均按题设简化的模型,不能套到任意名称。真实根服务器不替普通客户端完成递归解析;课本的纯递归示意须与此区分。实际次数还受别名、委派和缓存影响。DNS 可使用 UDP 或 TCP,IP 承载其分组;以太网承载链路帧,现代全双工交换链路不使用 CSMA/CD 争用。
- 请求 Web 资源。 得到服务器 IP 后,根据路由确定下一跳。若 Web 不在本子网,下一跳通常为 R1;在本子网则直接为 Web。只有相应 ARP 缓存未命中时才重新查询 MAC。路由器按正常路由转发,并在 NAT 映射和策略要求时转换地址。对这里的 HTTP/1.x 模型,先建立 TCP 连接,第三次握手可携带请求,服务器随后响应。忽略 DNS、TLS、发送与处理时延等,且小页面(例如不超过 1MSS)能够直接发送时,接收响应约需 2RTT;实际还受拥塞窗口、接收窗口和资源大小限制。HTTP 通常称为无状态协议,这不表示传输层无连接:HTTP/1.x 通常使用 TCP,HTTP/3 使用 QUIC。
- 帧数须按条件统计。 如果 DNS 服务器与 H 位于同一广播域、相关 ARP 缓存为空,且只统计这几个步骤,它的网卡可能收到:查询 DNS 服务器 MAC 的 ARP 广播帧、查询 Web 服务器 IP 的 DNS 单播请求帧、查询默认网关(或同子网 Web 主机)MAC 的 ARP 广播帧。DNS 查询的内容是名称对应的 IP 或其他记录,并非 Web 的 MAC。这个“三帧”清单不能当作整个初始访问的固定总数;DHCP、已有缓存及其他广播等都会影响统计。
- H 与 Web 继续传输资源,受到流量控制、拥塞控制和 HTTP/1.0、HTTP/1.1、持续/非持续、流水/非流水等模型条件影响。
- 传输结束后,按所用连接策略关闭或继续复用连接;若关闭 TCP,则进入 TCP 连接释放过程。
UDP 校验和使用 16 位反码加法,与 IPv4 首部校验和的计算方法类似,但 UDP 的覆盖范围是伪首部、UDP 首部和数据。发送方先把校验和字段清零;若数据字节数为奇数,则仅在计算时补一个零字节,伪首部和补字节不作为额外 UDP 数据发送。将各 16 位字相加、回卷进位,再取反填入校验和。接收方对同样的内容连同收到的校验和求和,结果全 1 表示未检测到差错,不能保证绝对无差错。IPv4 UDP 的校验和字段为零还可表示未启用该校验和。
若题目给出具体的 IP 数据报, 关于 TCP 数据部分可以通过 “观察 TCP 首部长度, 剩下的就是数据部分” 确认, 然后进行具体的序号或者 ACK 预测或窗口计算等等
IPv4 有限广播地址为 255.255.255.255,用于本地链路广播,路由器不转发。定向广播地址由目标子网前缀加全 1 主机位构成,例如普通 /24 子网的 xxx.xxx.xxx.255。它在地址语义上可指向远端子网,但现代路由器默认禁用定向广播转发,只有显式允许时才转发。相关安全风险主要包括广播放大等滥用,不能简单理解为一定会被外部截获。
在 CSMA/CD 中, 发送端检测到冲突并停止之前, 可能已经发送出去的比特数称为最大碎片帧长度, 其值正好等于 在 2τ 时间内最多能发出的数据量, 也就是说以太网中的最短帧长必须不能小于这个长度; 关于为什么需要最小帧长: 发送速率为 R,那么在 $2\tau$ 时间内最多能发出的比特数为 ${R\cdot 2\tau}$。为保证发送方在发生冲突时仍在发送(能检测到冲突), 如果帧太短,发送方可能在冲突返回之前就发送完并认为发送成功,导致未检测到冲突而产生错误数据;
中继器在传递时会将信号整形放大以防止信号变弱, 因此在一定距离的传输中需要用到中继器, 中继器放大的是数字信号, 放大器放大的是模拟信号, 放大器用于远距离模拟信号的传输
实现两个节点之间的流量控制的是数据链路层, 实现两个主机之间的逻辑通信的是网络层, 实现两个进程之间的逻辑通信是传输层
IPv4 分片中,除最后一片外,各片的数据部分长度须为 8B 的整数倍;片偏移以 8B 为单位,整个 IP 数据报长度不要求为 8B 的倍数。最后一片的数据长度可以不对齐。若源主机待发送的 IP 数据报超过出接口 MTU,且允许分片,源主机也须遵守同样规则,不能把超 MTU 报文直接送上链路。
- 例:H1 向 H2 发送,途经 R1、R2;H1→R1 的 MTU 为 1500B,R1→R2 为 400B。H1 的原始数据报若超过 1500B,需要先按本地 MTU 处理,例如在 DF=0、20B 首部的分片模型中,非末片可取 1480B 数据加 20B 首部。R1 收到一个总长 1500B、首部 20B 且允许继续分片的报文时,再按 400B MTU 分片;各非末片最多装入 $8\lfloor(400-20)/8\rfloor=376$ B 数据。例如 1480B 数据可分为 376、376、376、352B,各片首部另计,片偏移还要加上原片偏移。
- 若 R1→R2 的 MTU 仍为 1500B,已经不超过该 MTU 的报文无须再次分片;这不免除源主机对更大原始报文的处理。DF=1 而报文过大时不能强行分片,应按相应错误处理机制处理。
一个 IPv4 多播地址映射为一个以太网多播 MAC 地址,格式为 01-00-5E-xx-xx-xx;后 24 位由 1 个零位和 IP 地址的低 23 位构成。不同多播 IP 可以映射到同一 MAC。例:H1、H2、H3 加入 224.0.64.32,H4 加入 224.128.64.32,两组均映射到 01-00-5E-00-40-20。在相关帧被转发到同一链路、网卡按该 MAC 接收的条件下,H4 可能收到给前一组的帧,再由 IP 层发现它未加入目的组而丢弃。这不表示向多个单播 MAC 分别发送,也不表示不同网络中的所有主机都会收到。
NAT 转发表中端口号均为主机的内网端口号和外网端口号, 比如主机 H1 以内网ip 197.128.0.23, 内网 port: 1234, 外网ip 110.1.2.3, 外网 port: 4321 的数据报发送给 Web 建立控制连接, Web 的 ip 为 110.0.0.0. 那么 NAT 转发表中内网的 ip 为 197.128.0.23, port 为 1234, 外网 ip 为 110.1.2.3, port 为 4321;
FTP 控制连接通常由客户端连接服务器 TCP 端口 21。主动模式的数据连接通常由服务器从源端口 20 连接客户端指定的数据端口;被动模式由客户端连接服务器协商的数据端口,并非统一访问目的端口 20。一次数据传输通常使用一条数据连接,传输结束后关闭,下一次传输再建立数据连接;同一会话可复用控制连接,但并行、多线程传输如何组织会话取决于客户端实现,不能保证所有传输只需一条控制连接。
DHCP 基于 C/S 模式, 所以它是应用层协议, 利用 UDP 传输;
IPv4 特殊地址须结合掩码和使用场景判断:0.0.0.0 可在主机尚未获地址等情况下用作源地址,例如初始 DHCP 报文,不能用作普通数据报的目的地址。通常子网的全零主机位表示网络本身,全 1 主机位表示定向广播,不能仅凭末字节为 0 或 255 判断;/31 点到点链路等特殊用法另有规则。224.0.0.0/4 是多播地址范围,用作目的地址,不作普通源地址。有限广播 255.255.255.255 和有效定向广播地址也不能用作源地址。
在主机与主机之间通信的时候, 主机 H1 向主机 H2 通信, 考虑以下几点
- 首先要检查目的 IP 是否与自己属于同一个局域网, 通过子网掩码进行
and操作, 若与自己属于一个局域网可以直接发送, 因此, 两者通信不经过默认网关; 若两者不属于同一局域网, 假设 H1 的默认网关设置错误, 即 H1 与路由器不在同一个局域网(此时要求两者子网相同, 这也是为什么路由器有多个 IP 地址的原因), 则 H1 无法达送路由器, 故无法正常通信; - 若主机的子网掩码配置错误, 那么很有可能导致不在同一局域网的主机经过子网掩码的错误配置后, 主机 H1 误以为 H2 在局域网, 从而无法正常通信;
- 首先要检查目的 IP 是否与自己属于同一个局域网, 通过子网掩码进行
三段私有 IPv4 地址为 10.0.0.0/8(至 10.255.255.255)、172.16.0.0/12(至 172.31.255.255)、192.168.0.0/16(至 192.168.255.255),可在不同内部网络中重用,也可在内部正常路由,并非每次通信都必须 NAT。需要出口地址转换时,基本 NAT 转换网络层 IP 地址;带端口复用的 NAPT/PAT 还检查并转换 TCP/UDP 等传输层端口。因此不能笼统地说 NAT 只工作在传输层。
CSMA/CA 无线局域网:
无线站监听到忙,表示信道被占用,并不表示它检测到了碰撞;发送后未收到 ACK 等现象才可用于判断一次交换失败。在基本 DCF 的教材模型中,若信道已空闲 DIFS、NAV 允许且无待完成的退避,可发送数据。发现忙、重传以及成功发送后继续竞争下一帧时,须按对应规则退避。
退避从 $[0,CW]$ 中随机选择整数时隙数。$CW_{\min},CW_{\max}$ 由 PHY 和配置决定;例如取 $CW_{\min}=15,CW_{\max}=1023$ 且从 $k=0$ 计第 $k$ 次扩大时,可写 $CW_k=\min(2^{4+k}-1,1023)$,这不是所有无线网络统一的窗口参数。
只有在物理信道空闲、NAV 条件满足,并经过所需 DIFS 后才递减退避计数。期间变忙时冻结剩余计数,待重新满足空闲条件和 DIFS 后继续,不能把已经完成的退避全部清零。
因而,成功发送后还要连续发送下一帧,通常须等待 DIFS 并执行随机退避,再参与竞争。各帧的 Duration/ID 信息可让其他站维护 NAV;例如数据帧可指明 SIFS 与 ACK 所需的剩余交换时间。RTS/CTS 也使用这类预约信息,但 NAV 不只用于 RTS/CTS 预约。
例题:
DIFS 为 128 us, SIFS 为 28 us, ACK 帧长 2B, A、B、C 三个站点均要发送 100B 的数据帧, 信道数据传输速率 8Mb/s, t = 0s 时 A 计划发送, t = 50us 时, B、C 同时计划发送, 退避时隙为 20us, B、C采用的退避时隙数分别为 3, 5, 求 A, B, C 各自完成数据发送的时间标准 DCF 的关系 $DIFS=SIFS+2T_{\mathrm{slot}}$ 在本题 SIFS 和时隙数值下给出 $68\mu s$,与题给 DIFS=128μs 不同。因此以下保留全部题设数值,按自定义时序模型演算,不能当成标准 DCF 参数配置。忽略传播和 PHY 开销,数据帧发送时间为 $100\times8/(8\times10^6)=100\mu s$,ACK 发送时间为 $2\mu s$。A 在 $t=0$ 开始等待 DIFS,$128\mu s$ 开始发送,$228\mu s$ 发送完数据;再经 SIFS 和 ACK,在 $258\mu s$ 完成确认。B、C 随后等待 DIFS 至 $386\mu s$ 开始退避。
- B 用完 3 个时隙,共 $60\mu s$,于 $446\mu s$ 开始发送,$546\mu s$ 发送完数据,$576\mu s$ 完成确认。
- C 已完成 3 个退避时隙,冻结剩余 2 个;在 B 交换结束后再等 DIFS 至 $704\mu s$,用完 $40\mu s$ 剩余退避,于 $744\mu s$ 开始发送,$844\mu s$ 发送完数据,$874\mu s$ 完成确认。
题目若问数据帧发送完毕,答案为 A:228μs、B:546μs、C:844μs;若问含 ACK 的交换完成,则分别为 258μs、576μs、874μs。
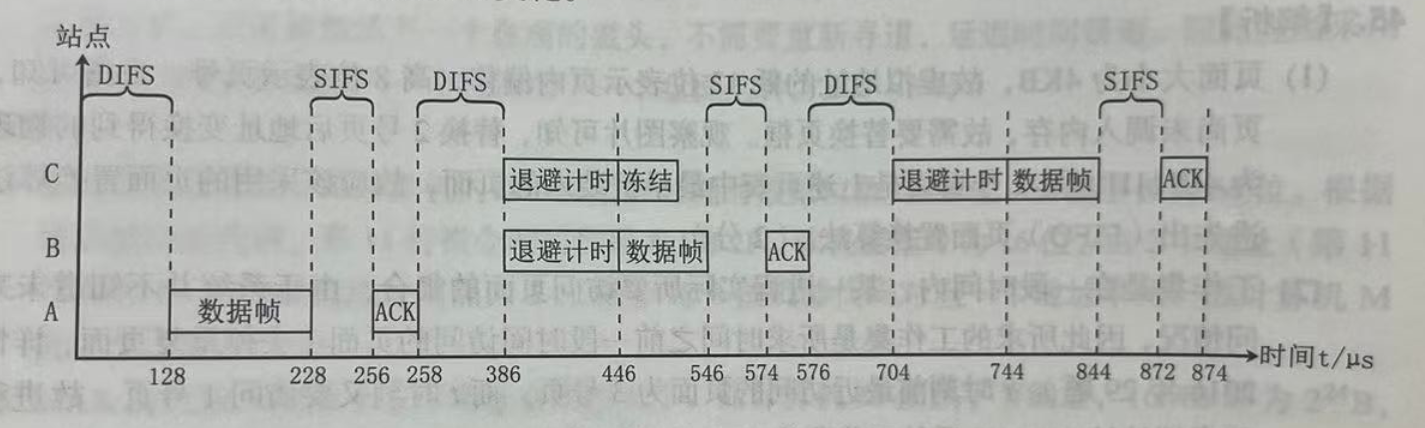
原笔记配图 19
经典快速重传由发送方在收到三个重复 ACK 后触发。接收方收到失序段时通常立即发送重复 ACK,正常按序接收则可采用延迟 ACK。例:用分组编号 0~10 作简化示意,若第 5 个分组丢失,接收方收到 6、7、8 后,分别发送仍期望第 5 个分组的重复确认;发送方收到第三个重复确认便重传 5。这里 $ACK_{\mathrm{seq}}=5$ 只是分组编号示意,实际 TCP ACK 表示所期待的下一个字节序号。若丢失的是 8,仅收到 9、10 只能产生两个重复 ACK,单凭它们不足以触发经典“三重复 ACK”快速重传,还要等待更多确认或其他恢复机制。
移动 IP 通信过程:
- 多个移动节点可共享同一个外地代理提供的转交地址(care-of address),这不表示不同外地代理的 IP 地址可以任意重复。外地代理根据登记及访问者绑定关系解封装、识别移动节点并交付,最后一跳可再使用相应 MAC 地址。
- 例:H2 的永久 IP 为 20.1.2.2;移动站 H1 的归属代理 IP 为 100.0.2.0,永久 IP 为 100.0.2.100,转交地址为 15.0.8.8。
- H2 发给 H1 的数据报源 IP 为 20.1.2.2,目的 IP 为 100.0.2.100。归属代理截获后进行隧道封装。
- 隧道外层首部为源 IP 100.0.2.0、目的 IP 15.0.8.8;内层保留源 IP 20.1.2.2、目的 IP 100.0.2.100。转交地址只在这里的外层目的字段中。外地代理去除外层封装,再按绑定关系和本地链路封装向 H1 交付。
- H1 收到的内层数据报仍为源 IP 20.1.2.2、目的 IP 100.0.2.100。
- 经典三角路由中,H1 可用永久源 IP 100.0.2.100、目的 IP 20.1.2.2,经外地网络正常路由直接发给 H2;仍须完成路由和链路转发处理。部署也可使用反向隧道,经归属代理后再发给 H2。
IPv4 特殊地址与路由前缀应分开记忆。下表的网络地址、广播地址判断均以相应掩码和普通子网用法为前提;/31 等特殊用法另行判断。
| 地址或位模式 | 用作源 IP | 用作目的 IP | 用途 |
|---|---|---|---|
| 0.0.0.0(网络号与主机号全 0) | 仅限尚未获地址等特定情形 | 不作普通目的地址 | 未指定地址,可表示本机尚未配置地址 |
| 0.0.0.0/0 | 不是报文源地址写法 | 不是报文目的地址写法 | 路由表中的默认前缀,匹配任何 IPv4 目的地址 |
| 255.255.255.255(全 1) | 不可以 | 可以 | 本地链路有限广播 |
| 网络号全 0、主机号为特定值 | 不作现代普通主机源地址 | 不作现代普通主机目的地址 | “本网络某主机”属于历史地址语境,不能据此任意使用 0.x.x.x |
| 普通网络号、主机号全 0 | 通常不可以 | 通常不作为主机目的地址 | 标识子网前缀 |
| 普通网络号、主机号全 1 | 不可以 | 可作为定向广播 | 目标子网的广播地址,路由器默认不转发 |
| D 类范围 224.0.0.0/4 | 不可以 | 可以 | 多播组地址,部分地址具有保留或专用用途 |
| 127.0.0.0/8 | 可在本机回环使用 | 可在本机回环使用 | 回环,不在外部网络路由 |
| E 类范围 240.0.0.0/4 | 通常不作普通主机源地址 | 通常不作普通主机目的地址 | 保留地址范围;全 1 广播地址按上列规则处理 |
VLAN:
- VLAN 是逻辑广播域,不是交换机本身。交换机端口隔离冲突域;“$n$ 台主机有 $n$ 个冲突域”只适用于各主机分别接独立端口等相应半双工拓扑。现代全双工链路不发生 CSMA/CD 碰撞。
- 802.1Q 标签增加 4B,常见最大帧长由 1518B 增至 1522B,数据上限仍为 1500B。若按 64B 最小总帧长计算,数据加填充部分的下限可由 46B 变为 42B;对已有的最小未标记帧直接插入标签,也可能得到 68B 帧。去标签后的出口帧仍须满足该链路的最小帧长。
- Access/Trunk 的常见规则还受允许 VLAN 列表、原生 VLAN 是否标记以及厂商配置影响。PVID 主要对入站无标签帧进行 VLAN 分类,不应把它无条件等同于所有出站标记规则。
- 打标签: 在常见默认配置中,允许通过 Trunk 的非原生 VLAN 帧出站时携带 802.1Q 标签。
- 去标签: Access 端口只转发该端口允许 VLAN 的帧,并通常以无标签帧交付主机,不能把任意 VLAN 的帧去标签后都转给它。
- 对 Trunk 的原生 VLAN,常见默认配置为无标签发送,但原生 VLAN 也可配置为带标签发送,不能把“必须去标签”当成普遍标准。
- 例:主机接口为 Access,PVID=10;交换机间接口为 Trunk。本例假定 Trunk 允许 VLAN 10 和 VLAN 1,入站 PVID 与原生 VLAN 均为 1,且原生 VLAN 采用无标签发送。H1(VLAN 10)发送普通无标签 MAC 帧,S1 在 PVID 10 的 Access 口收到后,将其内部归类为 VLAN 10,并查询该 VLAN 的 MAC 地址表。
- 若目的主机在 S1 另一个允许 VLAN 10 的 Access 口,S1 以无标签帧转发。
- 若 VLAN 10 的广播需要扩散到 S2,或目的 MAC 位于 S2,则通过允许该 VLAN 的 Trunk 转发。因为 VID 10 不等于本例原生 VLAN 1,所以出站帧携带 VID=10 的标签。
- 本例的 VLAN 1 帧在 Trunk 上可无标签发送。因此交换机之间不一定只传带标签的 802.1Q 帧。若配置改为标记原生 VLAN,出站行为也随之改变。
- S2 读取 VID=10 后,只向 VLAN 10 允许的出口转发;发给该 VLAN 的 Access 主机时去标签。帧本身属于某个 VID,“PVID”是端口属性。
- 更详细的知识可看湖科大 T35:2022 408考研计算机网络模拟题03答案及解析
FTP 主动模式与被动模式规定的是数据连接由谁发起,默认模式取决于客户端实现和配置。主动模式通常由服务器发起数据连接,被动模式由客户端发起。TCP 的 TIME_WAIT 则取决于连接关闭过程:通常主动发送 FIN、发起关闭的一方等待 $2\times MSL$ 后进入 CLOSED;同时关闭时也可能双方进入 TIME_WAIT。不能从 FTP 主动模式或连接建立方直接断定一定是服务器等待。
一个调制码元可按其状态集合携带若干比特。曼彻斯特编码每比特包含两个半位电平,且位中必须翻转;按教材把半位电平称为一个信号单元(码元)的记法,就是两个信号单元表示一比特。这两个电平受编码约束,不能当作两个独立自由选择的调制码元。
边界路由器(eBGP, iBGP)在交换信息时要先建立 TCP 连接
评论