DoVer: Intervention-Driven Multi-Agent Debugging
DoVer 多智能体故障归因、干预与验证的阅读笔记。
存在的问题
Who&When(WW) 的数据集评测方式其实是有问题的,WW 的具体表现形式为:
- 输入:一份完整的失败会话日志,记录了从用户提问开始,多个智能体按轮次交互,直到最终给出错误答案(或触发最大重规划轮数等停止规则)的全过程。
- 任务要求:让大模型阅读日志,找出导致任务失败的最早的、唯一的一个责任智能体和唯一的一个步骤。
- 决定性错误步的定义:如果把智能体在这一步的错误动作替换成正确动作,后续的轨迹就能顺利走向成功。
但是作者发现,对于 WW 数据集中的轨迹,并没有表明步数,也就是每一步都需要大模型去记忆推断;同时交给 LLM 的判罚尺度与专家标注的尺度不一致,给 LLM 的 Prompt 里面嵌入了给人类专家的一句简介的指南提醒
明确告诉模型:要找的是最早导致任务偏离正轨、且若修正就能成功的决定性步骤。 完成以上两步后,在包含标准答案的 WW 手工构建集上,GPT-4o 的步骤归因准确率就从原来的 6.04%飙升到了23.56%。 继续往下探索,WW 数据集的归因方式或者说归因角度太过于单一,对于多种错误中挑选出一个绝对错误本来就是不确定的,这导致 LLM 可能与人类专家标注的不一致,但其实两者都可被认为是关键错误;多智能体还会存在智能体之间的责任模糊,即子智能体出错,可能是自身问题、也可能是分配任务的智能体描述不当造成,在这种情况下,只把错误归因于一个智能体是片面的。
Dover
针对于以上问题,作者提出了 Dover,核心框架可简要说明为三个部分:
- 撇弃人类专家标注的 GT,因为可能存在多视角错误(类 MP-Bench),Dover 回到了决定性错误的定义身上,直接修改 $t$ 步的决策,由此看后续的任务是否可以完成,如果完成,则证明该步时决定性错误。
- 对于一个长 Session 里面的多个 React 循环,可能多个 trail 都是错误的(因为 LLM 可能先去试错),Dover 针对于每个 trail 都单独划分,然后从每个 trail 里面去找错误点,这样在缩短上下文的同时还可以针对失败任务进行不同路径的修复。
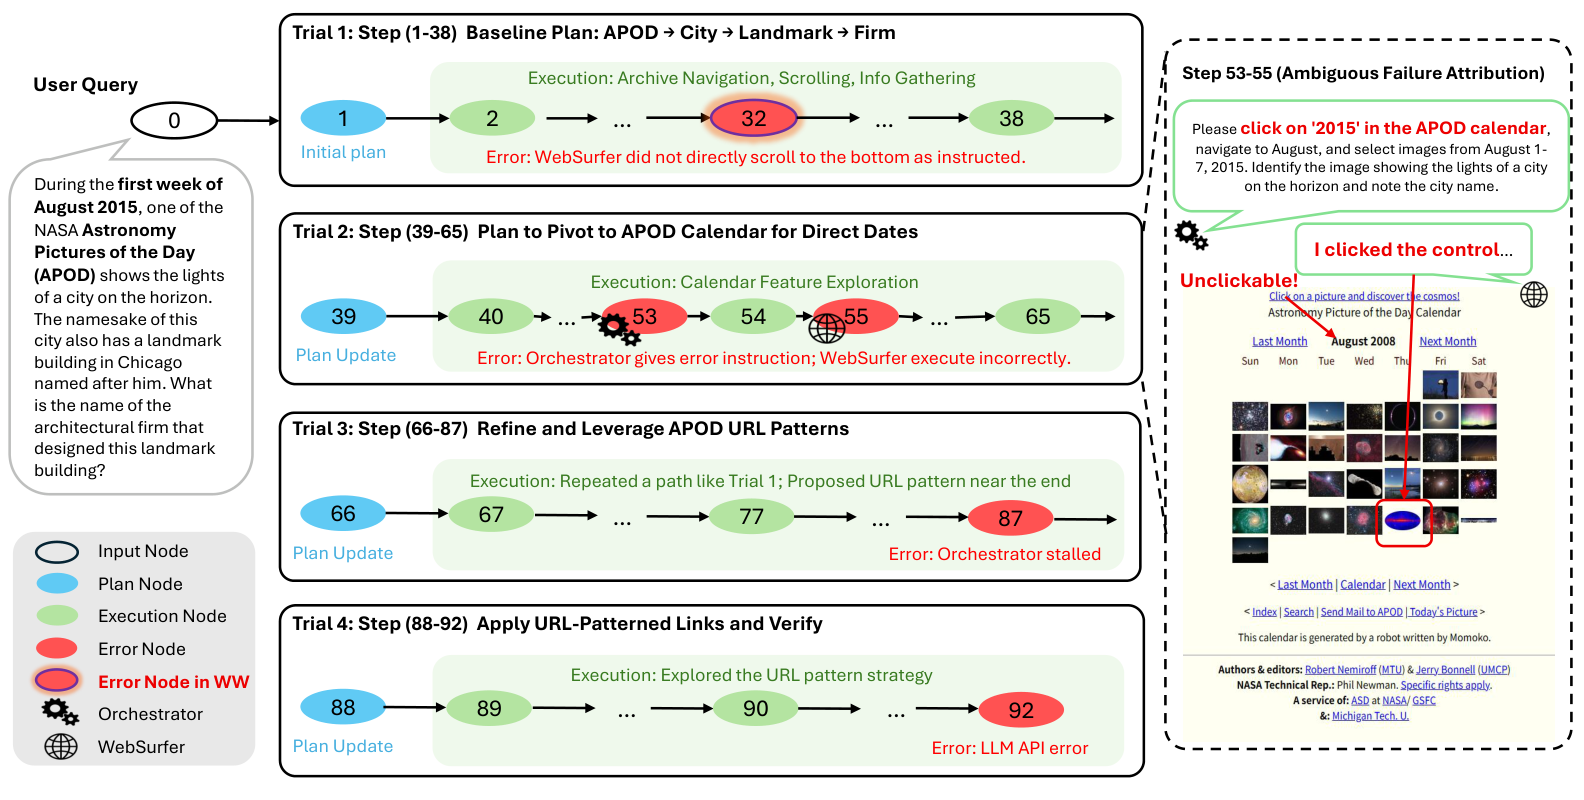
- 主管(Orchestrator)和子智能体(Sub-agents)之间的责任往往纠缠不清,DoVer 在做干预时,明确划分了两个层次的修复手段:
- 直接修改主管的计划或者发给子智能体的 Prompt。
- 子智能体无法完成,可能是因为工具缺失,通过创建新工具来辅助任务完成,这一步是直接修改 Harness 框架了(可以联接到 RSI 这一方面)
Dover 分为四步:
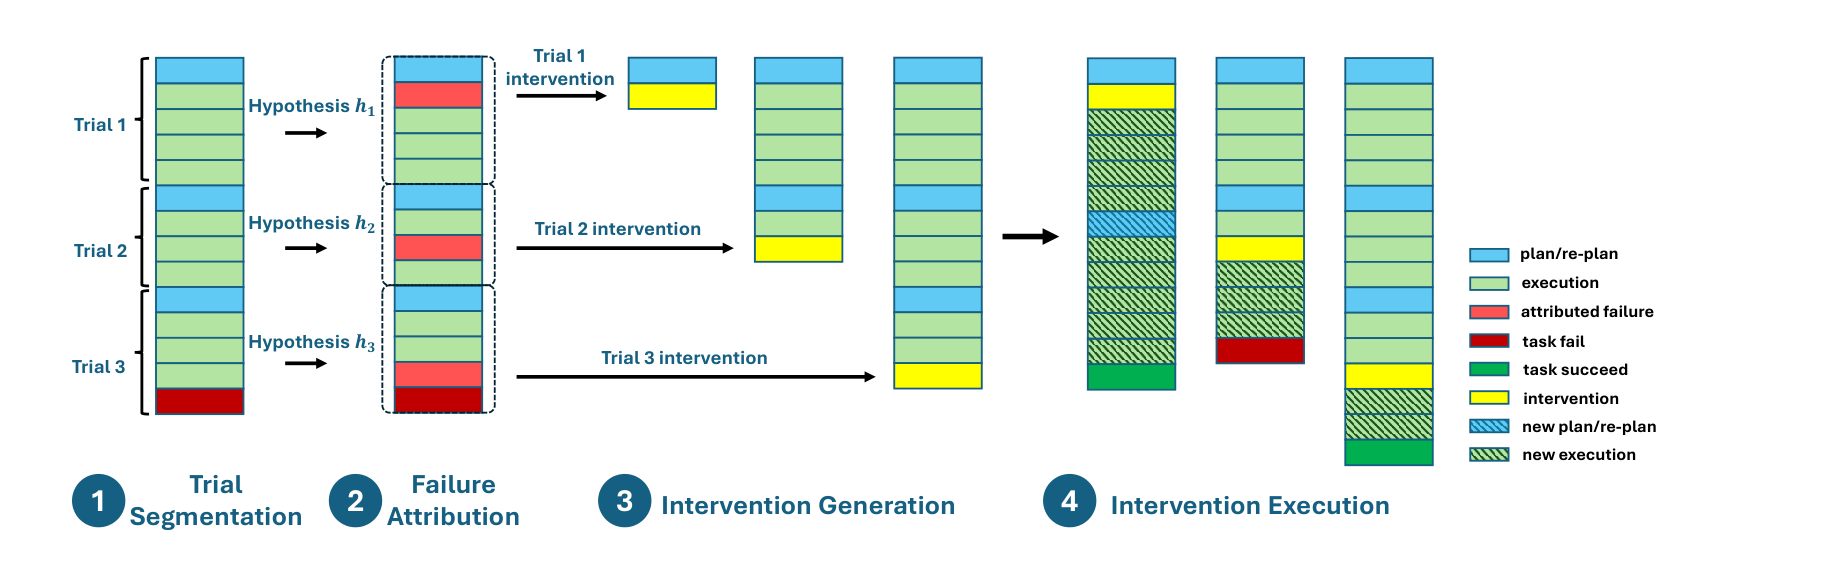
- 试验切分:以智能体系统自我反思后的“重新规划步”为切分点(图 2 中的蓝色方块),把一条冗长的完整失败轨迹 $\tau$ 切分成若干个独立的 Trials。这样做可以缩短上下文、支持并行干预、多路径修复。
- 故障归因:针对一个试验轮次 $\tau^i$,使用 LLM + Prompt 生成候选故障归因假设 $h_i$,且 $h_i = (\hat{a}_{\hat{t}}^i, r_{\hat{t}}^i)$,其中 $\hat{a}^i$ 是嫌疑智能体,$r_{\hat{t}}^i$ 是自然语言写成的错误分析。
- 干预生成:将 $h_i$ 转化为 $\hat{t}$ 步上下文的具体、最小化的文本编辑操作 $I_i$,其中操作分为上面提到的两类。
- 干预执行:将系统状态回滚恢复到第 $\hat{t}$ 步之前的快照 $\sigma_{\hat{t}}$,用干预生成的新消息 $I_i$ 替换掉原本的错误消息 $m_{\hat{t}}$,然后继续执行。
指标
- 施加干预并重跑后,最终成功解决任务的试验运行占比,但对于没有成功解决的,也需要衡量决策是否让任务执行更正确了。论文通过:对于带有人工标注解题步骤的数据集(如 GAIA),先用 LLM 从人类标准解题过程中提取出最多 $K \le 5$ 个与具体工具无关的关键里程碑 $\{\mathbf{m}^1, \mathbf{m}^2, \dots, \mathbf{m}^K\}$,对于任意一条执行轨迹 $\gamma$,用 LLM 裁判比对它完成了几个里程碑:
- 论文为了保持 LLM 是否真的按照 $I_i$ 走下去,还设置了 LLM-as-Judge 来判断是否一直符合修正后的要求,并划分了四个验证状态。
表 1. 干预后故障假设的验证结果类别。
| 验证结果类别 | 判定条件(基于 3 次独立重跑) |
|---|---|
| 1. 验证通过 | 3 次重跑中,至少有 2 次完全成功解决任务。 |
| 2. 部分验证 | 成功次数 $\lt 2$ 次,但至少有 2 次同时满足: ① 忠实执行了干预 ② 里程碑进展度 $\ge +20\%$ |
| 3. 驳回 / 证伪 | 成功次数 $\lt 2$ 次,且至少有 2 次同时满足: ① 忠实执行了干预 ② 里程碑进展度 $\le +20\%$ |
| 4. 未决 | 不满足以上三种的所有其他情况 |
实验
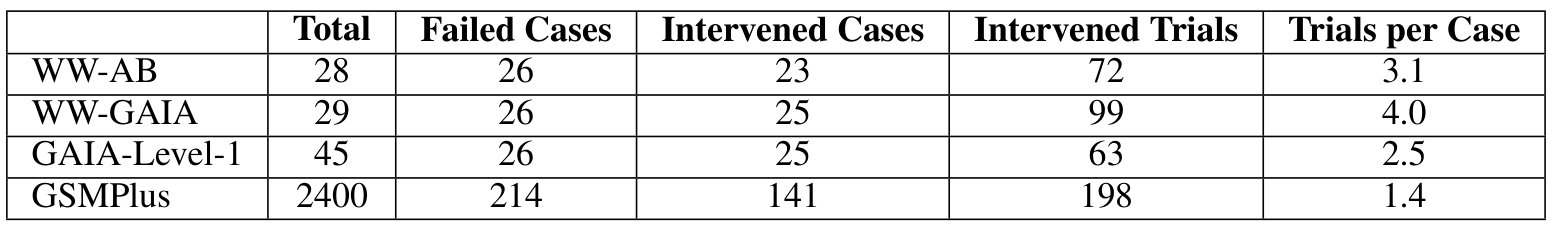
论文中数据集的分布
故障翻转为成功的表现:
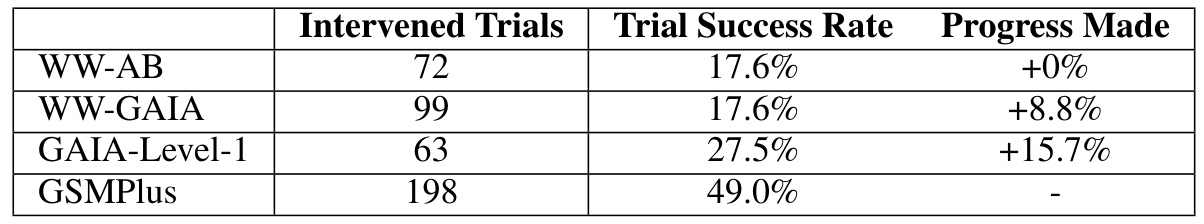
值得注意是:在包含大量高难度任务的 WW-AB 上,进展度为 +0%,说明在极端困难的任务上,不当的干预有时甚至会干扰原有进度(负进展抵消了正进展)。 故障假设的验证分布:
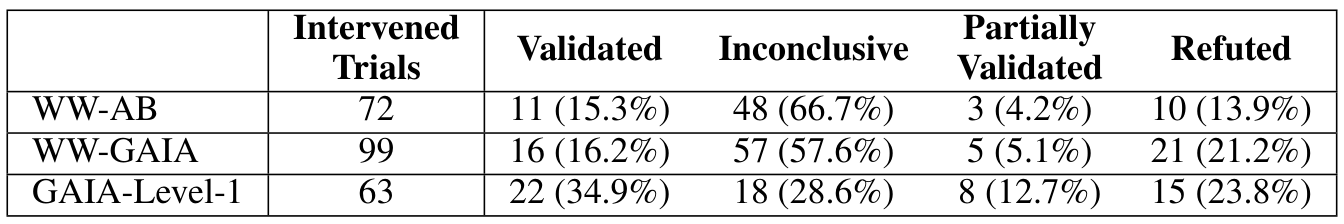
可以看到,在困难数据集上,单凭框架无法进行有效提升。
自我改进
这是作者期待的两个未来方向。在论文中,作者通过人机协同,优化并添加了一些工具,使得智能体在高难任务的表现得到有效提升,但我认为应期待:(i) 完全自动化的调试闭环(即 RSI),其中 DoVer 的洞察反馈给自动化的子智能体改进(例如利用代码智能体来实现修复);(ii) 具备能力感知的干预生成,当不允许修改代码时,允许 DoVer 根据已知的子智能体能力边界量身定制干预措施。这两个方向均有助于实现构建鲁棒、自我完善的多智能体系统的目标。
总结
Dover 这篇工作给出了范式提升,不再是一味的检测判断,而是通过怀疑-重放-验证的步骤来锁定关键错误步,与此同时,Dover 也指出了 ReAct 框架下,针对单一动作的错误归因本身就是片面的;更重要的是,Dover 给出了后续工作的一些启发,就像我在自我改进篇章里面说的那些内容。
但 Dover 依然有许多不足。首先就是 Dover 里面的验证、归因方法实际上在真实场景下无法发挥,原因是 Dover 给调试模型的 Prompt 中是含有真实答案的,即 Judge LLM 实际上是带着答案找错误的,后续 Dover 计算里程碑进度的时候也是通过人类手写的标准步骤来进行计算的,然而在真实场景下并没有类似的标准答案,因此缺乏真实可用性。
- 引入 PRM 代替 Judge LLM with GT,训练专门进行中间打分的 PRM,通过检测轨迹中的逻辑自相矛盾、死循环或空结果幻觉来触发无监督归因。
- 可以考虑动态需求图来代替人类的标准步骤,在任务开始时,先用一个规划分解模型将用户的原始 Query 自动拆解为一个带验证条件的子目标有向无环图(Sub-goal DAG)(如:先验证数据源存在性 $\rightarrow$ 再验证字段完整性 $\rightarrow$ 最后计算结果)。重跑时直接用子目标的完成度来计算 Progress Made,彻底摆脱对人工标注步骤的依赖。
同时,Dover 的 Token 开销太大,对于一条失败的轨迹,Dover 需要开辟 4 条以上的路径进行重放,更多地,对于一个 Trial 来说,Dover 的单次干预无法处理长链条中多次纠偏的复合故障,改正第 $t$ 步的错误,后续的动作依然可能是一个新的错误;
考虑 Dream-RSI 类似沙盒模拟环境重放
另外,Dover 针对一个错误的决策、错误的动作并没有达到真正的下次会做,即下次碰到了,没有任何框架、可供参考的动作去帮助 LLM 纠正,下次做依然可能会错;
关于最后一个问题,这个是 RSI 闭环的一部分,也许需要一个长持续的记忆模块,让 LLM 在 ReAct 的时候去检索自己以往的错误或一直维护的知识库。以此来达到纠正错误的目的。或者进行 Step-level DPO / RL 来对模型进行微调,这样也可以对照上述说的 PRM 同时也可以考虑 Dover + Coding Agent 双协同进化,Coding Agent 来辅助决策动作 Agent,给予工具进化。
Dover 在 WW-AB、WW-GAIA 数据集有高达 57.6%–66.7% 的试验最终落入了 Inconclusive,考虑到模型迭代,也许需要用现代的模型去进行一次真实的测评,看看现在的模型在 Dover 表现如何。
评论