Blade
BLADE 通过 Jev 来进行模型的归因,它将整个流程分为三步,值得注意的是三个阶段的归因都是由 Jev 来进行决策的,下图为 BLADE 的框架。
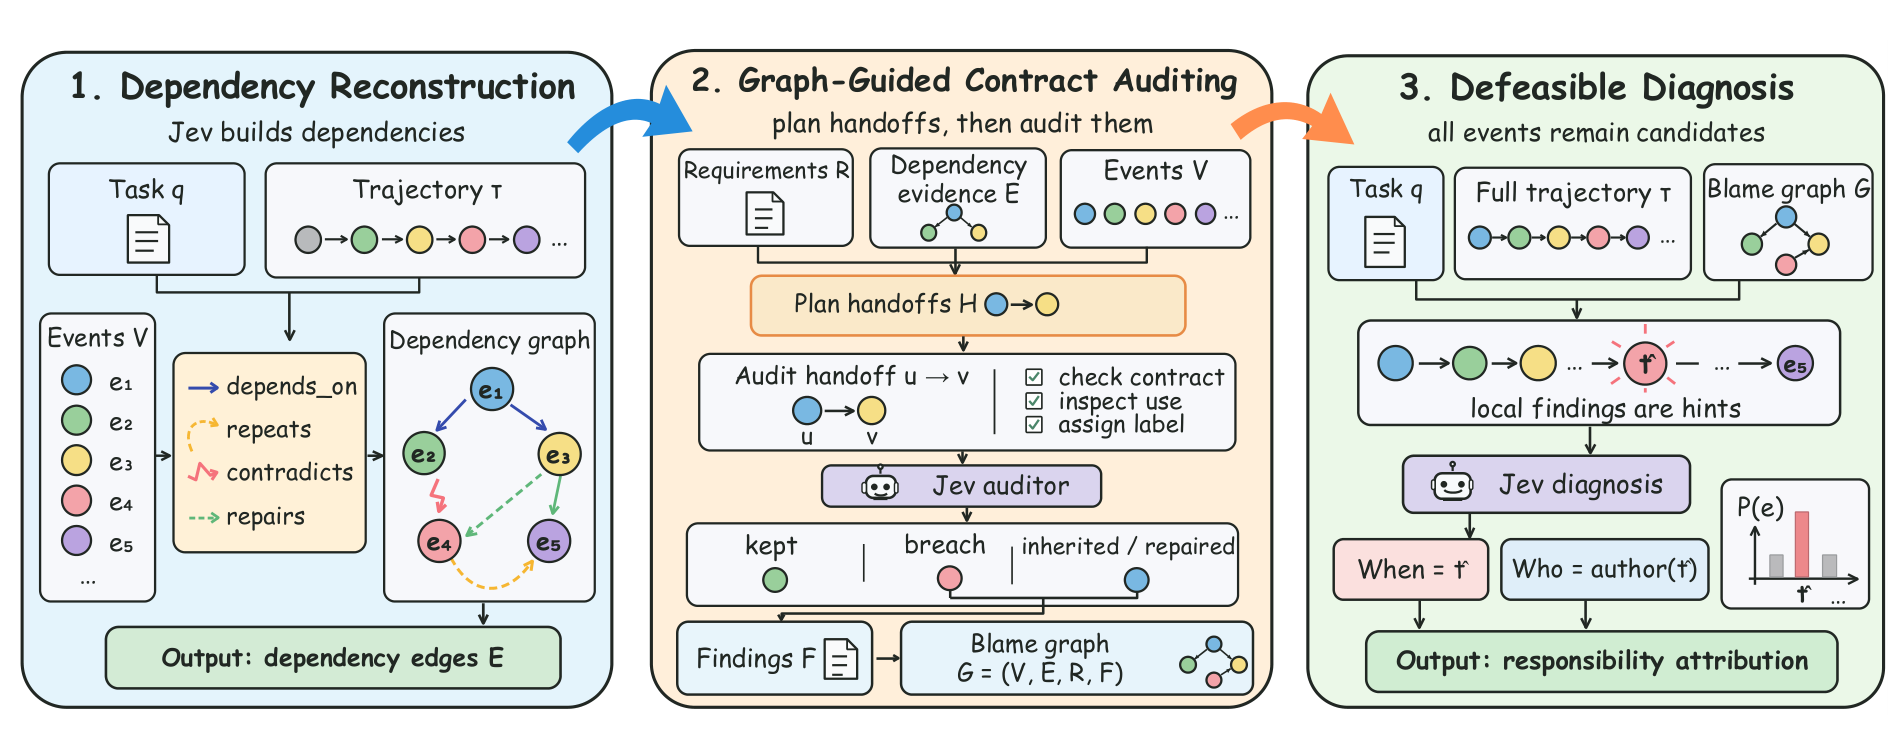 图 1:BLADE 概览。(1) Jev 重构事件间依赖。(2) 依赖关系选出待审计交接处,Jev 对照任务需求片段 $R$ 检查每个智能体决策如何使用信息源。(3) 诊断结合责任图 $G=(V,E,R,F)$ 读取完整轨迹;每个事件均保留为候选。
方法
BLADE 首先将事件定义为 $e_i$,定义四种事件依赖关系:依赖(depends on)、重复(repeats)、矛盾(contradicts)与修复(repairs)。事件与事件的关系交给 Jev 来做选择(还多了个 None 选项),令 $\mathcal{R}_{\mathrm{link}}$ 表示四种关系类型,令 $x_{t,r}$ 表示事件 $e_{t}$ 处针对关系 $r$ 的提问。分配给较早事件 $e_{u}$ 的概率为
$$
p_{ut}^{(r)}=P_{\mathrm{Jev}}(e_{u}\mid s_{\tau},x_{t,r}).
$$
Blade 保留概率至少为 $\theta=0.3$ 的关系,形成加权边集
$$
E=\bigl\{ (e_{u},e_{t},r,p_{ut}^{(r)}):u \lt t, r\in\mathcal{R}_{\mathrm{link}},\ p_{ut}^{(r)}\geq\theta\bigr\}.
$$
由于不是每种依赖关系都是有用的,若将合格的依赖关系都拿来建边,则需要 $O(N^2)$ 的复杂度,Blade 采用 depend-on 分布优先选择来建边。对每个事件 $e_{t}$,令 $\mathcal{U}_{t}=\{u \lt t:p_{ut}^{(\mathrm{dep})}\geq\theta\}$,其中 $\mathrm{dep}$ 表示 depends-on 关系;令 $\mathcal{S}_{t}\subseteq\mathcal{U}_{t}$ 为其中 $p_{ut}^{(\mathrm{dep})}$ 最高的至多 $K=2$ 个信息源索引。选定的交接处为
$$
\mathcal{H}_{t}=\bigl\{(e_{u},e_{t}):u\in\mathcal{S}_{t}\bigr\},
$$
且 $\mathcal{H}=\bigcup_{t=2}^{T}\mathcal{H}_{t}$。审计规划复用了依赖概率,无需额外的模型调用。每个交接处 $(e_{u},e_{t})$ 承载隐式语义契约:接收端应保留信息源含义、避免将不确定信息视为既定事实,并遵守任务需求。与形式化契约验证不同,这些义务通过结构化语义判定来评估。BLADE 从任务 $q$ 中提取需求片段 $R$,并将其与完整轨迹一起纳入审计状态 $s_{\tau,R}$。
通过 Jev 将每个事件分类为智能体决策或证据,记作 $\kappa(e_{t})$,并评估每个选定的接收端事件 $e_{t}$ 如何使用其信息源 $e_{u}$。对于提问 $x_{ut}^{\mathrm{use}}$,Jev 在九个预定义标签 $\mathcal{L}$ 上分配概率:
$$
p_{ut}(\ell)=P_{\mathrm{Jev}}\big(\ell\mid s_{\tau,R},x^{\mathrm{use}}_{ut}\big),\qquad\ell\in\mathcal{L}.
$$
其中 $\ell_{ut}$ 为概率最大的标签,$\pi_{ut}$ 为其对应的概率。标签用于区分潜在的错误引入、现有错误的继承或修复,以及未产生保留发现的情形。标签划分为三组,$\mathcal{L}=\mathcal{L}_{\mathrm{kept}}\cup\mathcal{L}_{\mathrm{breach}}\cup\mathcal{L}_{\mathrm{inh}}$:
- $\mathcal{L}_{\mathrm{kept}}$ 代表忠实使用、未实际使用该信息源,或证据不足以评估该交接处。
- $\mathcal{L}_{breach}$ 代表通过未经核实的采纳、适用不当的信息、曲解或引入新错误的修正,所造成的潜在错误引入。
- $\mathcal{L}_{inh}$ 代表现有错误的传播,或在不引入新错误的前提下进行的修复。
对于进入智能体决策的交接处,BLADE 将非保持(non-kept)的判定保留为结构化发现。令 $\mathcal{H}^{\mathrm{dec}}=\{(e_{u},e_{t})\in\mathcal{H}:\kappa(e_{t})=\mathrm{decision}\}$。所得的发现为
$$
F=\bigl\{ (e_{u},e_{t},\ell_{ut},\pi_{ut}): (e_{u},e_{t})\in\mathcal{H}^{\mathrm{dec}},\ \ell_{ut}\notin\mathcal{L}_{\mathrm{kept}}\bigr\}.
$$
通过以上的构建,Blade 将 Traj 构建为责任图:$G=(V,E,R,F)$,其中 E 为依赖关系边,V 为节点,R 提供用来评估这些交互的任务需求。
给定任务 $q$、完整轨迹 $\tau$ 以及责任图 $G$,Jev 回答与 All-at-once 基线相同的决定性步骤问题,该问题通过结构化责任证据得到了增强:
$$
\hat{t} =\arg\max_{t\in\{1,\dots,T\}}P_{\mathrm{Jev}}\bigl(e_{t}\mid q,\tau,G\bigr), \hat{a} =a(e_{\hat{t}}).
$$
Blade 在评测数据集的表现如下表:
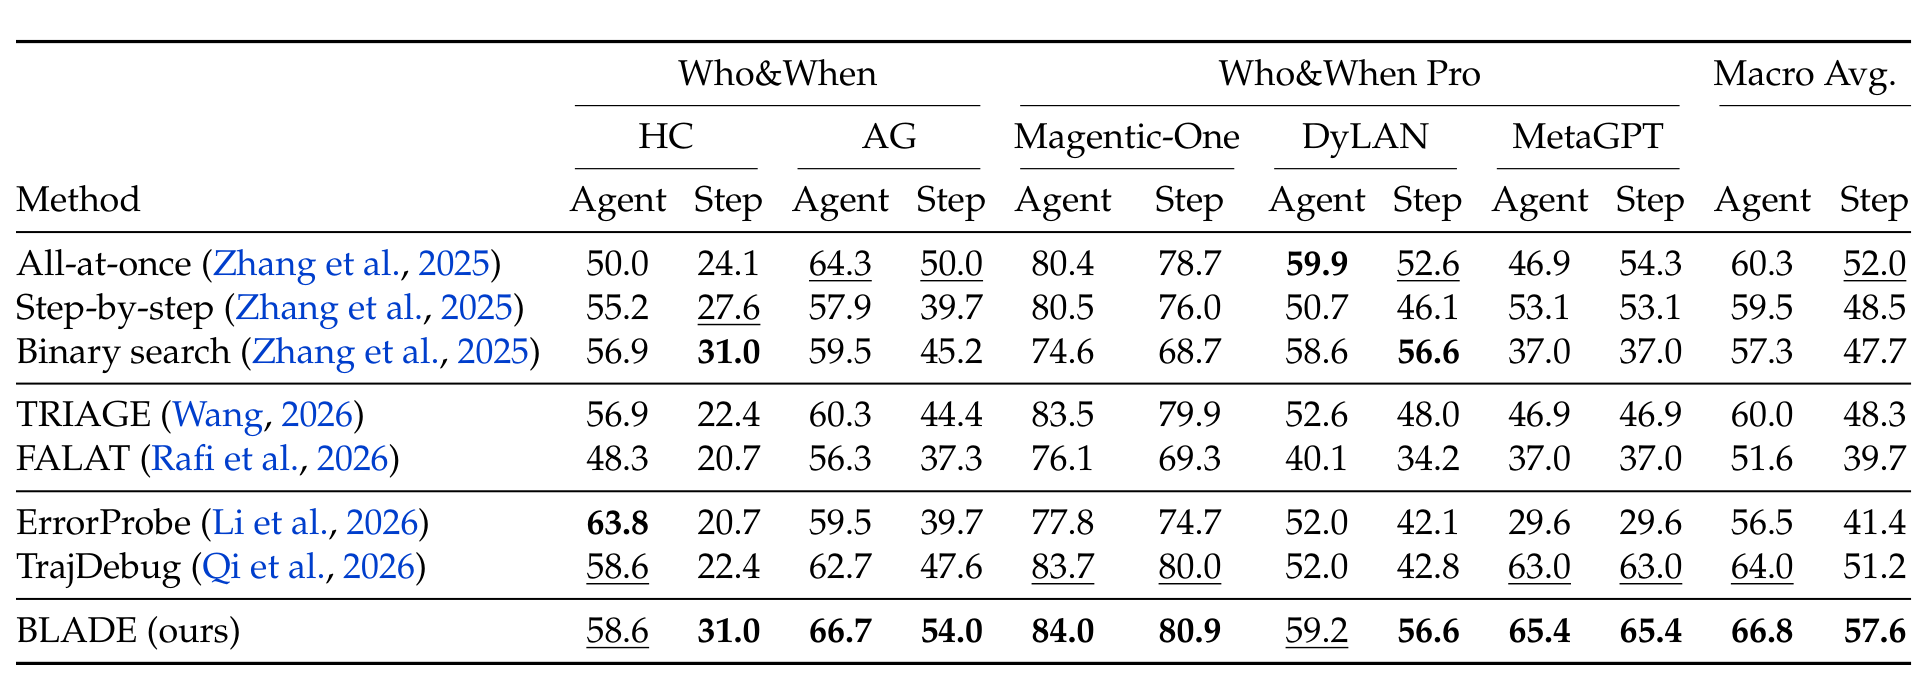 表 1:无参考答案条件下的智能体与步骤准确率(%)。所有方法均在同一个 Jev 决策接口下实例化(附录 B.2)。HC:人工设计(Hand-Crafted);AG:算法生成(Algorithm-Generated)。宏平均(Macro Avg.)对五个子集赋予同等权重。粗体表示最优,下划线表示次优。
Blade 通过完全由 Jev 来进行归因,达到的快速、低成本的归因方式,但是我想如果在构建好了责任图之后由 LLM 来决策,效果会不会更好一些,因为推理模型在长上下文、结构化的语言组织上可能具备更好的归因能力。实际上,Jev 的决策只能归因到一个具体的模型,而某些错误可能是多种错误信息结合而成,Jev 的输出导致其只能局限在单一智能体。
同时,Blade 的测评框架不具备泛用性,针对于不同的 Harness 框架需要做一些微调。
评论