算法笔记大合集
把博客园两年间写下的算法笔记整理成一部合集:基础算法、搜索、动态规划、数据结构、字符串、图论、数学,共七章
这篇合集把我 2023-2024 年写在博客园的算法笔记整理成了七章。整理时保留了原文的思路讲解、推导和代码(包括当年随手写下的吐槽),个别只贴了代码的地方补了讲解,写得特别长的地方稍作精简,图床失效的图做了说明。想看未删减的原文,点每节开头的源笔记链接即可。
第一章 基础算法
1.1 前缀和与差分
前缀和解决的是"多次查询任意区间和":预处理 $s_i = s_{i-1} + a_i$ 后,$[l, r]$ 的和就是 $s_r - s_{l-1}$。二维版本按容斥展开:$s_{i,j} = s_{i-1,j} + s_{i,j-1} + a_{i,j} - s_{i-1,j-1}$。当时在《基础算法大全》里写的模板:
///s[i][j] = s[i-1][j] + s[i][j-1] + a[i][j] - s[i-1][j-1]
for (int i = 1; i <= n; i++)
    for (int j = 1; j <= m; j++)
        s[i][j] = s[i-1][j] + s[i][j-1] + a[i][j] - s[i-1][j-1];
// 查询 (x1,y1)-(x2,y2):
printf("%d\n", s[x2][y2] - s[x2][y1-1] - s[x1-1][y2] + s[x1-1][y1-1]);
差分是前缀和的逆运算:$a$ 是 $b$ 的前缀和,那么"区间 $[l,r]$ 整体加 $c$“只需 $b_l \mathrel{+}= c,\ b_{r+1} \mathrel{-}= c$,最后做一遍前缀和还原:
void Insert(int l, int r, int c) {
    b[l] += c;
    b[r + 1] -= c;
}
《再谈 前缀和,差分,离散化》里用三道题把这套东西串了起来:
- 激光炸弹(P2280):二维前缀和后枚举每个框。注意"点在边上无效”——3×3 的框实际框住的是 2×2 的炸弹,所以累加时从 $(1,1)$ 开始而不是 $(0,0)$;
- 增减序列:目标是把差分数组 $c_2 \dots c_n$ 全变为 0。设正数和为 $res$、负数和为 $ans$,每次操作可以选一个正一个负同时消去,答案就是 $\min(res,ans) + |res-ans|$,方案数为 $|res-ans|+1$;
- 借教室(二分 + 差分):暴力逐个订单检查是 $O(nm)$ 只有 45 分;观察到"前 $k$ 个订单不超限"具有单调性,二分答案,
check里用差分把前 mid 个订单累加后逐位验证,降到 $O((n+m)\log m)$。那篇笔记里两版代码都留着,对比着看很有意思。
源笔记:基础算法大全 · 再谈 前缀和,差分,离散化
1.2 双指针与离散化
双指针的入门题是最长不重复子串:右指针 $i$ 不断右移,发现重复后左指针 $j$ 一直右移直到窗口干净。两个指针各走 $n$ 步,均摊 $O(n)$:
for (int i = 0; i < n; i++) {
    s[a[i]]++;
    while (s[a[i]] > 1) s[a[j++]]--;  ///直到 j 与 i 的区间内没有重复元素
    res = max(res, i - j + 1);
}
离散化解决"值域大、个数少":把出现过的坐标排序去重,二分找秩。经典应用是程序自动分析(P1955)——$i, j$ 开到 $10^9$,不离散化等着爆吧。流程:先把所有下标排序去重,相等约束先全部合并,再逐条检查不等约束有没有被并进同一集合(查找内鬼)。
源笔记:基础算法大全
1.3 快速幂与高精度
快速幂把 $O(k)$ 的幂运算压到 $O(\log k)$:指数按二进制拆位,平方底数、按位乘入答案。
//a^b%k
long long qpow(long long a, long long b, long long k) {
    long long res = 1;
    while (b) {
        if (b & 1) res = res * a % k;
        b >>= 1, a = a * a % k;
    }
    return res;
}
高精度用数组按位存(下标 1 为个位)。加法逐位相加带进位 $t$;乘法的核心是"$i$ 位乘 $j$ 位落在 $i+j-1$ 位":
c[i + j - 1] = a[i] * b[j] + t + c[i + j - 1];
t = c[i + j - 1] / 10;
c[i + j - 1] %= 10;
练手:加法/乘法模板题、[NOIP1998] 阶乘之和(边乘边加边进位,最后清前导零)。
1.4 贪心
当时的贪心笔记是一个区间类大合集,一个模型配一道题:
- 区间选点 / 最大不相交区间:按右端点排序,能放就放。区间选点(放最少的点覆盖所有区间)和 yyy 选比赛(参加最多的比赛)是同一套排序的两种问法——“结束越早,腾出的空间越多”;
- 区间分组:按左端点排序,小根堆维护每组的最大右端点。新区间若与堆顶(最小右端点的组)都相交就新开组,否则并入右端点最小的组,组数即堆的大小;
- 合并果子:每次合并最小的两堆,小根堆裸题;
- 转化型:雷达覆盖把每个点转成 x 轴上的区间 $[x-d, x+d]$($d=\sqrt{r^2-y^2}$),退化成区间选点;田忌赛马用"上等马对上等马、下等马对下等马、最差的马消耗对方上等马"的双指针策略;钓鱼问题枚举最后一个湖,堆内按当前产量反复取最大。
区间分组的实现(注释是原文的):
// 用小根堆维护所有组的右端点的最大值
priority_queue<int, vector<int>, greater<int>> heap;
for (int i = 0; i < n; i++) {
    // 如果堆为空或者堆的最小右端点 >= 现在区间的左端点,说明有交集,需要新开一个组
    if (heap.empty() || heap.top() >= range[i].l) heap.push(range[i].r);
    // 否则说明至少与最小的右端点的组没有交集,将它放到右端点最小的组里去
    else { heap.pop(); heap.push(range[i].r); }
}
printf("%d\n", heap.size());源笔记:贪心算法
1.5 反悔贪心
这是当时写得最完整的一篇理论笔记,“爬山"的比喻原文照录:
众所周知,正常的贪心算法是指在对问题求解时,总是做出在当前看来是最好的选择……每一步都是站在当前产生的局面上所作出的最好的选择,是没有反悔操作的。不加反悔的一直朝着当前局面的最优解走很可能导致我们被困在局部的最优解而无法到达全局的最优解,就好像我们爬山就只爬到了一座山的山顶却没有到整片山的最高处。但是反悔贪心允许我们在发现现在不是全局最优解的情况下回退一步或若干步采取另外的策略去取得全局最优解——就好像我们站在的一座山的山峰上,看到了还有比我们现在所在位置还高的山峰,那我们就反悔:下山再爬上那座更高的山。
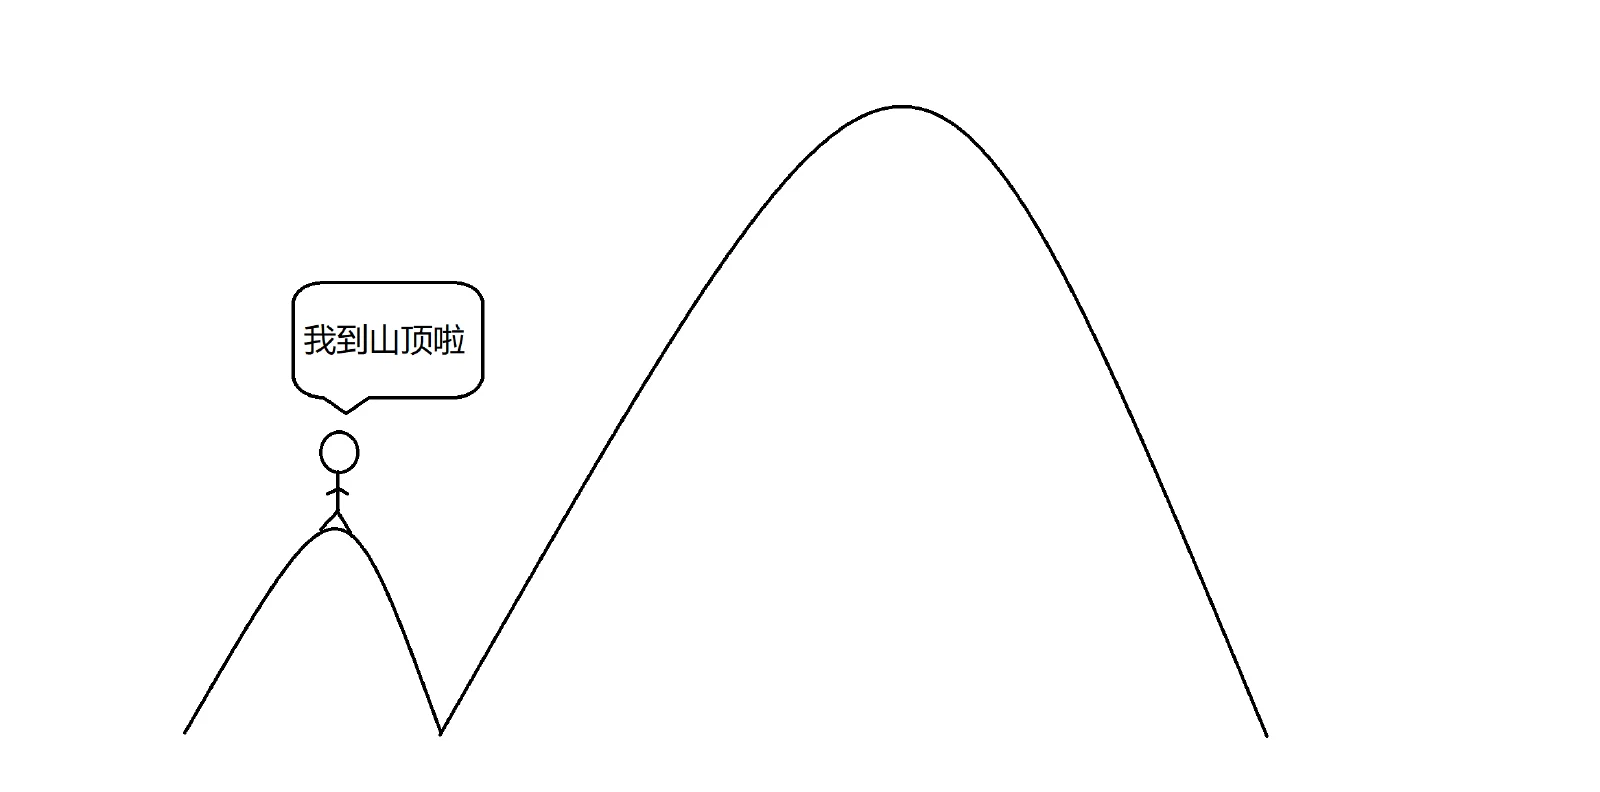
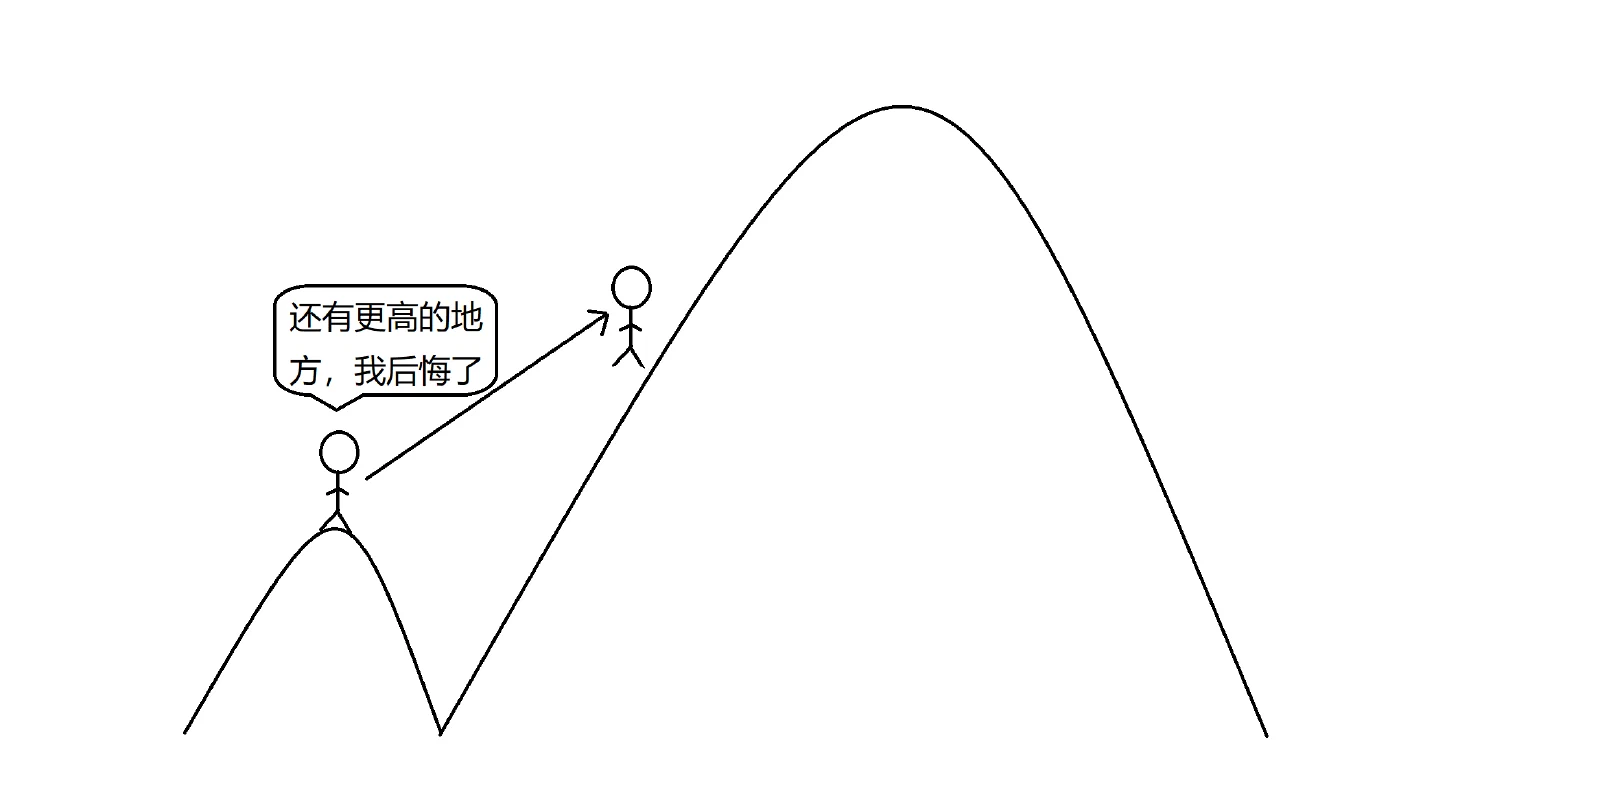
按实现方式分两派:反悔堆(用堆维护已选决策中"性价比最低"的,新决策更优就替换)和反悔自动机(设计一种差值拆分,使任何贪心路径都收敛到全局最优)。
用时一定模型(工作调度):任务按截止时间排序,时间够就做、利润进小根堆;时间不够,就用当前任务换掉堆里利润最低的任务——任务数不变、总利润更大:
sort(v.begin(), v.end());
int now = 0, res = 0;
for (auto [x, y] : v) {              // x=截止时间, y=利润
    if (x > now) res += y, now++, que.push(y);
    else if (!que.empty() && y > que.top())
        res += (y - que.top()), que.pop(), que.push(y);   // 反悔:换掉利润最低的
}价值一定模型(建筑抢修 [JSOI2007]):价值都一样,就换掉耗时最长的任务,给后面留更多时间——维护大根堆,写法对称:now + x < y 就做,否则 x < que.top() 时替换。
堆反悔自动机(CF865D Buy Low Sell High)的关键是恒等式:
$$C_{sell} - C_{buy} = (C_{sell} - C_i) + (C_i - C_{buy})$$原文的解释:我们先把当前的价格放入小根堆一次(贪心),判断当前的价格是否比堆顶大,若是,就将差值计入全局最优解,再将当前的价格放入小根堆(反悔操作)——相当于把当前的股票价格作为"中间变量” $C_i$ 记录下来,之后某天真的卖出时,差值自然把中间项消掉,等价于从最优的那天买、最优的那天卖。
双向链表反悔自动机(种树 BZOJ2151):选了 $B$ 之后相邻的 $A, C$ 作废,但如果全局最优是 $A+C$ 呢?新建一个价值为 $a + c - b$ 的节点 $P$ 替换进链表,下次选中 $P$ 就等于反悔"不选 $B$ 改选 $A+C$"。配合大根堆 $O(n \log n)$。原文的四个注意点:一定要记录这个点选没选过,已选过的从堆中丢出去;1 与 n 相邻要特判;双向链表一定不要写挂了;一定要先将新建点的价值存入价值数组再丢进堆(不然会卡数据)。
源笔记:反悔贪心学习笔记
1.6 倍增
倍增的直觉:任何 $k$ 都能拆成 2 的幂之和,于是预处理 $f_{i,j}$ = 从 $i$ 走 $2^j$ 步到的位置,查询从高位到低位跳,$O(\log k)$:
for (int j = 1; j < 20; j++)
    for (int i = 1; i <= 2 * n; i++)
        f[i][j] = f[f[i][j - 1]][j - 1];   // 从 i 位置跳 2^j 个位置
两道代表题:
- 跑路(P1613):每秒能跑 $2^k$ 千米,求最少秒数。倍增预处理可达性——
edge[i][j][k]表示 $i$ 到 $j$ 有恰长 $2^k$ 的路径,转移类似 Floyd:$i \to e \to j$ 各走 $2^{k-1}$。然后把所有"一秒可达"的点对连边(边权 1)跑 Dijkstra。原文笔记的口诀:“三重循环类似于 floyd,如果 i 能到 e、j 也能到 e,那么 i 到 j 就是 2 的 k 次方,此时就可以判断为 1 秒”; - 国旗计划(P4155):环形区间覆盖,破环为链复制一份,先算出每个位置"右端点下一个位置" $f_{i,0}$,倍增跳。原文专门讨论了计数的细节:把
cnt设为 1 是因为枚举步数时要求右端点小于目标值——最后一步可能正好压线,统一少算一步最后 +1 才不会重。
源笔记:倍增
第二章 搜索
2.1 DFS:两个基本型
一切 DFS 题都从两个基本型开始。排列型——n-皇后:逐行放置,用三个布尔数组分别标记列、主对角线、副对角线(原文注释:"$u+i$ 是根据对角线规律,每个对角线上的点都等于行数加列数;$n-u+i$ 是防止 $i-u$ 为负数"),放完递归、回来恢复现场:
if (!cow[i] && !dg[u+i] && !rdg[n-u+i]) {
    Q[u][i] = 'Q';
    cow[i] = dg[u+i] = rdg[n-u+i] = true;
    dfs(u + 1);
    cow[i] = dg[u+i] = rdg[n-u+i] = false;  // 恢复现场
    Q[u][i] = '.';
}
另一种写法是逐格枚举 dfs(x, y, q)——每个格子有"放/不放"两条路,搜完全盘再检查皇后数,原文称之为"原始方法,通俗易懂"。
二选一型——PERKET 配料:每个物品只有加/不加两条分支,两条 dfs 并列展开,本质是枚举子集。选数(P1036)是组合版:传 start 参数只向后找,原文点破了关键——“为什么要这样呢?因为从 0 开始会遍历整个数组,这个就是开始位置的妙处”。
2.2 BFS:最短路与"入队即标记"
BFS 按层扩展,第一次到达某点的步数即最短步数——迷宫最短路(POJ3984,还可用 pre[][] 记父节点倒序输出路径)、马的遍历都是裸 BFS。
马的遍历那篇笔记专门复盘了一次 MLE+TLE:标记必须在入队时立刻打上,不能等出队时再标。原文的解释:“因为我们是宽搜,搜过的不能再搜了。如果不立马标记的话,会发生另外一队来搜的时候,发现你这个点还是没标记,然后再给你标记一下……所以会增加时间和空间,就会爆掉”:
if (x1 >= 1 && y1 >= 1 && x1 <= n && y1 <= m && vis[x1][y1] == -1) {
    node next = {x1, y1, now.step + 1};
    vis[x1][y1] = now.step + 1;   ///入队时立刻标记
    que.push(next);
}
BFS 遇到"额外限制"时把状态升维即可,当时练过的变体:陨石避难(每格危险时间 time1[][],$t+1 < time1$ 才能走,且同一个坑可能被砸两次要取最小值)、鸣人与佐助(查克拉是状态的一部分,vis[x][y][chakra] 三维)、Saving Tang Monk(钥匙数 + 优先队列 + 杀蛇耗时 +2)、Corn Maze(传送门要先传送再扩展,原文:先走再判传送门会死循环,卡在 60 分)、ROADS(把费用当状态维度,dis[点][费用] 分层最短路)。
Flood fill(卫星照片数最大连通块)则展示了 DFS 不需要回溯的一面,原文的分析:“dfs 是一条路走到黑……只要被走过、不是起点,那么就肯定没有起点多,故不需要回溯”。
2.3 记忆化搜索
滑雪:从高处滑向低处求最长路径。裸 DFS 大量重复计算,加一个缓存 $f_{x,y}$ 即 $O(nm)$。当时的原话:“能用记忆化搜索的题肯定能用 dp,能用 dp 的不一定用记忆化搜索”,以及另一篇里的金句"所有的记忆化搜索都可以转化为动态规划,但所有的动态规划不一定能转换成记忆化搜索":
int dfs(int x, int y) {
    if (f[x][y]) return f[x][y];   // 如果本来就存在,那就直接返回
    for (int i = 0; i < 4; i++) {
        int x1 = x + dx[i], y1 = y + dy[i];
        if (a[x][y] > a[x1][y1])
            f[x][y] = max(f[x][y], dfs(x1, y1) + 1);
    }
    return f[x][y];
}源笔记:滑雪 OJ3651
2.4 剪枝四板斧
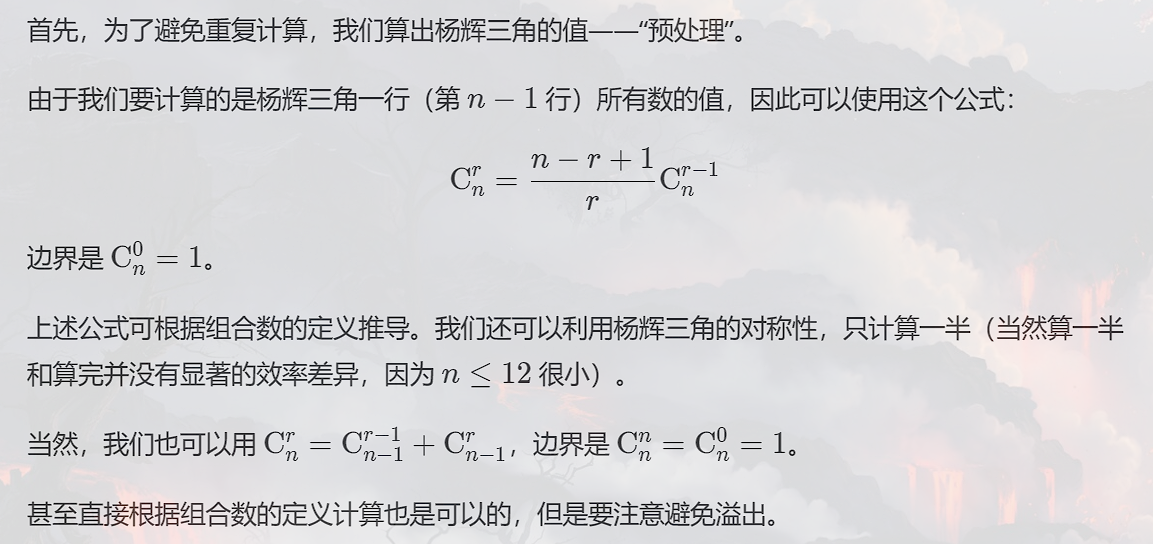
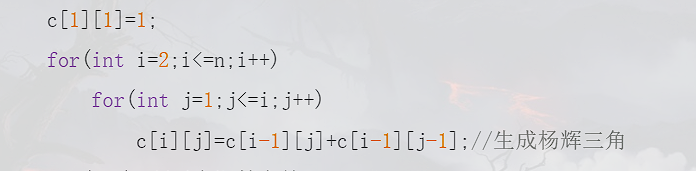
以大波长条(P1118)为例:暴力全排列必炸。先由高中知识把答案线性化——四个数 $a,b,c,d$ 的加权和的系数恰好是杨辉三角第 $n$ 行,即 $res = a + 3b + 3c + d$,搜索时维护这个加权和即可(这也是为什么笔记开头贴了两张杨辉三角的图):
四个方向的剪枝(可行性剪枝的代码):
bool dfs(int cnt, int num, int sum) {
    if (sum > k) return false;        // 最优性/可行性剪枝:加权和已超
    if (cnt == n) { if (sum == k) { res[cnt] = num; return true; } return false; }
    vis[num] = true;
    for (int i = 1; i <= n; i++)
        if (!vis[i] && dfs(cnt + 1, i, sum + cow[cnt] * i)) { res[cnt] = num; return true; }
    vis[num] = false;                 // 回溯标记,为先前的循环做准备
    return false;
}木棒拼接(Sticks)是剪枝大全:从大到小排序(避免重复拼接)、枚举因数、同长跳过、fail 记录失败长度、回溯标记代替 memset、空木棒失败直接返回 false。DNA 一题则先预处理剔除子串和重复串——原文:“很有效率,快了 10 倍”。
2.5 迭代加深与双向搜索
迭代加深:给 DFS 设深度上限,搜不到就加大上限重来。看似重复搜索,但树的节点数随深度指数增长,浅层的代价可以忽略(原文算过账:“如果当前搜索是第 10 位,搜索的是个二叉树,那么前 9 个就是 $2^0+\dots+2^9 = 2^{10}-1$,所以时间复杂度并没增大太多”)。加法序列、四子棋都是典型。
双向搜索(送礼物,$n \le 45$):$2^{45}$ 直接枚举不行,拆成前后两半——前半预处理所有子集和,排序去重;后半每算出一个子集和,就在前半的表里二分找"不超过剩余容量的最大值"。复杂度从 $2^n$ 降到 $2^{n/2} \cdot n$。剪枝同样重要:从大到小排序优先搜大的数——原文:“当前的和更大,当前的分支会更快的到达 m,也就是使我们的搜索深度变浅”。
2.6 A* 与 IDA*
A* 把 BFS 的队列换成优先队列,priority = 真实距离 + 估价距离,估价必须不超过真实剩余代价。八数码用曼哈顿距离,状态用 string + 哈希表。原文当时的学习感受:“3 个小时理解+学新东西,要清楚这里面的估价距离是怎么算出来的。”
IDA* = 迭代加深 + 估价剪枝:depth + f() > max_depth 就提前剪掉。两个实现要点都来自原文笔记:
- 排版书(UVA1343):把 8 种旋转打表成位置数组(“在进行图形变换时,打表是种常用的方法”);估价函数取"8 − 中心 8 格中出现最多的颜色数";剪枝时排除与上一步相反的操作(否则互相抵消);
- 骑士换色(P2324):估价取两侧"颜色不对的棋子数"的较大值——原文的推导:“最好情况,3 个黑的换 3 个白的,剩下的那个空一定和黑的交换,即每次的最小次数就是两者的最大值。“最终 300ms 通过。
int f() {   // UVA1343 估价:8 - 中心区同色最多数
    int sum[4] = {0}, maxx = 0;
    for (int i = 0; i < 8; i++)
        sum[mp[center[i]]]++, maxx = max(maxx, sum[mp[center[i]]]);
    return 8 - maxx;
}
bool dfs(int depth, int max_depth, int lst) {
    if (depth + f() > max_depth) return false;   // IDA* 剪枝
    if (f() == 0) return true;
    ...
}2.7 双端队列 BFS(0-1 BFS)
边权只有 0/1 的最短路不必上 Dijkstra:0 边到达的节点从队头入队,1 边到达的从队尾入队,队列距离保持"两段性 + 单调性”,每点只入队一次,$O(nm)$。电路板(P4667)是标准题:把每个格点建图,与对角线重合的方向边权 0、需要旋转的方向边权 1。原文对正确性的说明:“由于一般的广搜的队列层级是单调递增的,所以为了保证这个性质,将 (x,y) 从队首入队。”
if (turn(a, b, x, y)) {                        // 电线不直连,代价 1
    dis[x][y] = min(dis[x][y], dis[a][b] + 1);
    q.push_back({x, y});                       // 队尾
} else {                                       // 直连,代价 0
    dis[x][y] = min(dis[x][y], dis[a][b]);
    q.push_front({x, y});                      // 队首
}
那篇笔记里还有一个把格点建图跑 Dijkstra 的 94 分做法,正好和 0-1 BFS 对照着看。
另外,《搜索算法》这篇笔记里还收录了当时抄录整理的全套最短路模板——朴素/堆优化 Dijkstra、Bellman-Ford(限制边数版)、SPFA(含判负环:cnt[v] >= n 即有负环)、Floyd、最短路计数(cnt[v] += cnt[u] 当 dist[v] == dist[u]+1)——统一放在第六章 6.1。
第三章 动态规划
3.1 背包全家桶
《动态规划dp》这篇入门笔记把背包五连一次讲全了。开头的方法论原文照录:“要想明白动态规划路线——第一步写出动态集合,第二步开始动态计算”,以及下标技巧:“当计算用到 i-1 的时候,可以让 i 从 1 开始,就没有越界的风险”。
0-1 背包:二维定义 dp[i][j] 表示考虑前 i 个物品、容量 j 的最大价值;一维优化后必须倒序枚举容量:
for (int i = 1; i <= n; i++)
    for (int j = m; j >= w[i]; j--)   ///倒序,保证每个物品只选一次
dp[j] = max(dp[j], dp[j - w[i]] + v[i]);完全背包与 0-1 只差一行——正序枚举。原文专门强调:“看好 0-1 背包和完全背包问题非常的相似,想清楚这两者只差一行代码的区别在哪!!!!"(0-1 看 i-1 的状态,完全背包看 i 的状态,不需要倒序。)
多重背包:暴力就是 k 循环上限加一个 s[i] 限制;正解是二进制拆分——原文的解释:“使用二进制计数法,例如 s=200,那么我们的 k 就可以循环到 64(1,2,4,…,64),此时可以表示出 1-127 的所有数字,剩下的用 73 补”,拆完后按 0-1 背包做:
int k = 1;
while (k <= s) {
    cnt++;
    w[cnt] = k * a, v[cnt] = k * b;
    s -= k, k *= 2;
}
if (s > 0) { cnt++; w[cnt] = a * s; v[cnt] = b * s; }分组背包:每组至多选一个,三重循环"组→容量→组内物品”。依赖背包(金明的预算方案 P1064):附件最多 2 个时直接枚举四种情况——只要主件、主+附1、主+附2、主+双附件。原文的复盘:“当时做这个题时满脑子都是思路,一遍遍确认一遍遍不对,最后大体思路是对的,但没想到分情况讨论。”
源笔记:动态规划dp
3.2 线性 DP:从数字三角形到 LCS
- 数字三角形:自上而下 $f_{i,j} = \max(f_{i-1,j-1}, f_{i-1,j}) + a_{i,j}$。两个初始化细节都在原文注释里:“一定要记得从起点开始初始化,不然会变成负无穷"“一定要从第二层开始,如果从第一层开始,第一次会访问到负无穷区域”。
- LIS:$O(n^2)$ 的 $f_i = \max_{a_j < a_i}(f_j + 1)$;$O(n \log n)$ 的贪心+二分版维护数组 q(q[i] = 长度为 i 的上升子序列结尾最小值)。输出方案加一个
g[i]记录前驱即可。ABC354F 的"某位置是否在 LIS 上"用正反两遍 LIS:$dp[i]$(以 i 结尾)+ $dp2[j]$(以 j 开头,倒着求最长下降),若 $dp[i] + dp2[j] - 1 = $ LIS 长度,则 i 在某条 LIS 上。 - LCS:$f_{i,j} = \max(f_{i-1,j}, f_{i,j-1}, [a_i{=}b_j]\,f_{i-1,j-1}+1)$。升华版是 P1439:把第一个串重标号为 $1..n$(离散化),第二个串映射过去后最长公共子序列变成最长上升子序列,$O(n \log n)$。原文的讲解很清楚:“满足上升的也就是满足原串的排列顺序的,现在的问题就变成了求一个最长不下降序列!”
- 编辑距离(P2758):$dp_{i,j}$ = A 前 i 位变到 B 前 j 位的最少步数,转移
min({dp[i-1][j]+1, dp[i][j-1]+1, dp[i-1][j-1]+(st[i]==ed[j]?0:1)})——原文对三种操作各给了一句白话解释(删除 i 位、抵消 B 的 j 位、两位相等就白嫖)。 - 等差数列计数(P4933):$f_{i,d}$ = 以 i 结尾、公差 d 的方案数,$f_{i,h_i-h_j} \mathrel{+}= f_{j,h_i-h_j}+1$,公差加 20000 防负。
3.3 区间 DP
区间 DP 有两种循环写法,原文都给了模板。第一种枚举区间长度(石子合并 P1775):
for (int len = 2; len <= n; len++)
    for (int i = 1; i + len - 1 <= n; i++) {
        int l = i, r = i + len - 1;
        dp[l][r] = 1e9;
        for (int k = l; k < r; k++)
            dp[l][r] = min(dp[l][r], dp[l][k] + dp[k+1][r] + s[r] - s[l-1]);
}第二种枚举端点,“类似于图论中的 Floyd 算法”——原文特别提醒:“记住左端点一定是倒序遍历,不然会遍历不全”:
for (int i = n; i >= 1; i--)
    for (int j = i + 1; j <= n; j++) {
        dp[i][j] = 1e9;
        for (int k = i; k < j; k++)
            dp[i][j] = min(dp[i][j], dp[i][k] + dp[k+1][j] + s[j] - s[i-1]);
    }
环形版(合并果子加强版 P1880):“把这个环拆开,再补一个从 1 到 n 的链”,倍长数组后枚举所有长度为 n 的区间取最优。Treats for the Cows 则展示了反向定义的魅力:$dp_{i,j}$ = “区间 $[i,j]$ 还没被卖出”,从满区间往单点推,每个状态乘以"第几次卖出"的天数。
3.4 树形 DP 与状态机 DP
树形背包(选课 CTSC1997):森林多根时建一个 0 号虚拟节点,“0 节点是必须选的,但价值是 0”,答案取 f[0][m+1]。转移是经典树 上分组背包:f[u][j] = max(f[u][j], f[u][j-k] + f[son][k]),注意容量倒序。选完子树后把 u 自己挤进来:f[u][i] = f[u][i-1] + v[u]。
状态机 DP 的代表是股票系列。两笔交易版:$dp_{i,j,0/1}$ = 第 i 天、已完成 j 笔交易、当前无票/有票:
dp[i][j][0] = max(dp[i-1][j][0], dp[i-1][j][1] + w[i]);
dp[i][j][1] = max(dp[i-1][j][1], dp[i-1][j-1][0] - w[i]);
原文提醒的坑:“要把三种情况都判断——只买一次的情况是,再买第二次就亏了,所以买了直接卖出,这种算第一次的最大值。“带冷冻期版把状态拆成三个:0 持有、1 刚卖出(冷冻)、2 冷冻期结束——转移构成一个环形的状态机。还有一类"KMP 上跑状态机”(密码不含子串 T):dp 的第二维是"当前匹配到 T 的第 j 位”,用 KMP 的 fail 指针做 26 个字母的转移,转移后 $u = m$ 的状态直接不允许。
3.5 状态压缩 DP
原文的定义写得直白:“状态压缩也就是把多个状态都转译成一个状态……设有 m 个状态,那么所有可能状态为 $2^m$,比如 0010 表示只满足第二个状态。状态合并使用 |,将两个状态的 1 合并。”
三道阶梯题:
- 糖果(P2576 类):每包糖果预处理出口味集合
candy[i],$f_{j|candy_i} = \min(f_{j|candy_i}, f_j + 1)$,$O(n \cdot 2^m)$; - 互不侵犯(P1896,棋盘状压):先筛出行内合法状态(
check(x)判相邻 1),再预处理任意两状态的兼容表head[a](!(a&b) && check(a|b)),dp 加一维"已用国王数”。原文:“由于时间复杂度达到了指数级,所以搜索不能进行,考虑动态规划”; - 吃奶酪(P1433):$f_{i,k}$ = 已吃集合 k、当前在 i 的最短路,标准 TSP 形态。
3.6 单调队列优化 DP
单调队列的模板直觉(原文):“队列内的元素有单调性,答案(最优解)就在队首,而队尾则是最后进队的元素。经常被用来维护区间最值或者降低 DP 的维数。“滑动窗口(P1886):
while (hh <= tt && q[hh] < i - k + 1) hh++;      ///出队头:滑出窗口
while (hh <= tt && a[q[tt]] >= a[i]) tt--;       ///队尾无用元素直接删
q[++tt] = i;
if (i >= k) cout << a[q[hh]] << ' ';
DP 优化(琪露诺 P1725):$f_i$ 从 $[i-r, i-l]$ 转移,滑动窗口维护这个区间的最大 dp 值。原文对"为什么是 $i-l$ 入队"的解释:“我们向前走一步,即 i 变成 i+1,我们的区间窗口也要滑动,此时新进来的数就是 $i-l$"。
跳房子(P3957)= 二分答案 + 单调队列:金币越多灵活度越大,答案单调,二分 g;check 里窗口 $[d-g, d+g]$,单调队列维护可达 dp 最大值。
单调队列优化多重背包是那篇笔记的重头戏,推导原文照录。从 $F[i][j] = \max\{F[i-1][j - k\cdot v_i] + k\cdot w_i\}\ (0 \le k \le m_i)$ 出发,令 $j = a\cdot d + b$($d = v_i$),按余数 b 分组后同一组内的候选值是"滑动窗口最值”:
$$F[i][j] = \max\{F[i-1][b + k\cdot d] - k\cdot w_i\} + a\cdot w_i$$原文的辅助队列总结:“当指定队列有元素 M 进入时,删除队列 B 中比 M 小的所有元素,并将 M 存入队列 B;当 M 离开时,若 B 的第一个元素与 M 相等,B 的第一个元素也离队”——这正是"用一个辅助队列求另一个队列的最值”,也就是《背包九讲》里那个让人稀里糊涂的"单调队列”。
源笔记:单调队列及单调队列优化DP
3.7 数位 DP
数位 dp 的总纲(原文):“大多使用高位计算的时候使用低位计算后的结果,从而做到优化效率。“笔记里给了两种流派:
递推法(数字计数 ZJOI2010):先预处理 $dp_i$ = i 位数中每种数字出现次数,两个等价公式 $dp_i = dp_{i-1}\cdot 10 + 10^{i-1}$ 和 $dp_i = \dfrac{i \cdot 10^i}{10}$。统计 $[0, 324]$ 时按位拆:普通段直接用 $dp_{i-1}$,最高位 $0 \sim num_i - 1$ 各补 $10^{i-1}$,最后把最高位为 0 的多算部分减掉($cnt_0 -= 10^{i-1}$)——原文还提醒了 “00~99 是按不合法的统一处理,到后面会减去”。
记忆化搜索法:状态 $dp_{pos, sum, lead, limit}$。以 windy 数为例:
int dfs(int pos, int last, int lead, int limit) {
    if (pos == 0) return 1;
    if (last >= 0 && dp[pos][last][lead][limit] != -1) return dp[pos][last][lead][limit];
    int ans = 0, to = limit ? num[pos] : 9;
    for (int i = 0; i <= to; i++) {
        if (abs(i - last) >= 2)          // windy 条件:相邻两位差 >= 2
            ans += dfs(pos - 1, i, false, limit && i == to);
    }
    dp[pos][last][lead][limit] = ans;
    return ans;
}原文对 lead/limit 的说明:lead 表示是否有前导零;limit 表示是否卡上界——“若计算最高位 3 开始的数字,有数位限制”,limit && i == to 只有贴着上界走才继续受限。同类分布(P4127 / ABC E-Digit Sum Divisible)则把"数位和"和"模数位和的余数"都塞进状态:$dp[i][j][k][l]$,转移 $f_{i,j+t,(10k+t)\bmod m, l'}$——枚举的模数 m 最多 9 位数位和,逐个 m 跑一遍数位 dp 即可。
源笔记:数位 DP
3.8 换根 DP
问题:求分别以每个点为根时的深度总和。暴力 $O(n^2)$,换根 $O(n)$。原文的推导配了一张把树分成两部分的图:
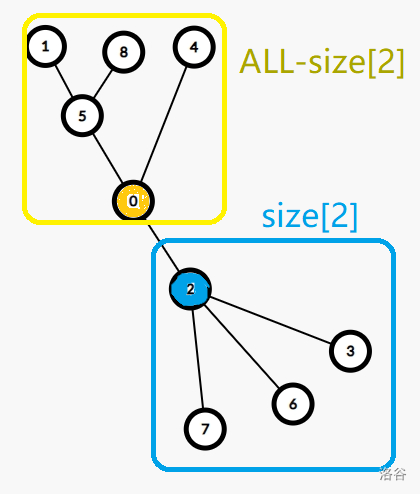
先以 1 为根 dfs 求出 $dp_1$ 和子树点权和 $size_u$,然后从父亲推儿子——“黄框框出的部分内部所有节点到根节点的距离都要增加一个 $w_{u \to x}$,其答案应该增加 $(ALL - size_x)\cdot w$;红框部分所有节点距离根节点都要减去边权,所以答案还应该减去 $size_x \cdot w$":
int ndp = cur;
ndp += (sum - sz[x]) * y - sz[x] * y;   // dp[x] = dp[u] + 外部 - 内部
dfs2(x, u, ndp);
笔记后附着七道同型题清单(MPM800 / 集会 / Distance Sums 2 / Tree with Maximum Cost / STA-Station / Tree Painting / 城市),原文的原话:“下面的题只需要改改边权改改点权就可以了。“其中 Tree with Maximum Cost 一题还给了点权版的完整代码,以及一个用重心直接做的替代解法——重心满足"最大子树不超过一半”,从重心出发一遍 dfs 累加 $c_x \cdot depth$ 即可。
源笔记:树上深度和问题 - 换根DP
第四章 数据结构
4.1 并查集
并查集处理"集合合并 + 是否同集合"两类操作,find 路径压缩是灵魂。原文的入门提示:“find 函数可能有点难理解,自己尝试画下图随便理解好吧”:
int find(int x) {
    if (p[x] != x) p[x] = find(p[x]);   ///如果 x 不是根,向上递归查到根为止
    return p[x];
}往上叠加信息就是带权并查集。食物链(P2024)是代表:d[x] 起初存的是 x 到父节点的距离,路径压缩递归之后变成 x 到根的距离(原文:“因为要用到 p[x],所以先储存”)——A、B 同类当且仅当 (d[a]-d[b])%3 == 0,A 吃 B 则 %3 == 1。同类关系的题还有 A Bugs(奇偶距离判同性异性)、关押罪犯 P1525(“敌人的敌人是朋友”——按冲突值从大到小排序,x 的敌对标记 vis[x] 首次出现先记着,第二次出现就把两批敌人合并,直到某条冲突边两端已在同一集合,该边权就是答案)。
带深度的版本(P1196 银河英雄传说):合并时 p[u]=v, dep[u]=sz[v], sz[v]+=sz[u],find 里 dep[x] += dep[p[x]] 自底向上累加,两舰船间隔就是 abs(dep[a]-dep[b])-1。P1621 则是并查集 + 筛法:对每个 $\ge k$ 的质数,把 $[n,m]$ 内它的倍数全部合并,最后数根。
源笔记:并查集
4.2 单调队列
单调队列维护"队列内元素单调,答案在队首”。滑动窗口(P1886)的两步维护——队头出窗、队尾删无用——之后所有变体(求 m 区间最小值 P1440"只需要在单调区间进行变换之前输出上一步的状态即可”、画展 P1638、二维子矩阵最值"先对每行滑动一遍,再对列滑动一遍”)都是这两步的排列组合:
if (hh <= tt && i - k + 1 > q[hh]) hh++;      ///队头超出窗口
while (hh <= tt && a[q[tt]] >= a[i]) tt--;    ///队尾比新元素大(小)的都没用
q[++tt] = i;
if (i >= k - 1) cout << a[q[hh]] << " ";源笔记:结构
4.3 ST 表与静态区间最值
ST 表用倍增预处理静态最值。笔记里的预处理讲解(含边界推导)原文照录:“ST 表是利用倍增思想……$f[i][j]$ 指的是序列第 i 项向后 $2^j$ 个元素所包含区间的最大值。转移可以直接将两个小区间的答案合并:
$$f[i][j] = \max(f[i][j-1],\ f[i+2^{j-1}][j-1])$$这个式子告诉我们 ST 表类似于区间 DP,由两个小区间合并上来,所以应该先枚举区间长度(即 j),再枚举 i。边界上:当 j 确定时,i 的范围受限在 $[1, n-2^j+1]$;j 应满足 $2^j \le n \Leftrightarrow j \le \lfloor\log_2 n\rfloor$。”
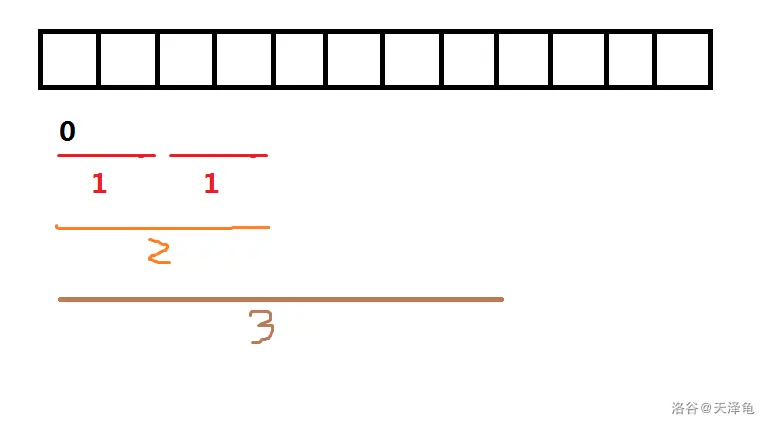
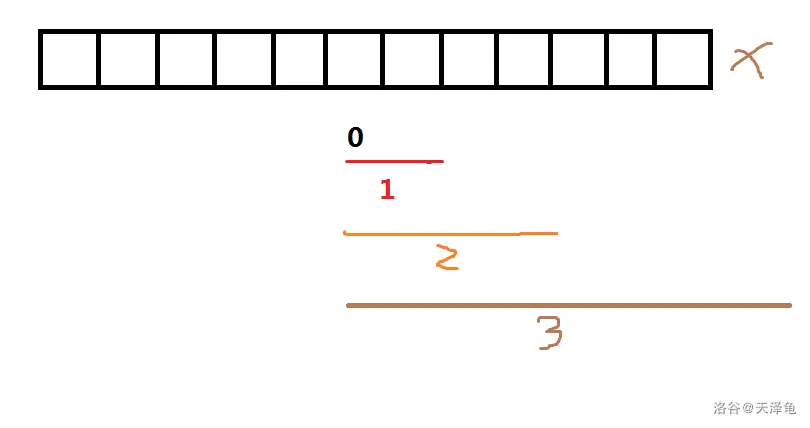
查询用两段拼合(重叠没关系,max 可重复计入):
int pos = lg[y - x + 1];
cout << max(f[x][pos], f[y - (1 << pos) + 1][pos]) << endl;
进阶玩法:P7333 把环上"离 i 最近的 ≥b 的距离"做成 ST 表 + 二分——破环为链要开三倍空间(原文:“二分的时候会出现 i-mid 越界,所以开三倍空间,在中间进行二分”),每次 check 用 ST 表查 $[i-x, i-1]$ 和 $[i+1, i+x]$ 两段最大值。
源笔记:静态区间(一维和二维)最值问题
4.4 树状数组
本质(原文):“利用 lowbit 将区间划分为以二进制结尾长度的小区间……树状数组的本质就是前缀和 + 可修改,也就是说树状数组就是更快一点的前缀和,但功能要多,可维护的种类更广泛。”
int lowbit(int x) { return x & -x; }
void add(int x, int c) { for (int i = x; i <= n; i += lowbit(i)) tr[i] += c; }
int sum(int x) { int op = 0; for (int i = x; i >= 1; i -= lowbit(i)) op += tr[i]; return op; }
四道应用,一层比一层歪:
- 楼兰图腾:正反两遍扫,
g[i]= 左边比 $a_i$ 大的个数、low[i]= 左边比它小的个数,答案 $\sum g_i \cdot (\text{右边比它大的})$ 与 $\sum low_i \cdot (\text{右边比它小的})$; - 单点查 + 区间加:树状数组维护差分,
C l r d就是add(l,d), add(r+1,-d),Q x输出sum(x); - 区间加 + 区间和:维护两个树状数组 $tr1$(差分)和 $tr2$($i \cdot d_i$),前缀和公式 $pre(x) = \sum tr1(x)\cdot(x+1) - \sum tr2(x)$;
- 谜一样的牛:从后往前确定每头牛的排名——剩下能站的位置里第 $a_i+1$ 小的,树状数组上二分第 k 个 1 的位置,确定后
add(r,-1)抹掉。
源笔记:树状数组
4.5 线段树
原文自己说"关于线段树的相关定义以及证明过段时间再补”——这里替他补上:线段树把 $[1,n]$ 递归二分,每个节点管一段区间,用一维数组按完全二叉树方式存储(节点 u 的左右儿子是 u<<1 和 u<<1|1,开 4N 空间)。单点修改与查询沿树走一条链,$O(\log n)$;任何 $[l,r]$ 查询最多分解成 $2\log n$ 个节点。它的通用骨架是三件套:pushup(子节点信息合并到父)、build、modify/query。
伪线段树(单点修改 + 区间查询)——P1198 最大数,模板即上面三件套的最小形态。区间最大子段和则是"维护什么"的进阶示范:每个节点存 区间和、前缀最大、后缀最大、区间最大子段和 四个值,合并时(原文代码注释)w.all = max(l.all, r.all, l.rmax + r.lmax)——跨中点的子段 = 左边的后缀 + 右边的前缀。区间 GCD 用了恒等式 $\gcd(a,b,c)=\gcd(a, b-a, c-b)$:差分建树把区间修改变单点修改,查询时 $\gcd(\text{左段和}, \text{右段 gcd})$,原文还给了证明思路。
区间修改 + 懒标记:要改一整段时只在父节点记账,查询时再向下结算——原文:“我们可以做个标记,只修改父节点,要查询子节点的时候直接向下更新标记”:
void pushdown(int u) {
    auto &root = tr[u], &left = tr[u<<1], &right = tr[u<<1|1];
    left.sum += (left.r - left.l + 1) * root.lazy, left.lazy += root.lazy;
    right.sum += (right.r - right.l + 1) * root.lazy, right.lazy += root.lazy;
    root.lazy = 0;
}
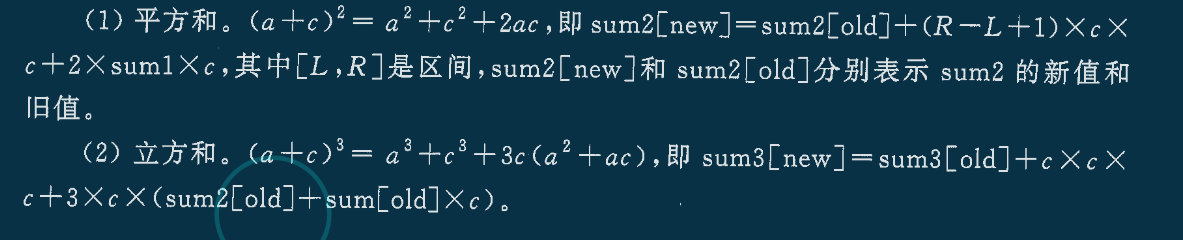
区间乘 + 区间加(维护序列 P3373):两个懒标记同时存在时要规定运算顺序(先乘后加),val() 把"乘 mul 再加 add"合成一步下传。区间异或是按位拆分的思想:叶子把值拆成 21 个二进制位,should[i] 记该位为 1 的个数,异或 x 时对该位打取反标记——取反后该位 1 的个数 = 区间长度 − 现有个数。多标记混合(HDU4578 区间加/乘/赋值 + 查和、平方和、立方和):用 3 个 tag,原文提示两个细节——“要倒序更新,类似背包,上一个更改的值会影响下一个的值”,以及 pushdown 顺序不可变(赋值 → 乘 → 加):
区间最值操作(吉司机线段树):对区间做 $a_i = \min(a_i, x)$,每个节点额外维护 最大值 mx、次大值 se、最大值个数 num、区间和 sum——$x \ge mx$ 不动;$se \le x < mx$ 只把最大值改成 x,sum -= num * (mx - x);$x < se$ 递归两边。原文注明"这么做的复杂度是均摊 log,先不做证明了,后面补”,例题是最假女选手(同时取 min/max/加,代码完整保留在原文里)。
主席树(可持久化线段树):每次单点修改只经过 $\log n$ 个节点,那就只新建这些节点,其余复用旧版本——原文:“形式化地就是 tr[new] = tr[old],然后修改左儿子即可,我们每次记录不同的版本,每个版本的入口就是根节点”:
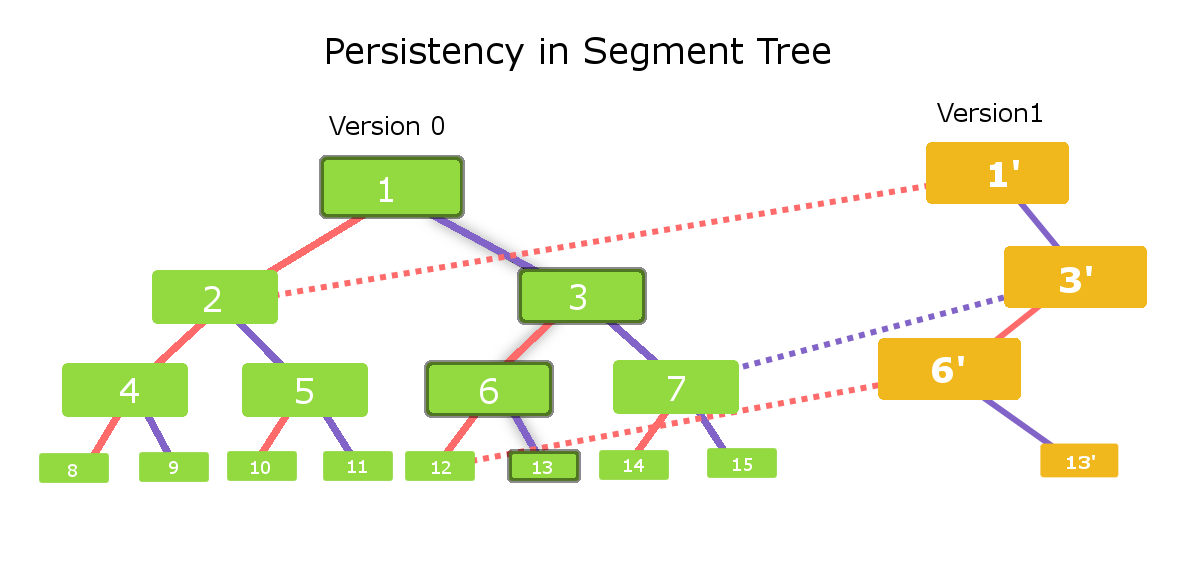
模板(可持久化数组)+ 应用(ABC253F:操作一区间加、操作二把某行重置——用"当前版本减去上次重置版本"的主席树差分抵消中间的操作一)都在原文里。
4.6 平衡树(FHQ Treap)
为什么需要平衡树(原文):“二叉搜索树中,如果给出的数据是一条链的话,那么每次查询都是 O(n) 级别,所以需要创建平衡树,来达到 logn 级别。“FHQ treap 只有两个操作:split(按值或按排名把树拆成 ≤v 和 >v 两棵)和 merge(按随机 key 的大根堆性质合并)。原文解释了为什么随机 key 有效:“mt19937 随机数,我们将树尽量分成大根堆的形式,由于正态分布的原因,创建出来的树可以压到 log 的高度。”
void split(int u, int v, int &x, int &y) {
    if (!u) return x = y = 0, void();
    if (tr[u].val > v) y = u, split(tr[u].l, v, x, tr[u].l);  // 若节点大于查询值,向左分裂
    else x = u, split(tr[u].r, v, tr[u].r, y);
    pushup(u);
}
int merge(int x, int y) {
    if (!x || !y) return x + y;
    if (tr[x].key > tr[y].key) { tr[x].r = merge(tr[x].r, y); pushup(x); return x; }
    else                       { tr[y].l = merge(x, tr[y].l); pushup(y); return y; }
}删除操作的分两半套路(原文注释):“先根据 x 分成两半,再从 ≤x 的树上继续分成 ≤x−1 和 >x−1,后者的根一定是 =x,直接合并其左右子树即可——怎么分的树怎么合。“插入/查排名/查第 k 小/前驱后继全是 split+merge 的组合。区间反转(文艺平衡树)则按排名分裂,对中段打懒标记 tr[t2].tag ^= 1,输出前 dfs 一遍 pushdown。
应用两则:P4309 用按排名分裂的平衡树维护"插入位置的 LIS”——新插入值的答案 = 前面树里维护的 dp 最大值 +1;原文详细辨析了为什么取的是节点 val 而非 dp[u](“因为我们的价值是以 pos 结尾的最长上升子序列的长度……分裂肯定不会把当前节点的父节点分裂掉”)。CF702F 则演示了按值分裂 + 对破坏单调性的 $[v, 2v)$ 段暴力重构(make 函数)。
源笔记:平衡树
4.7 分块
什么时候用分块(原文):“当你发现正常数据结构无法解决的时候(比如维度特别多,很不方便或者炸空间),或者复杂到要 3 个 log 以上才能解决时。主要还是看数据范围,分块的做法一般都是 $O(\sqrt n)$ 及以上。”
怎么分(原文):“定一个块长 B,整个序列分成 $\lfloor n/B \rfloor$ 块,末尾不完整的块直接暴力。一个区间会分解成两个不完整的块和中间一些完整的块——暴力不完整的块,完整的块打标记。”
教主的魔法(P2801):每块内部另存一份排序数组 e[],修改 = 散块暴力 + 整块打加法标记;查询 ≥c 的个数 = 散块逐个判断 + 整块二分 lower_bound(e+L[i], e+R[i]+1, c-tag[i])。另一道开方题则展示了块长的另一面:贡献递减使得每个修改的影响最多 6 个位置,所以"块长至少是 6,考虑保险设为 10 也一定不错”,同时倒推预处理分界点 $f_i$ 判定贡献是否封顶。
源笔记:分块–解决区间问题
4.8 莫队
原文的开场白:“以为自己一辈子接触不到的算法,本来以为很高深,没想到是优雅的暴力,太绝妙了。”
核心思想:暴力双指针,左端点按块排序、右端点在块内排序,让左右指针的移动次数达到平衡。复杂度推导原文照录:设块 i 内有 $x_i$ 个左端点,处理块 i 最坏 $O(x_i\sqrt n)$,指针跨块 $O(\sqrt n)$ 共 n 次,总复杂度 $O(n\sqrt n)$;右端点块内有序,最坏每块移动 n,共 $\sqrt n$ 块,也是 $O(n\sqrt n)$;加排序共 $O(n\sqrt n)$。
sort(q + 1, q + 1 + m, [](Query x, Query y) {
    return pos[x.l] == pos[y.l] ? x.r < y.r : pos[x.l] < pos[y.l];
});
int l = 1, r = 0;
for (int i = 1; i <= m; i++) {
    while (q[i].l < l) add(--l);
    while (q[i].r > r) add(++r);
    while (q[i].l > l) del(l++);
    while (q[i].r < r) del(r--);
    ans[q[i].k] = res;
}三个练习:小 B 的询问($\sum cnt^2$ 用 ans += 2*cnt-1 增量维护)、重复的数(cnt 与"出现次数的出现次数"双层统计)、压缩变换(上次出现位置到当前的区间数不同值,unordered_map 计数)。细节:排序比较器里的 (pos[l]&1)?r<w.r:r>w.r 是奇偶优化——奇数块右端点正序、偶数块倒序,能省一半右指针路程。
源笔记:莫队
4.9 二叉树与 STL 速查
二叉树的名词表(节点/根/叶子/深度/高度/前中后序)那篇笔记整理得很全,代码上是四类题:求深度(P4913,dfs(u, now) 取 max)、由前序+中序重建并输出后序(P1827——在中序里 find 根位置切分两半递归)、由后序+中序输出前序(P1030,根是后序末位,先输出再分)、以及 P1229 的漂亮结论——先序里 s[i]==ss[j] && s[i+1]==ss[j-1] 的位置就是"只有一个子节点"的节点,设 n 个则形态有 $2^n$ 种(原文给了证明:“如果先序是 AB,有两种可能……如果后序是 BA,排除兄弟可能,所以 B 就是 A 的唯一子节点”)。P3884 顺带练了 BFS 求 LCA + 树的深度/宽度。
STL 速查(set/multiset/string 三篇笔记):set 去重有序,lower_bound/upper_bound 返回迭代器(用 auto x=s.lower_bound(v); --x 取前驱,插入 ±极大值防越界);multiset 允许重复,erase(x) 删所有副本、erase(it) 只删迭代器指向的一个——P5076 直接用 multiset 硬过普通平衡树;string 的 find/substr/replace/insert/erase 系列(找不到返回 string::npos,即 4294967295)当时整理得非常细,原文直接可当手册用。
第五章 字符串
5.1 KMP 与 next 数组
KMP 模板两份(0/1 下标各一份,原文:“这两者本质上没有什么区别,只不过是位置不同”):
for (int i = 2, j = 0; i <= m; i++) {          // 求 next
    while (j && s2[i] != s2[j + 1]) j = ne[j];
    if (s2[i] == s2[j + 1]) j++;
    ne[i] = j;
}
for (int i = 1, j = 0; i <= n; i++) {          // 匹配
    while (j && s1[i] != s2[j + 1]) j = ne[j];
    if (s1[i] == s2[j + 1]) j++;
    if (j == m) cout << i - j + 1 << endl, j = ne[j];
}next 数组的两个经典性质,笔记里各配了一道题:
- 最短周期(无线传输 P4391):对 next 数组更深刻的理解——“如果周期性变化,那么 $n - ne[n]$ 就是最短周期。因为 next 数组不可能储存第一个周期出现的次数,当第一个周期出现后,之后的都是以周期出现”。答案一行:
cout << n - ne[n]; - 最小公共前后缀(POI2006 OKR-Periods of Words):对每个前缀把 next 一路缩到 0,缩到的位置就是最短公共前后缀,答案 $\sum i - j$。原文的优化:“这里要记忆化一下,枚举到 i 的时候可以直接跳到 j,减少枚举次数”——
if (ne[i]) ne[i] = j;直接把 next 改写成终态。
源笔记:字符串(KMP, Trie树, STL) · kmp的神奇之处 · POI2006 OKR-Periods of Words
5.2 KMP 的神奇之处
那篇"神奇之处"笔记展示了 KMP 的两次跑偏用法。其一:把"匹配"改成"大小关系匹配”——判断模式串在文本的某段区间上是否整体 ≤/≥,只需把相等判断换成 >=/<:“做法类似于上面的匹配模式,只是改了一下判断条件”,再套一层二分枚举模式串长度。核心转移:
while (j && a[i] < good[j + 1]) j = ne[j];   // 失配跳 next
if (a[i] >= good[j + 1]) j++;                // 匹配条件: 整体大于等于
if (j == 2 * u - 1) return true;
其二(ABC 题):$T = A + inv_B + inv_A + B$,由 $A + inv_B = inv_A + B$ 变形出"后半段匹配其前缀"的判据——把半段翻转后跑 KMP,沿 next 链枚举所有"后缀匹配前缀"的断点(for (int i = 2*n; i; i = ne[i-1]) if (i <= n) ok[i]++;),正反各做一遍后 ok[i] == 2 的下标就是分割点。
源笔记:kmp的神奇之处
5.3 Trie 树
高效存储和查询字符串集合。26 叉静态数组写法,插入时"没有子节点就建一个”,结尾计数:
void Insert(char str[]) {
    int p = 0;
    for (int i = 0; str[i]; i++) {
        int u = str[i] - 'a';
        if (!son[p][u]) son[p][u] = ++idx;   ///没有储存节点就建一个
        p = son[p][u];
    }
    cnt[p]++;   ///这个字符串 +1
}
练习:错误的点名(Trie 判存在 + map 判重复,三种输出 OK/WRONG/REPEAT)、魔族密码(字符串前缀最长链——s[i].find(s[j])==0 即 j 是 i 的前缀,套 LIS)。最长前缀(P1470)给了两种做法:KMP 对每个模式串在主串上标出所有可结尾位置再 dp;或者 set 按长度分桶 + substr 逐长度试切——原文第二种注释:“规划的是 s 的状态,每次看当前子串减去某一子串之后是否在集合中出现”。
第六章 图论
6.1 最短路三件套与最小生成树
《图论》这篇置顶笔记是当时的最短路模板大全。堆优化 Dijkstra($O(m\log n)$,注释是原文的):
priority_queue<pii, vector<pii>, greater<pii>> que;
que.push({0, s});  // 这里的必须是{0,s}, 小根堆是对第一个的值进行排序, 我们要根据距离排序
while (!que.empty()) {
    auto now = que.top(); que.pop();
    int dis = now.first, head = now.second;
    if (vis[head]) continue; vis[head] = true;  // 不加的话时间复杂度会变高
    for (int i = h[head]; ~i; i = ne[i]) {
        int j = e[i];
        if (dist[j] > dis + w[i]) { dist[j] = dis + w[i]; que.push({dist[j], j}); }
    }
}技巧与变体,按当时的笔记顺序:
- 所有点到一个点(P1629 邮递员送信):正反各建一次图,“其实反着建图就可以了”,两遍 Dijkstra 求和;
- 最短路计数:BFS 框架里区分两种情况——
dist[v] > dist[u]+1时cnt[v] = cnt[u]重新计数,==时cnt[v] += cnt[u]累加。SPFA 版本同理,原文注释特别强调"要区分 > 和 == 的情况,不能只讨论 >"; - Bellman-Ford:限制经过边数 ≤ k 的场景,每轮用
backup(上一轮的 dist 快照)松弛,防止本轮更新串味; - SPFA 判负环:
cnt[v]记最短路边数,cnt[v] >= n即有负环(原文:“如果当前路的边数已经大于 n 了,那很明显存在负环”);起点可能到不了负环时把所有点先入队; - Floyd:$O(n^3)$ 多询问。三个应用:明明的交通计划(预处理全源最短路后按站序累加)、B3611 连通性传递——转移改成
d[j][k] |= d[j][i] && d[i][k](原文对 min 的解释:“如果这两者有一个为 0,说明 j 和 k 之间没有中转站”)、Cow Contest(g[i][j] < inf即 i 能到 j,双向计数后num[i] >= n-1者排名确定)、灾后重建(按时间顺序把Repair站逐个加入,本质是"理解 floyd 的本质,进行实时更新"); - 分层图(免费飞 k 次):把图复制 k 层,层内边权不变、层间"免费边"权 0。原文:“分层图难在建图”,另外终点要全部 0 权相连——“有可能答案不需要非要用完 k 次免费次数”;
- 差分约束:笔记里整段理论注释原文照录——“先将每个不等式 $x_i \le x_j + c_k$ 转化成一条从 $x_j$ 走到 $x_i$ 长度为 $c_k$ 的边;找一个超级源点 0 使得该源点一定可以遍历到所有边;从源点求一遍单源最短路。如果存在负环,则原不等式组一定无解;如果没有负环,则 dist[i] 就是原不等式组的一个可行解。如果求的是最小值,则应该求最长路;如果求的是最大值,则应该求最短路。“应用题糖果(P3275)五种关系逐一转边,注意从 0 出发判环是
cnt >= n+1,“有时候用栈版的 SPFA 会比队列快”。
最小生成树:朴素 Prim(“把所有距离初始化为正无穷,每循环一次寻找距离集合最近的点并更新”)和 Kruskal(“将所有的边按权重快速排序,枚举每条边,如果 a、b 不连通就加到集合去”)都给了模板。三个应用各有巧思:买礼物(自己送自己 = 从 0 号点连边 m,转成 MST)、口袋的天空(n 个点缩成 k 个连通块 = 保留 n-k 条边,跑到 cnt >= n-k 提前停)、营救(“正难则反”——删边最大化代价 = 从大到小加边,注意两个敌人节点之间不能修桥,正常节点连上敌人也会变成敌人,“如果不标记的话会通过间接节点到达,达不到孤立的效果”)。
6.2 LCA 三种求法
倍增(预处理 $O(n\log n)$,查询 $O(\log n)$)——原文的三步注释:“fa[i,j] 表示从 i 向上走 $2^j$ 步到的节点。哨兵:如果会跳过根节点,则 fa[i,j]=0,depth[0]=0。步骤:[1] 先将两个点跳到同一层;[2] 让两个点同时往上跳,一直跳到它们的最近公共祖先的下一层。”
int lca(int a, int b) {
    if (depth[a] < depth[b]) swap(a, b);
    for (int k = 15; k >= 0; k--)
        if (depth[fa[a][k]] >= depth[b]) a = fa[a][k];   // 先跳到同一层
    if (a == b) return a;
    for (int k = 15; k >= 0; k--)
        if (fa[a][k] != fa[b][k]) a = fa[a][k], b = fa[b][k];
    return fa[a][0];
}
Tarjan 离线($O(n+m)$)——原文的分类注释:“在深度优先遍历时,将所有点分成三大类:[1] 已经遍历过且回溯过的点;[2] 正在搜索的分支;[3] 还未搜索到的点。“查询 (u,v) 在回溯到 u 时若 v 已属于第 [1] 类,LCA 就是 find(v),两点距离 dist[u]+dist[v]-2*dist[anc]。
树剖求 LCA:两条重链链头不同时,链头深的往上跳;同链时深度浅的即 LCA——三行核心(见 6.7)。
源笔记:图论
6.3 拓扑排序
拓扑排序 = 对 DAG 逐层剥叶子。基础模板(家谱树)+ 三类应用:奖金(BFS 里 top[j] = top[now]+1 逐层发钱,原文还附了一个"差分约束"的替代做法——超级源点跑最长路);车站分级(P1983,把每趟车经过的停靠站向区间内所有非停靠站连边,级别 = 最长链 +1,用 mp[][] 防重边——“mp 数组要开小,防止 mle”);Nastya and Potions(拓扑序上 DP,原料成本 min 自己直接买——原文提醒"一定要注意怎么建边”,原料指向成品)。
queue<int> que;
for (int i = 1; i <= n; i++) if (p[i] == 0) que.push(i);
while (!que.empty()) {
    int now = que.front(); que.pop();
    for (int i = h[now]; ~i; i = ne[i])
        if (--p[e[i]] == 0) que.push(e[i]);
}源笔记:图论
6.4 Tarjan 缩点与无向图连通
强连通分量(原文的理论注释):“对每个点定义两个时间戳——dfn[u] 表示遍历到 u 的时间戳,low[u] 表示从 u 开始走所能遍历到的最小时间戳。u 是其所在强连通分量的最高点等价于 dfn[u] == low[u]。“搜到最低点时栈里的整段就是一个 SCC,且编号天然构成逆拓扑序。
void tarjan(int u) {
    dfn[u] = low[u] = ++times;
    _stack[++top] = u, vis[u] = true;
    for (int i = h[u]; ~i; i = ne[i]) {
        int j = e[i];
        if (!dfn[j]) tarjan(j), low[u] = min(low[u], low[j]);
        else if (vis[j]) low[u] = min(low[u], dfn[j]);
    }
    if (dfn[u] == low[u]) {
        int y; ++scc_num;
        do { y = _stack[top--]; vis[y] = false, id[y] = scc_num; } while (y != u);
    }
}三道应用:受欢迎的牛(缩点后统计出度,出度为 0 的 SCC 若唯一则其大小即答案,多个输出 0);缩点+最长路(原文的注意点:“一定要重新再建一个链表,而且之前的那个链表不能重置"“这里不是 id[j],而是 id[i],因为我们要求的是第 i 个点与其所有邻点”——SCC 权值用新数组 money 记,缩完拓扑跑 dp);最大半连通子图(缩点后重建图要去重边,hash = x*M+y 配 unordered_set,注意"缩点之后已经成为逆着的拓扑序,直接倒着推一遍就可以”,同时计数方案数)。
无向图的桥与边双连通(P2860 Redundant Paths):核心是成对变换——i^1 是反向边,判父边用 i != (from^1);dfn[u] < low[j] 时边 i 是桥(原文注释:“如果从节点 j 能够到达更深的地方”)。缩边双后统计度数为 1 的叶子数 res,答案 (res+1)/2——原文:“无向图变成双连通分量所需要建的桥的数量为 res/2 向上取整。“求桥本身(炸铁路 P1656)同理,输出排序后的桥两端点。
源笔记:图论
6.5 树的重心
定义(原文):“找到一个点,其所有的子树中最大的子树节点数最少,那么这个点就是这棵树的重心,删去重心后生成的多棵树尽可能平衡。“一遍 dfs 统计每个子树大小,$f_u = \max(\max_{son} size_{son},\ n - size_u - 1)$,取 f 最小的点。会议(P1395)里求出重心后重置再 dfs 一遍累加距离即可(g[u] += g[j]+1 正是子树内距离和)——第六章 3.8 的换根 DP 也提到了重心替代做法。
源笔记:树的重心
6.6 基环树
这篇是少有的成体系教程,定义部分原文照录:“首先,严格地讲,基环树不是树,它是一张有 n 个节点、n 条边的图。“有 n 个节点 n 条边的无向连通图 = 树上加了一条边,恰好一个环:
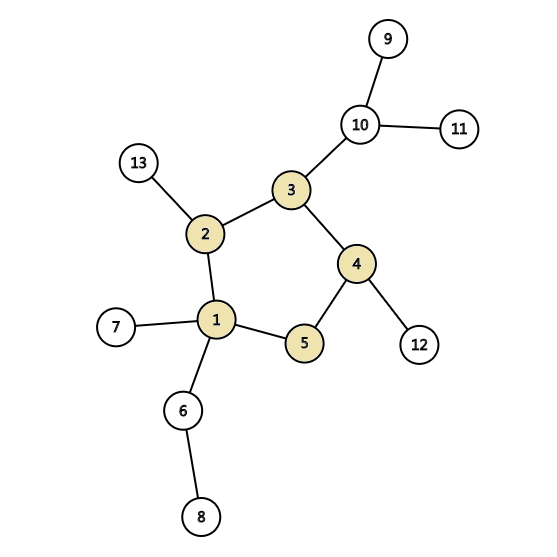
有向图上分两种:内向树——每个节点以自己为起点的边只有一条:
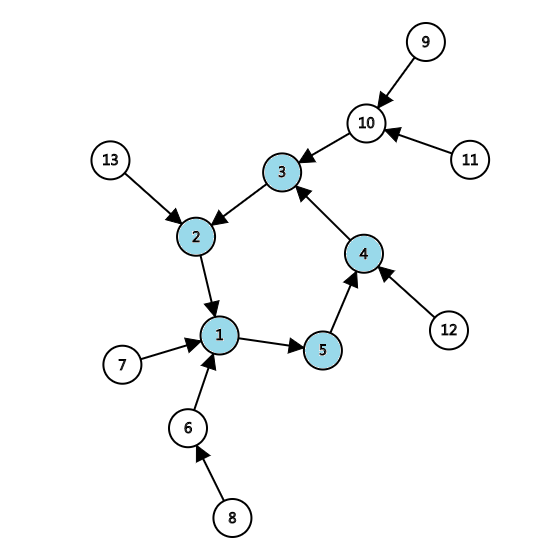
外向树——每个节点以自己为终点的边只有一条:
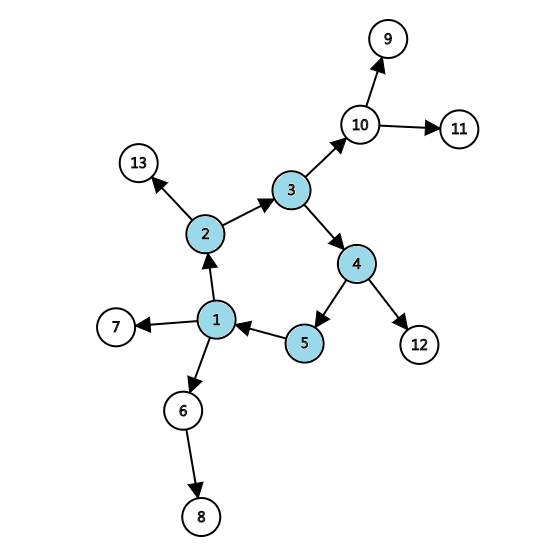
一般处理思路(原文):“不要害怕,我们也是有一般方法的:找到唯一的环;对环之外的部分按照若干棵树处理;考虑与环一起计算。“找环用 DFS 染色(原文的口胡做法,很形象):“从任意一点开始搜索;每次拓展到的点涂为灰色,回溯的点涂为黑色;重复直到通过一条未经过的边拓展到一个灰色节点;将拓展到的灰色节点涂为红色,函数返回 true;将回溯经过的节点涂为橙色;重复直到回溯到红色节点,算法结束。“彩色动画演示:
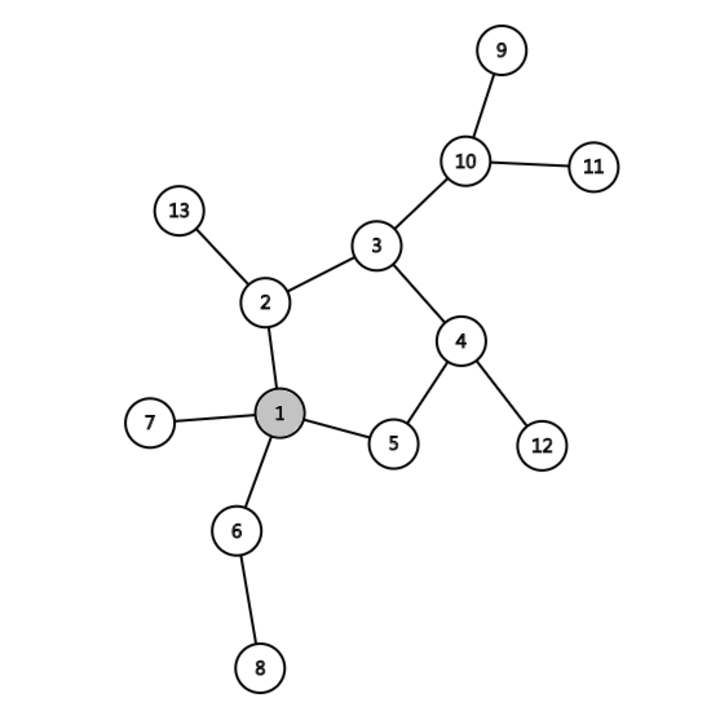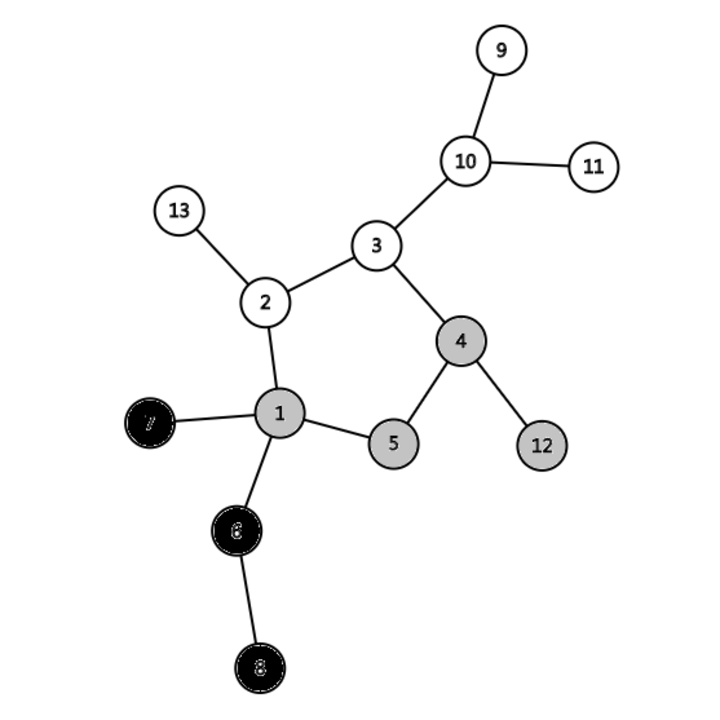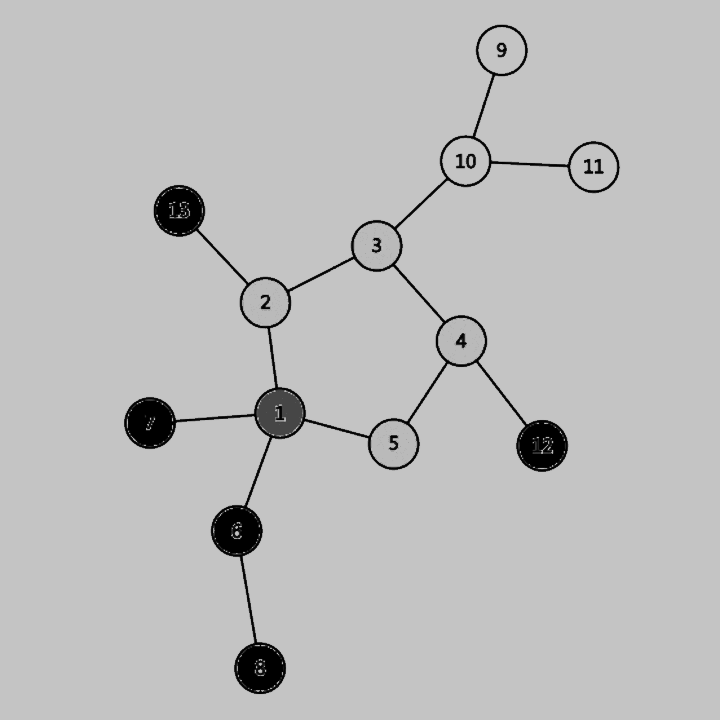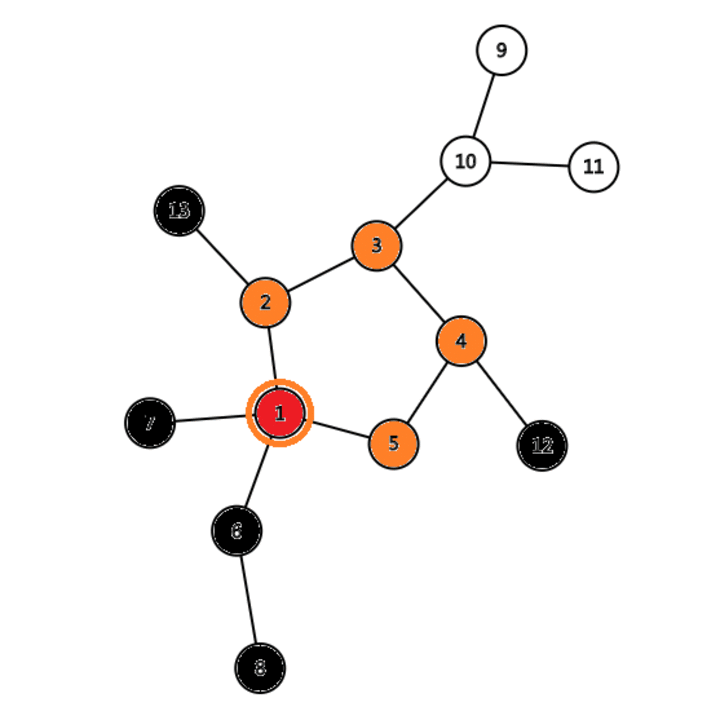
基环树森林的标记技巧(原文列了三种:环上节点递归前用另一个 DFS 遍历标记;处理去掉环的子树时用 tag2 区分新基环树;建图时用并查集),以及一个实现细节:“判断一个点是否可以被拓展的条件是拓展所经过的边是否已被经过,由于无向图建边是两个方向各建一条,标记时需要成对变换,将这两条边同时标记。“剩下的操作:“一般是一个树形 DP(子树不考虑环)加一个线性 DP + 单调队列优化(在环上,断环为链,复制一遍)。”
到 2024 年再回看时补的两个函数图应用:Reachability in Functional Graph(n 点 n 边的基环树内向森林——每个点的答案 = 到环的距离 + 环的大小,先逐连通块找环记 dp,再记忆化搜索);Permute K times(同样转成内向基环树后是k 级祖先问题,倍增 $g(j+1,i) = g(j, g(j,i))$,二进制拆分跳跃,$O(n\log k)$)。
源笔记:基环树
6.7 树链剖分
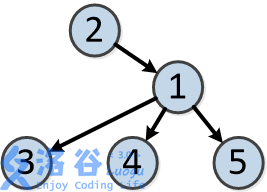
“今天刚重新学习了一下,还是比较神奇的,没想到一个树形结构能有这么多种神奇的操作。"——原文开篇。核心概念(原文的定义 + 配图):重儿子(子树大小最大的儿子,显然只有一个)、轻儿子、重边(重儿子之间的链)、重链(连续重边)、链头(重链上深度最浅的点):
复杂度证明原文照录:“从叶子节点出发考虑二叉树,对于一条轻边,其形成的子树大小必然小于 n/2。从一条重链跳到另一条重链势必要经过一条轻边,那么其子树大小必然会缩小到小于 1/2,这样最多经过 logn 条轻边即可到达根节点。“也就是说任意点到根最多经过 $\log n$ 条重链。
LCA 版三行核心:
int lca(int a, int b) {
    while (top[a] != top[b]) {                        // 链头不同,深的往上跳
        if (dep[top[a]] > dep[top[b]]) a = fa[top[a]];
        else b = fa[top[b]];
    }
    return dep[a] > dep[b] ? b : a;                   // 同链,浅的即 LCA
}重链剖分模板的精髓在"重链内部 dfs 序连续”(原文:“我们在 dfs2 函数中先搜索重儿子,所以重链具备 dfs 的通有性质……每条重链内部是有序的,每棵子树上的所有节点编号同样是有序的”),于是把树上问题扔给线段树:
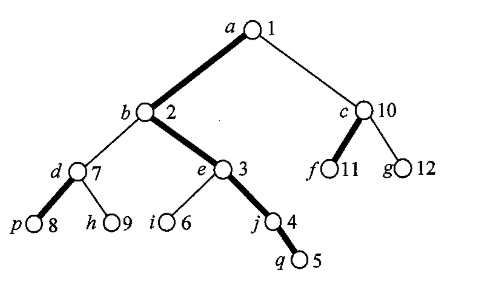
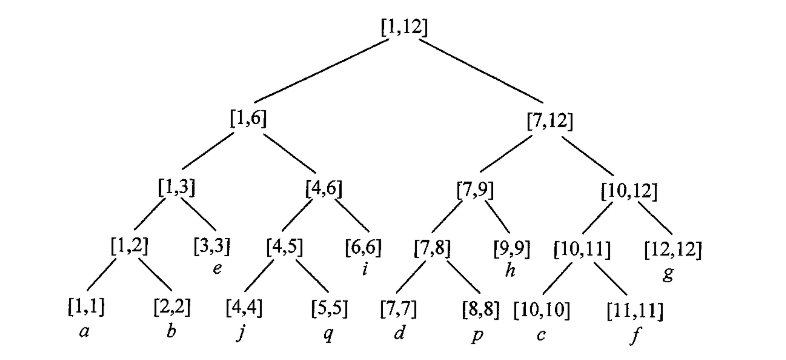
四个操作(原文思路):修改/查询 x 到 y——类似 LCA 的跳链,“当 (a,b) 不处于同一条重链时,直接区间修改深度深的那条重链,然后跳过轻边,直到处于同一条重链,再修改链上小区间”;修改/查询 x 的子树——子树 dfs 序连续,直接 modify(1, id[x], id[x]+sz[x]-1, z)。复杂度 $O(m\log^2 n)$。完整实现(线段树 + dfs1/dfs2 + update/get)原文一应俱全。
源笔记:树链剖分
6.8 点分治
介绍(原文):“点分治,作为一种统计带权树简单路径长度的暴力分治算法,其分治方法非常的巧妙,可以将暴力的 $O(n^2)$ 优化到 $O(n\log n)$。“模板问题:统计树上路径长度 ≤ k 的点对数(POJ1741)。
分治的划分(原文):“考虑树上的一个点 t,把问题分为两大类:经过点 t 的路径,和不经过该点的路径。不经过 t 的路径在删去 t 之后的若干棵子树里,可以递归求出。“经过 t 的路径:一遍 dfs 求所有点到 t 的距离,排序后双指针统计:
但会有不合法路径混进来(原文的例子):“当前的 k=7,从根 R 到 X、Y 的距离均为 3,这条路径已被纳入合法路径,实则它是 R→X→R→Y,实际长度 9——它不是简单路径。从整体上看,同一子树内两个节点组成的路径均不合法。”
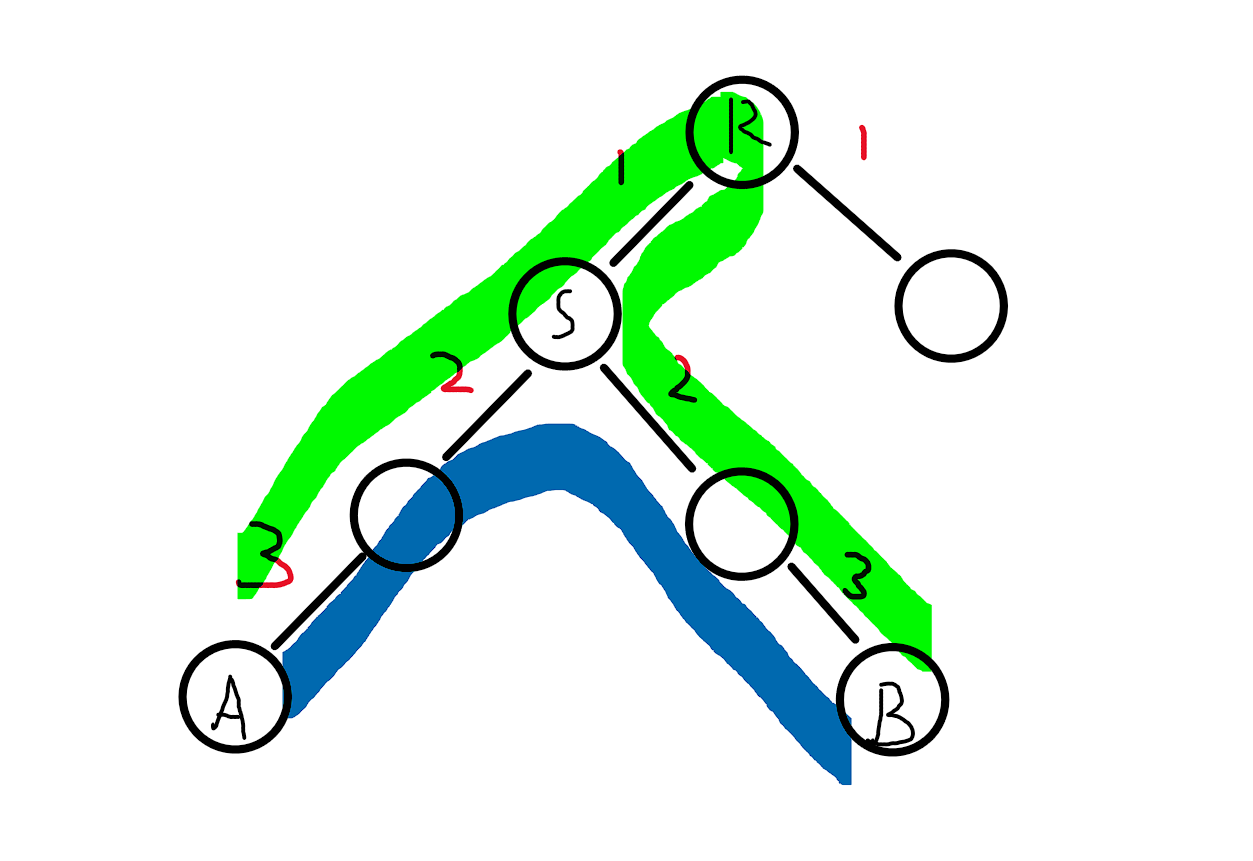
容斥的技巧(原文):“我们直接计算以子节点为根的子树,把原来的 k 变成 $k + w_{R \to S}$,就可以把这些不合法的路径通通去除。”
最后是"最重要的地方出来了”——重心:“每次都用重心做根节点,分裂的子树大小不会超过 n/2,我们只需要 logn 层即可完成递归。递归复杂度 logn,每个点的方案复杂度 nlogn,总复杂度 $O(n\log^2 n)$。“求重心就是 6.5 的 f 数组取最小。
void dfs(int u) {
    res += dfs3(u, 0);                 // 统计经过 u 的路径(含重复)
    vis[u] = true;
    for (auto [x, w] : g[u]) {
        if (!vis[x]) {
            res -= dfs3(x, w);         // 减去同子树内的不合法路径
            now = 0, Tsize = sz[x], dfs1(x, 0);   // 找重心
            dfs(now);                  // 递归
        }
    }
}两道变体:点分治 1(问距离恰为 k 的点对是否存在——原文:“用二分更为方便,注意本题最好不要每次询问都跑一遍,因为算法常数较大,这里直接统计即可”);ABC359G(同颜色点对距离和——遍历子树前维护全局 sum[色](同色点到根的距离和)和 cnt[色],进入节点 v 时 res += sum[A_v] + dist_v * cnt[A_v],子树换色时回滚)。
源笔记:点分治详解(附图附例题)
6.9 Kruskal 重构树、最短路径树与二分图
Kruskal 重构树(原文的定义):“与瓶颈树类似,Kruskal 重构树的特性是:任意两点之间的简单路径中的(最大或最小)边权值为其最近公共祖先。“建法:跑 Kruskal,每次合并两个集合时新建一个点权 = 边权的父节点,把两个集合的根挂上去。性质:重构树是二叉堆形的——从叶到根边权递增(最小生成树版);两点间瓶颈边权 = 它们的 LCA 点权。典型用法是"只经过边权 ≤ x 的边能到达哪些点”:找深度最浅的点权 ≤ x 的祖先,其子树即答案。原文里配了 8 张过程图,从第一次合并到建树完成逐步演示。
最短路径树 SPT:从源点跑一遍 Dijkstra,只保留满足 dist[v] == dist[u] + w 的树边——树上任意点到根的距离 = 原图最短路,于是"删一条边的影响"“在树上做 dp"类问题可以在 SPT 上做。
最小点覆盖(二分图,König 定理):二分图中 最大匹配数 = 最小点覆盖数。匈牙利算法增广路找匹配,覆盖集合从匹配出发构造。原文笔记里给出的是一组结论题的推导与模板。
DAG 最长路/最短路:拓扑序上 dp(dist[j] = max(dist[j], dist[i] + w),入度为 0 的入队),或者 Tarjan 缩点之后跑(见 6.4 缩点应用)。
源笔记:Kruskal重构树 · 最短路径树SPT · 最小点覆盖问题 · DAG求最长路/最短路方法 · 最大食物链计数
第七章 数学
7.1 素数与筛法
试除判素数 $O(\sqrt n)$(注意 i <= n/i 的写法防溢出)、埃氏筛 $O(n\log\log n)$、欧拉筛(线性筛)三连。欧拉筛的精髓是"每个合数只被最小质因数筛掉一次”:
for (int i = 2; i <= n; i++) {
    if (!vis[i]) prime[++res] = i;
    for (int j = 1; prime[j] <= n / i; j++) {
        vis[prime[j] * i] = true;
        if (!(i % prime[j])) break;   ///i 的最小质因数是 prime[j],再往后会被重复筛
    }
}线性筛还能顺便维护别的量——P8795 就用 p[i*prime[j]] = max(p[i], prime[j]) 记录每个数的最大质因数:正着推操作区间 $[m-p+1, m]$,“对于每个可能的数来说,我们取的素数一定要是最大的质因数,因为只有这样我们的最小值才会尽可能地小”。分解质因数则是试除到 $\sqrt n$ 后"如果 n>1 剩下的就是质因数”。
源笔记:(数论)素数,质数
7.2 约数与 GCD
试除求约数 $O(\sqrt n)$:$d$ 整除 $n$ 则 $n/d$ 也整除 $n$,成对收集(set 自动去重排序)。约数个数基于算术基本定理:$n = p_1^{k_1} \cdots p_m^{k_m}$ 则个数是 $\prod (k_i + 1)$。反过来"1-n 所有数的约数个数和"用筛法——原文的解释很清楚:“1 是所有数的约数,2 是所有 2 的倍数的约数……因为 a 是 b 的约数,b 就是 a 的倍数,那么 1 有 n 个倍数,2 有 n/2 个倍数,$1 + n/2 + n/3 + \dots = n\log n$"。GCD 就是欧几里得一行:return b ? gcd(b, a%b) : a;(依据:“a 和 b 的最大公约数等于 b 和 a%b 的最大公约数”)。
源笔记:(数论) 约数
7.3 数论分块
求 $\sum_{i=1}^n \lfloor n/i \rfloor$。这篇笔记的推导非常完整,从画反比例函数图像开始:
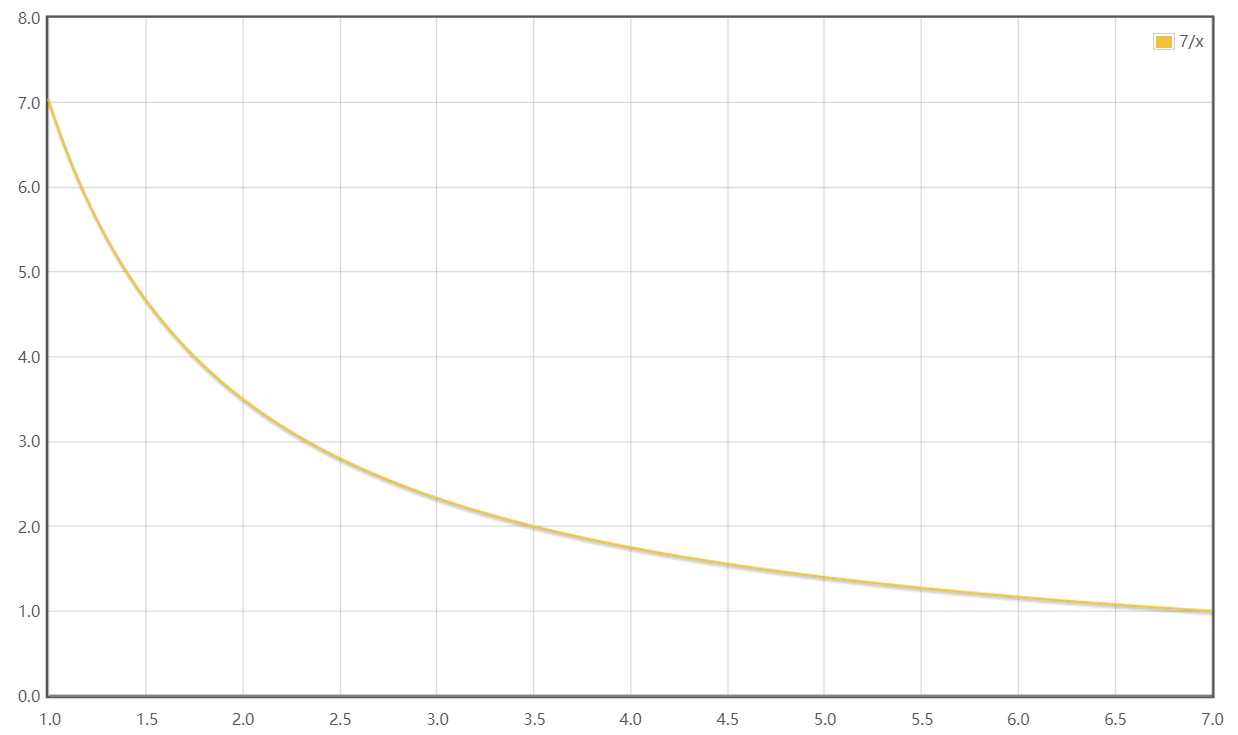
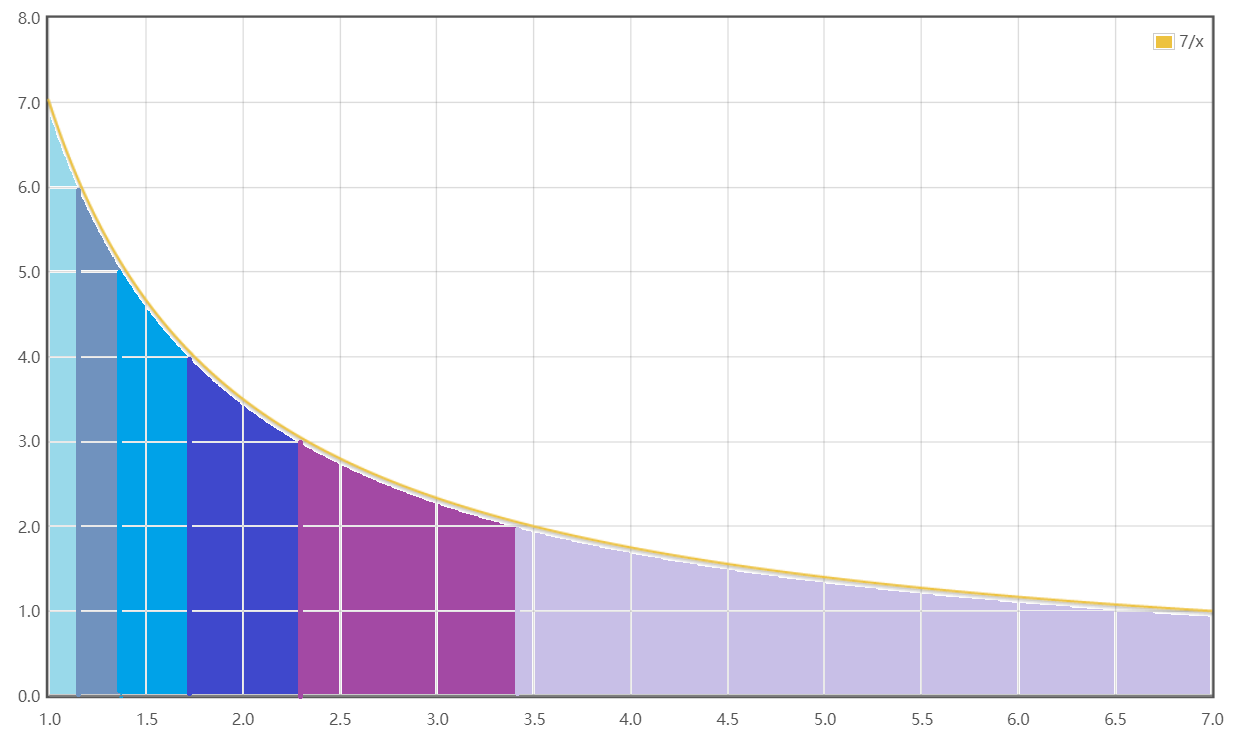
原文:“图像被分割为 7 个大块,但取值范围包含整数的只有 4 个。如果可以把这些包含整数的块取出来,一次性得出一个块的答案,把整块对答案的贡献加上即可。“核心结论是"对于整数 i,其所在块的右端点为 $\lfloor n / \lfloor n/i \rfloor \rfloor$",笔记里给了两种证明:代数法(利用 $\lfloor x \rfloor \le x$ 与保序性夹逼出 $\lfloor n/\lfloor n/\lfloor n/i\rfloor\rfloor\rfloor = \lfloor n/i\rfloor$);几何法——
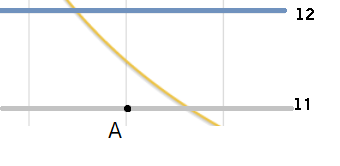
复杂度证明(原文):“当 $x \in [1, \lfloor\sqrt n\rfloor]$ 最多有 $\lfloor\sqrt n\rfloor$ 种取值;当 $x \in (\lfloor\sqrt n\rfloor, n]$ 时 $\lfloor n/x \rfloor$ 显然只能取到 $[1, \lfloor\sqrt n\rfloor)$,也最多 $\lfloor\sqrt n\rfloor$ 种。则至多 $2\lfloor\sqrt n\rfloor$ 种取值,复杂度 $O(\sqrt n)$。“模板一行:
for (int l = 1, r; l <= x; l = r + 1)
    r = x / (x / l), res += (r - l + 1) * (x / l);
应用:P3935(约数个数前缀和,$g(x) = \sum \lfloor x/i \rfloor$,差分 $g(r) - g(l-1)$)、因数平方和(分块 + 平方和公式,__int128 防炸)。
源笔记:数论分块,约数研究
7.4 裴蜀定理
内容与证明(原文):"$ax + by = c$ 成立的充要条件是 $\gcd(a,b) \mid c$。设 $s = \gcd(a,b)$,显然 $s \mid a$ 且 $s \mid b$,所以 $s \mid ax, s \mid by$——要使式子成立,必须满足 c 是 a 和 b 的公约数的倍数。“推广:“若两个数互素,那么他们可以组合成任何数。“模板题 P4549 的答案就是所有数的 gcd。
源笔记:(数论)裴蜀定理
7.5 扩展欧几里得与线性丢番图方程
exgcd 求 $ax + by = \gcd(a,b)$ 的一组特解:
int exgcd(int a, int b, int &x, int &y) {
    if (!b) { x = 1, y = 0; return a; }
    int d = exgcd(b, a % b, y, x);
    y -= a / b * x;
    return d;
}
《线性丢番图方程》把理论补全:$ax + by = c$ 有解的充要条件是 $d = \gcd(a,b) \mid c$,有解时无穷多,通解为 $x = x_0 + \frac{b}{d}n,\ y = y_0 - \frac{a}{d}n$。原文还给了把式子两边除以 gcd 的化简视角:“得到 $cx + dy = 1$,c 与 d 互素,通解为 $x = x_0 + dn$",配了两张推导图:
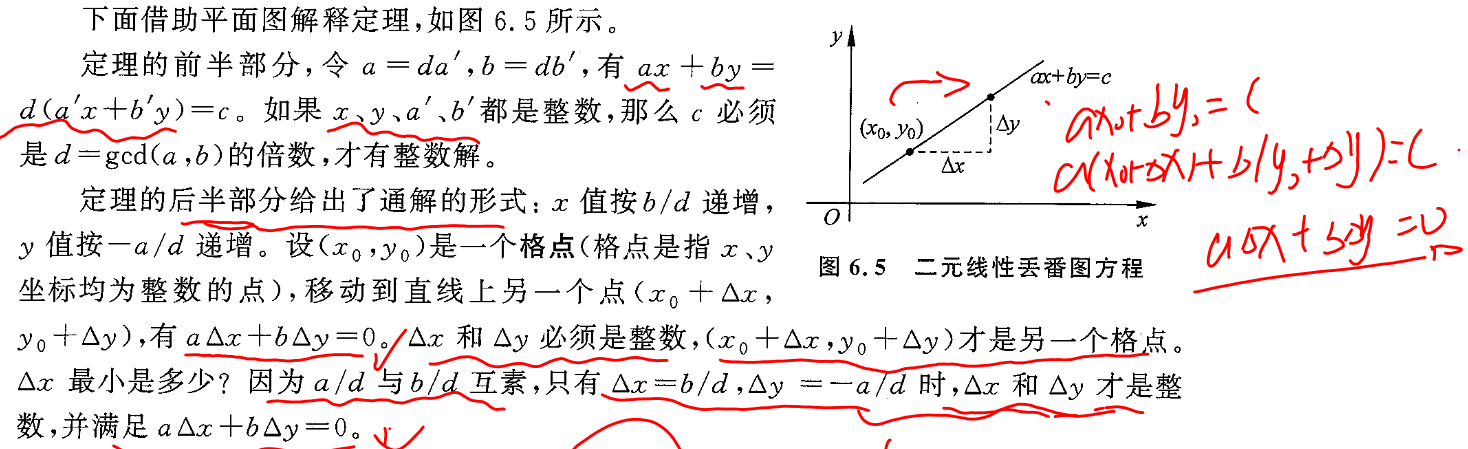
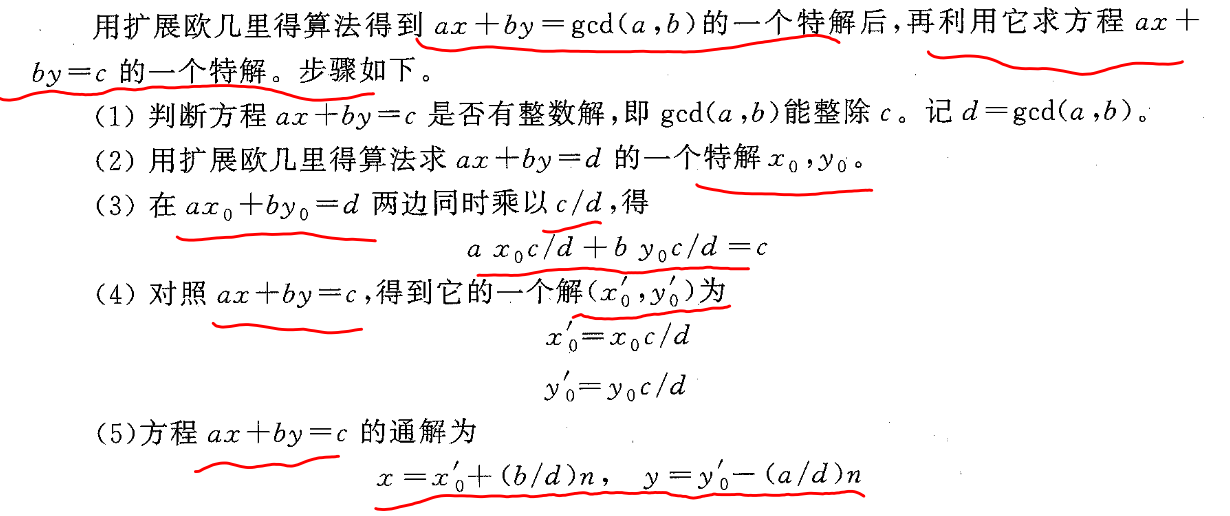
两道模板:青蛙的约会(相遇条件化成 $(n-m)t \equiv x-y \pmod L$,exgcd + 最小非负解 ((x*(c/d)) % (L/d) + L/d) % (L/d));P5656 二元一次不定方程(在通解上平移出 x 最小正解,再算正解个数、y 最大值等五个量)。
源笔记:扩展欧几里得 解二元一次方程组 · 线性丢番图方程
7.6 欧拉函数、欧拉定理与费马小定理
欧拉函数 $\varphi(n)$ = 1-n 中与 n 互质的数的个数。设 $n = p_1^{k_1} \cdots p_m^{k_m}$,则 $\varphi(n) = n \prod (1 - 1/p_i)$。证明原文给了容斥的四步口诀:“首先用 $n - n/p_1 - n/p_2 - \dots$;加上 $p_ip_j$ 的倍数,因为这当中有被重复减去的数,要加回去;加上 $p_ip_jp_k$ 的倍数……依次类推”:
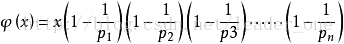
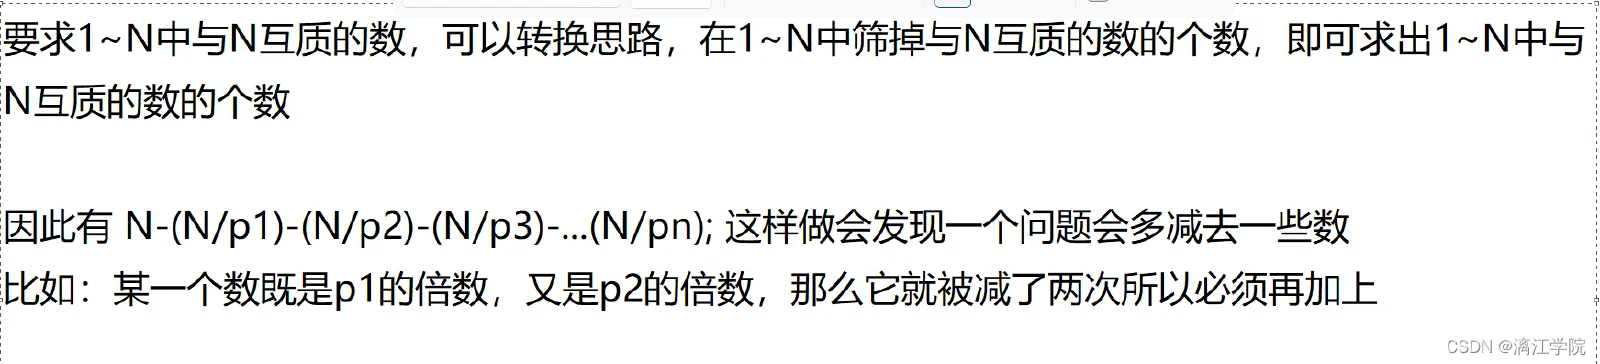
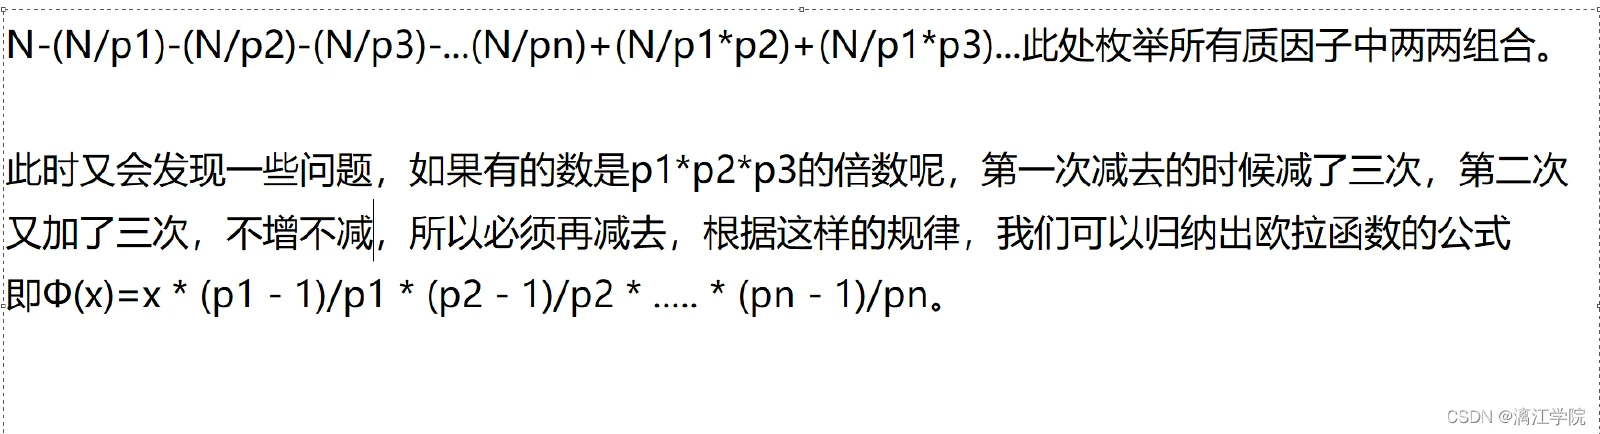
实现上先写朴素式 res = res / i * (i - 1)(原文注释:“和上面的公式一样,只是相除有可能因为浮点数影响判断”);批量求用欧拉筛顺手算——i % prime[j] == 0 时 $\varphi(ip) = \varphi(i) \cdot p$,否则 $\varphi(ip) = \varphi(i)\cdot(p-1)$。定理部分:欧拉定理 $a^{\varphi(n)} \equiv 1 \pmod n$(a 与 n 互质),费马小定理是 n 为质数时的特例 $a^{n-1} \equiv 1 \pmod n$——这正是 1.3/7.7 里"快速幂求逆元"的理论基础。
源笔记:欧拉函数,欧拉定理,费马定理
7.7 组合数与容斥原理
求组合数三档(原文的注释就标了适用范围):$O(n^2)$ 杨辉三角递推(n ≤ 2e3);预处理阶乘 + 费马小定理求逆元 $O(\log)$(n ≤ 1e5);Lucas 定理(a, b 大到 1e18、p 较小时,$C(a,b) = C(a\%p, b\%p) \cdot Lucas(a/p, b/p)$)。两个必备小件:线性递推逆元 inv[i] = p - (p/i) * inv[p%i] % p,以及倒推阶乘逆元 _fac[i] = _fac[i+1] * (i+1) % mod(只做一次快速幂)。
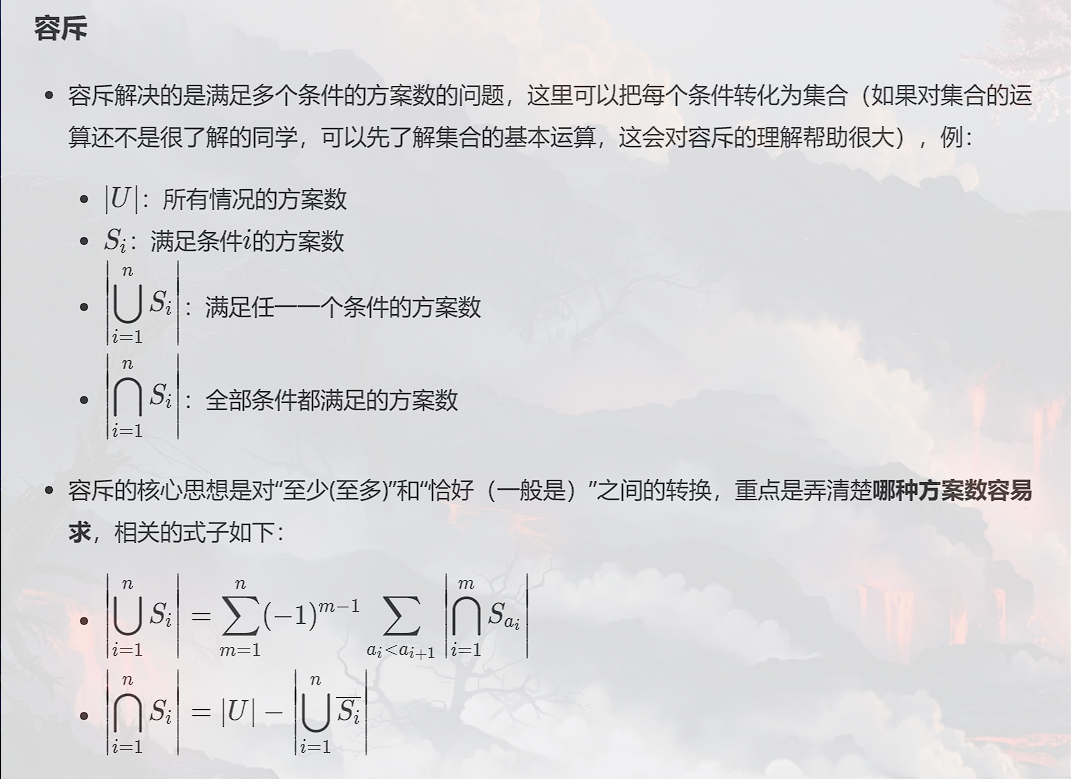
容斥原理的公式与核心思想(原文):“容斥的核心思想是对’至少(至多)‘和’恰好’之间的转换,通过交和并的运算来得到不同情况下的方案数。”
$$\left|\bigcup_{i=1}^{n} S_i\right| = \sum_{m=1}^{n} (-1)^{m-1} \sum_{i_1 < \dots < i_m} \left|\bigcap_{j=1}^{m} S_{i_j}\right|$$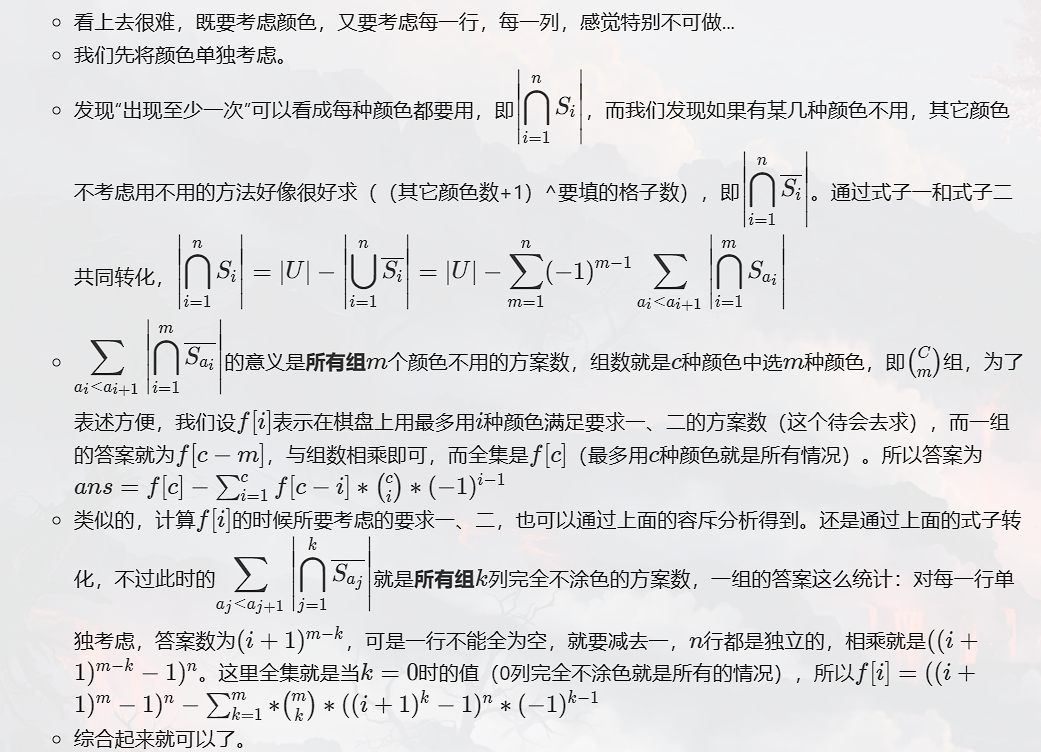
实现套路是二进制枚举子集($\text{cnt}$ 奇加偶减,t > n 及时 break)。两道应用:分特产(P5505——“假设有 i 个人得不到特产,n-i 个人分 $a_j$ 个特产,插板法得 $C(a_j+n-i-1, n-i-1)$,乘上选人的 $C(n,i)$,容斥去掉不合法状态”);棋盘染色(行、列、颜色三重容斥嵌套,先算"每行都合法"的 f,再对颜色容斥)。
7.8 线性基
解决"n 个数取任意个,异或值最大"这类问题。动机(原文):“假如最大的数二进制位数为 m 位,线性基可以把原来的 $2^n$ 的组合优化到 $2^m$……任意两个数异或之后不会比他们两者的最高二进制位还高,所以异或结果会在 $[0, 2^m-1]$ 这个区间内。“形象例子(原文):“A = [2,3,5,6,7] 的任意组合有 $2^n-1$ 种,但异或结果只有 [0..7] 共 8 种;线性基 P = [5,2,1] 有 7 种(线性基不能处理异或为 0 的情况)。注意,线性基不是唯一的。”
构造的两条原理(原文):特例是"A 中所有元素的二进制位数均不同,那 A 自身就是一个线性基”;一般情况对位数相同的两个数直接异或——$P = [a_1, a_1 \oplus a_2]$ 与原集合张成相同(原文给了组合枚举的证明)。
auto insert = [&](int x) -> void {
    for (int i = 61; i >= 1; i--) {
        if (x >> (i - 1)) {
            if (p[i] == 0) { p[i] = x; return; }
            else x ^= p[i];
        }
    }
    zero = true;   // 异或不出: 说明能凑出 0
};
int res = 0;
for (int i = 61; i >= 1; i--) res = max(res, res ^ p[i]);最大异或和的贪心正确性(原文):“我们从大到小开始,对于最大的,肯定不会存在一个其它的数可以到达最高位;对于次大的,若异或后对答案有益我们就异或——比它小的元素任意的组合都不会比它大。“最小异或和:“就一个值,不是 0 就是位数最小的那个数字。”
源笔记:线性基
7.9 高斯-约当消元
解 n 元一次方程组,判断无解/无穷多解/唯一解。原文的推导完整走过一遍 $2x-y+z=1$ 的例子:选最大主元(“避免精度误差”)、换行、把主元归一、其余行消零,最终系数矩阵变成对角阵直接读解。复杂度 $O(n^3)$。无解/无穷多解的判断(原文):“考虑一元一次方程 $ax=b$:无解是 $a=0,b\ne0$;无穷多解是 $a=b=0$;唯一解是 $a\ne0$。当发现某一列的主元为 0 时,因为主元是最大的,意味着这一列全是 0,要么无解,要么无穷多解。“具体判定用计数器 r(原文:“如果主元为 0,continue 到下一列但 r 不变;否则消元后 r←r+1。遍历完后若 r=n 唯一解;若 r<n,第 r+1~n 行系数全 0,右端也全 0 则无穷多解,否则无解”):
异或方程组是重要变体,原文总结了三条特征(照录):“在消除当前行其余元时,应逆序在这一行上异或上主元乘当前元;异或方程无法化简成行最简形式,消元之后是上三角样式;求解时应从最后一行向上,把所有非零元代入方程。“自由变量的处理:一个自由元带来开/关两种选择,答案乘 2。两道应用:Painter’s Problem(画家刷墙——n×n 砖建立 $a_{ij}$ 影响矩阵,初始颜色入常数列,异或消元后自由元判 inf)、开关问题(同样建模,res *= 2 统计方案数)。
源笔记:高斯 - 约当消元法
7.10 矩阵快速幂
作用(原文):“能够达到快速递推公式的作用。“矩阵乘法三重循环取模,快速幂把次数二进制拆位——和 1.3 的数字快速幂完全同构,只是单位元从 1 变成单位矩阵:
martix qpow(martix mp, int k) {
    martix res;
    for (int i = 1; i <= n; i++) res.x[i][i] = 1;   // 单位矩阵
    while (k) {
        if (k & 1) res = cacl(mp, res);
        k >>= 1, mp = cacl(mp, mp);
    }
    return res;
}
适用场景:状态转移是线性的(斐波那契、图的 k 步路径数——邻接矩阵的 k 次幂即走 k 步的方案数矩阵)。
源笔记:矩阵快速幂
7.11 博弈论
Nim 游戏的必胜策略,原文的控制权解释:“如果当前的选手具有控制权,那么当前选手是必赢的——他做出的这步选择后,之后的局面都在其预料之中。我们最终的局面一定是 0 0 0 0……其异或和为 0。定义异或和为 0 的局面为局面 0,其余为局面 1:若当前是局面 0,下一步一定会变成局面 1;若当前是局面 1,当前选手可以选择变成局面 0——掌握控制权,则胜出。故:一开始的局面为局面 0 那么后手赢,否则先手赢。“判定一行:全员异或,非零即先手必胜。
高僧斗法(蓝桥杯)是转化范例(原文):“转化为 nim 模型——两个和尚的间隔为石头堆高度,接下来枚举即可。“每堆是相邻和尚的间隔 c[i] = a[i+1] - a[i] - 1,奇数位异或判必败,再枚举每一步转移回溯找必胜走法。
源笔记:博弈论
尾声
以上就是全部七章。回看这批笔记,2023 年 5 月的第一篇是"妖梦拼木棒”,2024 年 11 月的最后一篇算法笔记是 Medium Design——一年半的时间里,从"KMP 是什么"写到点分治和吉司机线段树,每一篇都是当时卡住又想通的地方。合集会把博客园的原文链接一直保留着,就当是给那段刷题日子的存档。
—— Sakura,2026 年 8 月
评论