AgentRx: Diagnosing AI Agent Failures from Execution Trajectories
AgentRx 智能体故障诊断与约束验证阅读笔记。
AgentRx 提出了一种新的归因框架,但总体来说,该框架还是分为标记错误、归因识别关键错误这两步。
AgentRx 将错误分类为 9 种($K_1$–$K_9$):指令/计划依从失败、意图–计划失配、捏造新信息/幻觉、无效工具调用、工具输出误读、用户意图说明不充分、意图不受支持、触发护栏、系统故障。
AgentRx 接收以下输入:(i) 包含输入–输出模式的工具集 $\mathcal{T}$,(ii) 可选的领域策略 $\Pi$,以及 (iii) 失败轨迹 $T=\langle s_{1},\dots,s_{n}\rangle$。每个步骤 $s_{k}$ 包含多个记录事件,带有智能体名称、工具名称、步骤索引、工具输出或自然语言对话内容等字段。
其中 AgentRx 将不同框架的日志统一为通用中间表示(IR),解析附录的日志后发现,AgentRx 针对不同的框架做了统一适配,换到新框架时仍需要调整日志适配器。
令 $T_{\leq k}$ 表示截至并包含步骤 $k$ 的轨迹前缀,AgentRx 根据工具 schema、领域策略和轨迹前缀生成可执行约束,逐步评估这些约束以生成可审计的验证日志 $V$。基于 LLM 的裁判结合 $V$ 和分类清单 $K$ 来预测根因步骤 $\hat{s}$ 和类别 $\hat{y}$。
首先 LLM 针对工具 schema 和可用的领域策略生成全局约束 $\mathcal{C}^{G}$,存入全局存储 $\mathsf{G}$。在每一步,根据任务指令 $I$ 和已观察前缀 $T_{\leq k}$、以 $\mathsf{G}$ 为上下文产生动态约束 $\mathcal{C}^{D}_{k}$,存于局部存储 $\mathsf{L}_k$。步骤 $k$ 的可用约束为 $\mathcal{C}_k:=\mathcal{C}^{G}\cup\mathcal{C}^{D}_k$。
守卫 $g_{C,k}=G_C(T_{\leq k},s_k)\in\{0,1\}$ 判断约束是否适用。为 0 时跳过,为 1 时执行断言 $\phi_{C,k}=\Phi_C(T_{\leq k},s_k)\in\{\text{sat},\text{viol}\}$。断言可以由程序检查,也可以由 LLM 判断。步骤 $k$ 的评估为:
跑完所有步骤后,我们只关心到底哪几步违反了哪条规矩,证据是什么。这就是验证日志 $V$ 的集合表达式:
LLM 裁判结合任务指令、轨迹、分类清单和验证日志,输出关键故障步骤与根因类别。
AgentRx 与适配版 W&W 的对比结果如下:
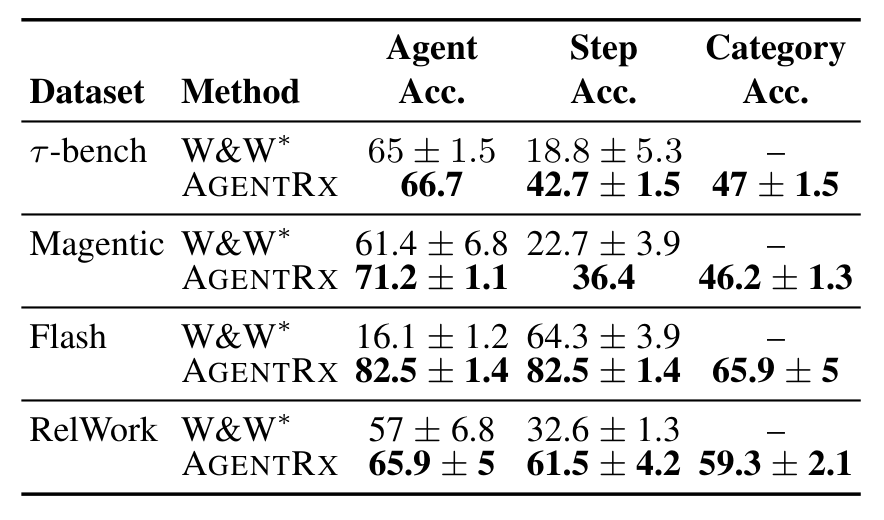
AgentRx 在各领域的步骤定位准确率都有提升,在多数设置中的责任智能体识别也有所改善。这里对比的是 W&W 的方法:论文将 AgentRx 基准中的轨迹转换为 W&W 所需的格式,并调整提示词,让 LLM 在日志中定位首个不可恢复的故障步骤。
评论